




ポイント: Logstashはオープンソースのデータ処理パイプラインで、さまざまなソースからデータを収集、変換、ルーティングしてElasticSearchなどの宛先に送信します。ELKスタックの不可欠な部分であり、堅牢なデータワークフローを提供します。
- 多様なデータ収集のための50以上の入力プラグインをサポートしています。
- データをデータベースやクラウドサービスなどのさまざまなプラットフォームに出力できます。
Logstashは、複数のソースからデータを取り込み、構成可能なフィルターを通じて変換し、下流のストレージまたは分析プラットフォームにルーティングする無料のオープンソースのサーバーサイドデータ処理パイプラインです。ELKスタックの取り込みエンジンとして、Logstashは堅牢なLogstashデータパイプラインワークフローを大規模に構築するために最も広く採用されているツールの1つです。このガイドでは、Logstashの機能、構成方法、および評価する価値のある主要な代替品について説明します。 データは現代のアプリケーションの核心的な部分であり、インフラやアプリケーショントラブルシューティングからユーザー行動パターンの分析、複雑な機械学習モデルの構築に至るまで、さまざまなユースケースを引き起こす触媒です。そのデータを多くのソースから信頼性を持って収集することこそがLogstashが構築された目的です。 ELKスタックは、アプリケーションおよびサーバーデータを分析するための主要なソリューションの1つです。これは、3つのオープンソース製品を組み合わせています:
- Elasticsearch
- Logstash
- Kibana
ElasticsearchはLuceneエンジンに基づいて構築されており、ELKスタックのストレージおよび分析のバックボーンです。Kibanaを使用すると、ElasticSearch上のデータをあらゆる形や形式で視覚化できます。Logstashは取り込みエンジンであり、スタックの出発点であり、複数のサービス、ファイル、およびログからデータを集約し、それをElasticSearchにプッシュしてさらなる分析を行います。
Logstashとは何ですか?
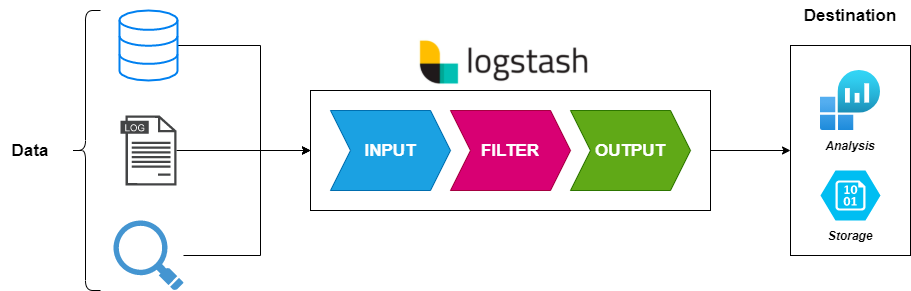
Logstashは、複数のソースからデータを取り込み、それを変換し、さらなる処理またはストレージに送信できる無料のオープンソースのサーバーサイドデータ処理パイプラインです。 LogstashはELKスタックの不可欠な部分ですが、Logstashはそのエコシステムに限定されません。LogstashはデータをElasticSearchだけでなく、Zabbix、Datadog、InfluxDB、MongoDBやRabbitMQ、Amazon SQSなどのメッセージブローカーにもプッシュできます。 Logstashは3つのコアセクション、入力、フィルター、および出力から構成されています。
Logstashデータパイプラインはどのようにデータを収集しますか?
Logstashの主な機能は、複数のソースからデータを収集し、集約する能力です。利用可能なプラグインは50を超え、Logstashは、ファイル、ビート、Syslog、stdin、UDP、TCP、HTTP、heartbeatなどの一般的な入力から、Azure Event Hub、Apache Kafka、AWS Kinesis、Salesforce、SQLiteなどの特定のサービスまで、さまざまなプラットフォームやサービスからデータを集めることができます。 入力はすべてのLogstash構成の出発点です。デフォルトでは、Logstashは入力が定義されていない場合、自動的にstdin入力を作成します。入力の適切な構成、分類、およびタグ付けは重要です。正確なタグ付けがないと、データはフィルターによって正しく処理されず、意図した出力先にルーティングされません。
Logstashはどのようにデータを変換し、フィルター処理しますか?
Logstashを他のほとんどのデータシッパーと区別するのは、着信データに対してフィルターを適用できる能力です。単なる集約器として機能するのではなく、Logstashは生のデータから情報を抽出し、それを構造化された意味のある形式に変換します。これは、下流に送信する前の中間ステップとして行われます。 この変換は、ElasticSearchなどのサービスの処理負荷を軽減し、下流の分析を改善する一貫した形式を提供します。Logstashは、単純なCSVプラグインから、非構造化データを名前付きフィールドに解析するgrok、urldecodeやその他の多くのフィルタープラグインを提供しています。
Logstashはデータをどこに出力しますか?
データが収集され、フィルター処理された後、Logstashはそれを幅広い宛先にルーティングできます。Logstashの出力には、ElasticSearch、フラットファイル、Amazon S3などのストレージサービス、SQSやKafkaなどのメッセージングサービス、AWS CloudWatchやGoogle BigQueryなどの分析プラットフォームが含まれます。 Logstashは単一の出力に限定されません。デフォルトでは、Logstashは設定されていない場合、stdout出力を作成しますが、Logstashは特定の入力を特定の出力にルーティングしながら、複数の宛先に同時にデータをプッシュするように設定できます。
Logstashをどのように構成し、インストールしますか?
LogstashはJava(JVM)が必要です。ほとんどのアーキテクチャ特有のインストールバンドルには、必要なJavaバージョンが含まれており、ユーザーが必要に応じてスワップできるようになっています。
Logstashのインストール
Logstashは、主要なオペレーティングシステムすべて(Windows、Linux、macOS)およびDockerイメージやKubernetesデプロイメント用のHelmチャートのインストールをサポートしています。 以下の例は、DockerベースのLogstashインストールを始める方法を示しています。Logstashのコンテナを作成することは比較的簡単なプロセスです。
    # Pull Image
docker pull docker.elastic.co/logstash/logstash:
# Create Container - Config Folder
docker run --rm -it -v ~/config/:/usr/share/logstash/config/ docker.elastic.co/logstash/logstash:
# Create Container - File Attached
docker run --rm -it -v ~/config/logstash.yml:/usr/share/logstash/config/logstash.yml docker.elastic.co/logstash/logstash:
Logstash構成の構造
Logstashの構成ファイルは、入力、フィルター、および出力セクションで構成されています。単一のLogstashインスタンスは、複数の構成ファイルを実行し、複数のサービスから収集し、異なる宛先にルーティングできます。構成ファイルは通常、/etc/logstash/conf.d/に.conf拡張子で保存されます。 以下の例は、フィルターなしでファイルから読み込み、別のファイルに出力するシンプルな構成を示しています: read-log.conf
    input {
file{
path => "/tmp/*.logs"
start_position => "beginning"
codec => json
}
}
output {
file {
path => "home/user/logstash_out.log"
}
}
より包括的な例として、以下の構成はNginxログをElasticSearchにプッシュします: nginx-logs.conf
    input {
file {
type => "nginx"
path => "/var/log/nginx/*"
exclude => "*.gz"
}
}
filter {
if [type] == "nginx" {
grok {
patterns_dir => "/etc/logstash/patterns"
match => { "message" => "%{NGINX_ACCESS}" }
remove_tag => ["_grokparsefailure"]
add_tag => ["nginx_access"]
}
geoip {
source => "clientip"
}
}
}
output {
elasticsearch {
hosts => ["www.test.host:9200"]
}
}
Logstashの最良の代替品は何ですか?
Logstashは強力で多用途ですが、その機能の深さは、いくつかの代替品に比べて学習曲線が高く、リソース要件も大きくなります。以下のオプションは、データ取り込みニーズの複雑さとスケールに応じてLogstashの代替品として機能します。
Filebeat
Filebeatは、Elasticスタックの作成者による軽量のログシッパーです。Filebeatは指定されたファイルやログからデータを収集することに特化しており、Logstashよりもリソースを大幅に少なくします。Filebeatは、シンプルなデータ取り込みに最適で、複合デプロイメントでLogstashの入力ソースとしても機能できます。トレードオフは機能性です: Filebeatの出力はLogstash、ElasticSearch、Kafka、Redisに制限されています。
Logagent
LogagentはSematextのオープンソースのクラウドネイティブなログシッパーで、Logstashと直接競合します。Logagentはフィルタリング、複数の入力タイプ(Syslog、ファイル、Azureイベント、Webhook、MySQL、MSSQLクエリ)をサポートし、ElasticSearch、Amazon ElasticSearch、Prometheusに出力します。LogagentはLogstashよりも学習曲線が穏やかですが、Logstashは全体的により成熟したプラットフォームであり、より広範な入力、フィルター、および出力サポートを提供します。
Fluentd
Fluentdは、統一されたロギングレイヤーを提供するために設計されたオープンソースのデータ収集ツールです。Fluentdの主な差別化要因は、可能な限りデータをJSONとして構造化するアプローチであり、これにより下流のサービスの処理が簡素化されます。CNCFプロジェクトであるFluentdは、500以上のプラットフォームやサービスと統合されます。Fluentdは構造化データシナリオに優れていますが、非構造化データを扱う際には正規表現ベースのフィルタリングやタグ付けなどの作業が必要であり、初心者にとっては急な学習曲線を提示します。
rsyslog
rsyslog(Rocket-fast System for Log Processing)は、高性能なログ処理に最適化されています。rsyslogはフルマルチスレッドを活用して、最新のハードウェアを効率的に使用し、パースルールがどれだけ多くても一貫したパフォーマンスを提供します。rsyslogは、詳細なSyslogメッセージフィルタリングとともに広範な入力および出力オプションをサポートしています。主な欠点は構成の複雑さです: rsyslogは、ここでリストされた代替品の中で最も設定が難しいですが、設定後は安定した体験を提供します。
Logstash: ユーザーフレンドリーで機能が豊富
Logstashは、利用可能なデータ収集および処理ツールの中で最も能力のあるものの1つです。ELKスタックのコア部分として、Logstashはデータを収集、集約、フィルタリング、ルーティングするための堅牢な処理パイプラインのために広く業界に採用されています。さまざまな入力からデータを取り込み、途中で変換し、複数の宛先に送信する必要があるチームには、Logstashは市場で最も強力なオプションの1つです。ストレージやさらなる分析にデータを送信する前に、さまざまな入力からデータを取り込むための最良のオプションの1つです。
よくある質問
Logstashは何に使用されますか? Logstashは、複数のソースからデータを収集し、構成可能なフィルターを使用して変換し、ElasticSearch、データベース、メッセージブローカー、クラウドストレージサービスなどの出力先にルーティングするためのオープンソースのデータ処理パイプラインです。Logstashは、ELKスタックの取り込み層として最も一般的に使用されます。 LogstashとFilebeatの違いは何ですか? Filebeatは、シンプルな収集と転送のために設計された軽量のログシッパーで、リソース使用量が最小限です。Logstashは、複雑なフィルタリング、変換、およびマルチ宛先出力をサポートする完全なデータ処理パイプラインです。Filebeatは、軽量な収集と強力な処理の両方が必要なELKの複合デプロイメントでLogstashの入力ソースとしてよく使用されます。 LogstashはElasticsearchを必要としますか? いいえ。LogstashはELKスタックの一部ですが、LogstashはElasticsearchを超えて多くの出力先にデータを出力できます - Kafka、RabbitMQ、Amazon SQS、MongoDB、InfluxDB、Datadog、Google BigQuery、フラットファイルなどが含まれます。Logstashは特定の出力プラットフォームに依存せずに機能します。 Logstashのgrokフィルターとは何ですか? Grokは、パターンマッチングを使用して非構造化ログデータを構造化された名前付きフィールドに解析するLogstashフィルタープラグインです。Grokは、Webサーバー、アプリケーション、システムログからの生のログ行をElasticSearchまたは他の出力にインデックスする前に処理するための最も広く使用されているLogstashフィルターの1つです。 Logstashを実行するためのシステム要件は何ですか? Logstashは実行するためにJava(JVM)が必要です。ほとんどのLogstashインストールバンドルには、ターゲットアーキテクチャ用の必要なJavaバージョンが含まれています。LogstashはFilebeatのような軽量な代替品よりもリソースを多く消費するため、特に複雑なフィルターパイプラインを実行する場合、プロダクションデプロイメントでは専用のCPUおよびメモリの割り当てから利益を得ることが一般的です。
関連情報
- BMC機械学習 & ビッグデータブログ
- BMC DevOpsブログ
- データアーキテクチャの説明: コンポーネント、基準、および変化するアーキテクチャ
- Elasticバージョン7クラスターの設定方法
- データ注釈とその機械学習における役割
- Docker上でKibanaとElasticSearchを使用してNGINXを監視する方法
この記事に表現された見解や意見は著者のものであり、必ずしもBMCの公式の立場を反映するものではありません。
ElasticSearchガイド
- 初心者のためのElasticSearchチュートリアル: ElasticSearchの基本
- ElasticSearchでApache Hiveを使用する
- ElasticSearchとApache Sparkを使用する
- Curl ElasticSearchコマンドチートシート
- Spark ElasticSearch Hadoopの更新とUpsertの例と説明
- Pythonを使用してApache SparkデータをElasticSearchに書き込む方法
- ElasticSearch検索構文とブールおよび集約検索
- ElasticSearchのネストされたクエリ: 埋め込まれたドキュメントを検索する方法
- ElasticSearchのジョイン: Has_Child、Has_parentクエリ
- Elasticバージョン7クラスターの設定方法
- nginxとElasticSearchのためのFilebeatの設定方法
- BeatsとLogstashを使用してElasticSearchにログを送信する
- Logstashを使用してCSVファイルをElasticSearchに読み込む方法
- ElasticSearchの集約について説明
- ELKスタックとは何ですか?
- Logstash 101: Logstashをデータ処理パイプラインで使用する
- Kibanaを使用してElasticSearchでLuceneおよびKibanaクエリ言語を実行する
- ElasticSearchの機械学習
- Elastic Enterprise Searchのインストール方法
- GitHubとElastic Enterprise Searchを使用する方法
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。