




ポイント: Apache HiveをElasticSearchとともに使用することで、ウェブサーバーログに対してSQLクエリを実行することによりデータ分析が強化されます。このガイドは、インストール、設定、およびデータロードプロセスの詳細を説明します。
- Hiveは、データ管理の改善のためにSQLクエリとユーザー定義関数を可能にします。
- ElasticSearchは、ログの保存とクエリに不可欠であり、サイバーセキュリティおよび運用監視のための重要な要素です。
ここでは、Apache HiveをElasticSearchで使用する方法を説明します。ApacheウェブサーバーログをElasticSearchにコピーし、その後Hive SQLを使用してクエリを実行します。
なぜこれをするのか?Hiveを使用すると、ユーザー定義関数を記述し、SQL(実際にはHQL)を使用でき、ElasticSearchのクエリ言語であるLucene Queryよりも簡単に作業でき、より多くの機能を提供します。たとえば、Hiveを使用するとデータセットを結合できます。また、Spark ML(機械学習)や他のツールを使用してHiveに対して高度な分析を実行できます。
以前にも指摘したように、いくつかのチュートリアルはHiveデータをElasticSearchに保存する方法を示すために書かれています。しかし、それは論理的ではありません。ESの全体的な目標は、ウェブサーバーやファイアウォールなどからログを収集し、それらを1つの場所(ES)に置き、クエリを実行できるようにすることです。これはサイバーセキュリティおよび運用監視のためのものです。
ElasticSearchは、ESドキュメントを読み書きできるelasticsearch-hadoopコネクタを提供しています。それを行うと、ESからHiveテーブルにデータが作成されます。HiveはESにデータを保存しません。
Hiveのインストール
まず、これらの手順を使用してHiveをインストールします。この後、MySQLが実行されます。実行されていない場合は、Unable to instantiate org.apache.hadoop.hive.ql.metadata.SessionHiveMetaStoreClientというエラーが表示されます。
そしてHadoopをインストールします。
次に、Hive-Hadoopコネクタをダウンロードし、$HIVE_HOME/libにコピーします。
cp /home/walker/Documents/jars/elasticsearch-hadoop-5.5.2.jar $HIVE_HOME/lib
start-dfs.shを使用してHadoopを開始します。クラスターで実行する場合は、Yarnも起動する必要があります。
Hiveを開始
次のようにHiveを開始します:
hive
また、デバッグモードで実行して、インストールのエラーを確認し、修正することもできます。たとえば、コネクタjarをlibフォルダーにコピーし忘れると、クラスが見つからないというエラーが発生します。
hive --hiveconf hive.root.logger=DEBUG,console
ここでstdoutを確認することもできます /tmp/(あなたのユーザーID)/hive.log
ElasticSearchをインストールし、データをロードする
ESのインストール方法の説明はこのデータの範囲を超えています。彼らの指示に従うことができますこちら。
サンプルデータをダウンロードしてアップロード
分析するためのデータが必要です。サンプルApacheログをこちらからダウンロードできます。
これを解凍するにはunrarをインストールする必要があります:
unrar x apache-access_log.rar
次に、こちらからこのApache logstash設定をコピーし、apache.confという名前を付けます。それをlogstashインストールのルートフォルダーに置きます。
    input {
file {
path => "/tmp/access_log"
start_position => "beginning"
}
}< filter {
if [path] =~ "access" {
mutate { replace => { "type" => "apache_access" } }
grok {
match => { "message" => "%{COMBINEDAPACHELOG}" }
}
}
date {
match => [ "timestamp" , "dd/MMM/yyyy:HH:mm:ss Z" ]
}
}
output {
elasticsearch {
hosts => ["localhost:9200"]
}
stdout { codec => rubydebug }
}
次に、その設定ファイルでlogstashを開始します。
bin/logstash -f apache.conf
次に、apache.confファイルに示された/tmp/access_logファイルパスにデータをコピーします。
cp access_log /tmp/
画面は、logstashが作業を開始するに従って、次のように出力をエコーし始めます:
    {
"path" => "/tmp/access_log",
"@timestamp" => 2017-09-21T12:16:33.346Z,
"@version" => "1",
"host" => "eurovps",
"message" => "d97082.upc-d.chello.nl - - [12/Mar/2004:13:25:45 -0800] \"GET /SpamAssassin.html HTTP/1.1\" 200 7368\r",
"type" => "apache_access",
"tags" => [
[0] "_grokparsefailure"
]
}
今、コマンドラインからESをクエリすると、新しいインデックスとドキュメントのカウントを見ることができるはずです:
    curl http://localhost:9200/_cat/indices?v
health status index      uuid      pri rep docs.count docs.deleted store.size pri.store.size
yellow open logstash-2017.09.21 DBRrjIlvQtG67ddb7qUnxw 5 1 1550
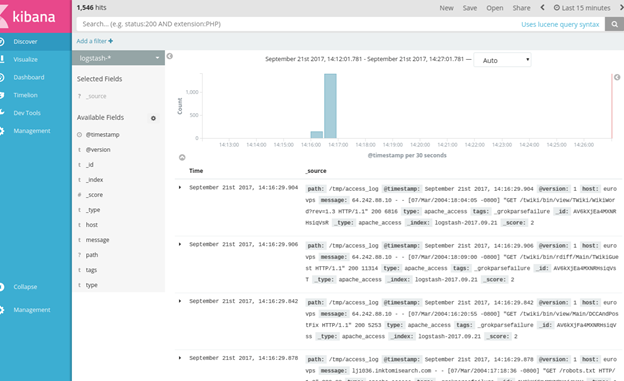
次に、Kibanaを開いて、そこでもデータを確認します。
次に、次のようにテーブルを作成してHiveにこのデータを読み込むように指示します:
    CREATE EXTERNAL TABLE apachelog (
path string,
timex timestamp,
Version int,
Host string,
Message string,
Index string
)
STORED BY 'org.elasticsearch.hadoop.hive.EsStorageHandler'
TBLPROPERTIES( 'es.nodes.wan.only' = 'true', 'es.resource' = 'logstash-2017.09.21', 'es.query' = '?q=*');
es.resourceはESインデックスです。
Es.nodes.wan.onlyは、ネットワーク接続の問題を解決します(つまり、Hiveがそれについて文句を言った場合)。
ホストはlocalhostにデフォルト設定されます。
ESはこれを作成します:
    describe apachelog;
OK
path          string          from deserializer
timex         timestamp       from deserializer
version       int             from deserializer
host          string          from deserializer
message       string          from deserializer
index         string          from deserializer
今、私たちはgrokを正しく設定していないため、Apacheのメッセージフィールドを解析しませんでした。しかし、次のようにIPアドレスを自分で取り出すことができます:
select regexp_extract(message, '^([0-9]{1,3}\\.){3}[0-9]{1,3}',0) as ip from apachelog;
今、どのIPアドレスがウェブサーバーに最も多くアクセスしているかを示すクエリを実行できます。これは2つのステップで行います:
- 中間テーブルiptabを作成します。
- テーブルiptabにクエリを実行します。
ここにカウントがあります:
create table iptab as select regexp_extract(message, '^([0-9]{1,3}\\.){3}[0-9]{1,3}',0) as ip from apachelog;
ここにカウントがあります:
    select count(ip) as c, ip from iptab group by ip order by c desc;
452        64.242.88.10
270         10.0.0.153
20                    207.195.59.160
14                    128.227.88.79
14                   212.92.37.62
13                    203.147.138.233
12                    195.246.13.119
7          145.253.208.9
7          142.27.64.35
4          194.151.73.43
4          61.165.64.6
4          80.58.14.235
4          208.247.148.12
3          67.131.107.5
3          61.9.4.61
3          80.58.33.42
2          200.160.249.68
1          80.58.35.111
1          66.213.206.2
1          64.246.94.152
1          64.246.94.141
1          4.37.97.186
1          219.95.17.51
1          216.139.185.45
1          213.181.81.4
1          200.222.33.33
1          195.230.181.122
1          195.11.231.210
1          12.22.207.235
1          212.21.228.26
ElasticSearchガイド
- 初心者向けElasticSearchチュートリアル: ElasticSearchの基本
- Apache HiveをElasticSearchと一緒に使用する
- Apache SparkとElasticSearchの使用
- Curl ElasticSearchコマンドチートシート
- Spark ElasticSearch Hadoopの更新とUpsertの例と説明
- Pythonを使用してApache SparkデータをElasticSearchに書き込む方法
- ElasticSearchの検索構文とブールおよび集約検索
- ElasticSearchのネストされたクエリ: 埋め込まれたドキュメントを検索する方法
- ElasticSearchの結合: Has_Child, Has_parentクエリ
- Elastic Version 7クラスタの設定方法
- nginxとElasticSearchのためのFilebeatの設定方法
- BeatsとLogstashを使用してElasticSearchにログを送信する
- Logstashを使用してCSVファイルをElasticSearchにロードする方法
- ElasticSearchの集約について
- ELKスタックとは何ですか?
- Logstash 101: データ処理パイプラインでのLogstashの使用
- Kibanaを使用してElasticSearchでLuceneとKibanaクエリ言語を実行する
- ElasticSearchの機械学習
- Elastic Enterprise Searchのインストール方法
- GitHubでElastic Enterprise Searchを使用する方法
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。