




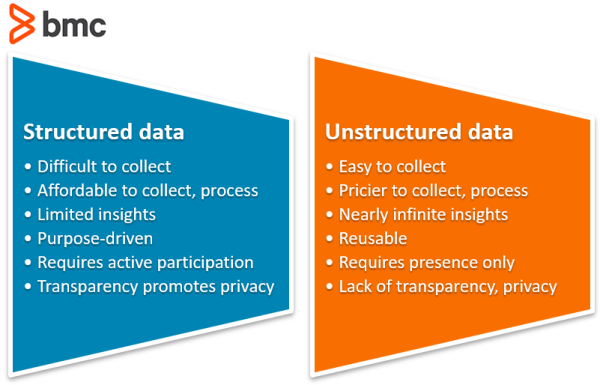
ポイント: 構造化データは整理されており透明性があり、プライバシー管理を強化しますが、非構造化データは広範で多面的であり、プライバシーの懸念を引き起こします。これらの違いを理解することは、効果的なデータ管理にとって重要です。
- 構造化データは明示的な収集方法を必要とし、明確な境界があります。
- 非構造化データは再利用可能であり、しばしばユーザーの同意の認識が欠けています。
データには多くの形態があります。データを見るときの最初のステップは、このデータは構造化されたものか非構造化されたものかを尋ねることです。この区別の別の方法は、このデータは質問に対する回答として到着したのか、それとも意図なしに収集されたのかということです。
構造化データとは何ですか?
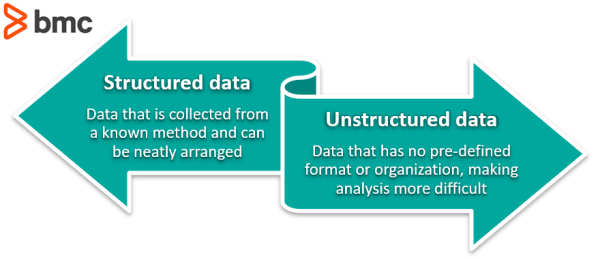
構造化データは整然と配置できるデータです。過去には、企業は構造化データを探求するためのツールとリソースしか持っていませんでした。非構造化データを分析することは不可能または非常に高価だったため、企業は構造化データに妥協せざるを得ませんでした。
構造化データの収集
構造化データを収集することは難しいです。性質上、収集できる構造化データの量には限りがあります。
アンケートは構造化データを収集する一般的な方法ですが、これには限界があります。どんなアンケートでも、注意を払う人が必要です。したがって、注意は限られているため、アンケートは適切な長さである必要があります。調査には10〜30のデータポイントしかありません。100のデータポイントからなる長い調査でさえ、非構造化データから抽出できる数千のデータポイントには及びません。
構造化データがアンケートを介して収集されない場合、データはタイプされるか、コーディングされて、構築されたシステムで人々がそれと対話します。一般的なタスクは、組織の会員やサブスクリプションの離脱率を予測することです。企業は次のようなデータを収集します:
- 個人が組織と対話する回数
- 個人が対話する時間
- メール情報
- 年齢
- その他...
構造化データは、カードをスワイプしたり、HTMLページを開いたりするたびに収集されます。他のユーザーとのインタラクションを監視することによって収集され、誰が誰と話しているかを報告します。このデータはシステムにコーディングされ、発生するたびに追跡されます。各構造化データは目的を持っています。
大量の構造化データは、多くの人々がデータを提出することによって収集され、実質的に分散ネットワークを使用してデータを収集します。このシナリオでは、1,000,000人が10の質問に回答して10,000,000のデータポイントを生成します。または、1,000,000人がCAPTCHAの歩道のいくつかの写真をタグ付けします。(ただし、この収集方法は非構造化データにも利用できます。同じ方法を非構造化データに使用できるため、1,000,000人が10ではなく数千のデータポイントを提供します。)
構造化データの限界を考えると、企業はスペースの経済問題を抱えていました。統計学者が雇われ、どの質問またはデータポイントが最も効果的かを判断しました。コンピュータの時代の初めに、データストレージは高価でした。いつでも、誰かに座ってアンケートに答えてもらうのはコストがかかります。統計学者は、どの質問が最も重要であるかを判断することによって、10の質問からなる調査の効果を最大化するために雇われました。彼らは、収入と教育のように、2つのデータポイントがどれほど関連しているかを判断する必要がありました。もし2つが似ているなら、両方の質問をすることは冗長であり、アンケートは1つを尋ね、もう1つを推測することでスペースを節約できました。
構造化データの透明性はプライバシーを提供します
構造化データを収集することは困難で時間がかかる場合がありますが、コミュニティにとっては利点があります。構造化データを収集するために人々が行わなければならなかった努力は、自然に両者の動機を透明にしました。双方の人々は、自分たちが求められている情報と、受信者が知る責任を持つ情報を理解できました。境界が設定されました。
構造化データの性質は、収集者が何を求めているかを見ることを可能にしました。アナリストが知りたいことの種類を見ることができます。
もしウォルマートが、ある人の結婚生活について、どれくらいの頻度で子供に腹を立てているか、家庭で子供をどのようにしつけているかに関する構造化調査を行っている場合、その人はその質問はウォルマートが知る責任ではない、または批判するものではないと判断することができます。その人はそのフォームを完成させないことを決定し、ウォルマートはそのデータを得ることはありませんでした。
これらの構造化フォーム内での2つの当事者の境界はより明示的です。
非構造化データとは何ですか?
ウォルマートの例を比較してください—調査に回答するかどうかの選択—このストーリーと。 ターゲットは有名に炎上しました10代の女の子の家庭に妊娠広告を送信したためです。父親は激怒し、ターゲットのマネージャーに無責任だと電話しましたが、娘が本当に妊娠していることを発見しました。
ターゲットは、非構造化データを組み合わせ、誰が何をいつ購入したかを把握し、自らの責任の枠を超えていました。企業はもはやこれを行っていないわけではありません—彼らは単により巧妙に学んでいます。
非構造化データは、事前に定義された形式や組織が欠如しているデータの任意のタイプです。考え方の良い方法は、構造化データは知られた方法や事例から収集され、非構造化データはそれ以外のすべてであるということです。非構造化データには以下が含まれます:
- 音声
- 動画
- テキストコンテンツ、構造化データ収集のためにしばしば書式設定されていない、テキストメッセージ、電子メール、ソーシャルメディア、ビジネス文書、ニュースなど
非構造化データの収集
非構造化データを解読する能力は、データ収集の新しい選択肢を提供します。データストレージは安価です。 機械学習モデルは情報を抽出するために作成できます。データ収集は明示的ではありません。企業は「話してください。後で必要な情報を取得します。」と言えます。生の音声、完全なビデオはデータソースとして使用できます。
特別に設計されたアンケートが必要なわけではありません。ユーザーの存在だけが必要です—ユーザーの注意はあまりにも高価で時間制限があります。非構造化データは、個人の即時の注意を必要としません。非構造化データは、ユーザーの存在によって純粋に収集できます。そして、ユーザーは自分が参加するときに何に同意しているのかを完全には理解していません。
彼らが今日提供する非構造化データは、将来的に全く異なる目的に使用される可能性があります。企業が一つのことを言い、別のことをするのは非常に簡単です。
非構造化データは再利用可能です
1つの非構造化データは、何度も何度も調べることができます。データを収集する人は、何を収集するかを事前に定義する必要はありません。これは、目的もなく音声ファイルをランダムに収集し、後で何に使用するかを考える怠惰なアナリストにとって素晴らしいことです。
非構造化データの出現は、ユーザーにとってプライバシーに関する懸念を引き起こします。データは複数の意図を満たすために使用される可能性があります。
iPhoneの顔検出器は、ユーザーの顔の3Dビジュアライゼーションを提供できます。入ってくる顔データは非構造化データです。その最初の実用的なユースケース—その明示された目的—は電話を安全にロックおよびロック解除することです。しかし、その同じデータは少し異なる方法で使用することができます。ユーザーがリアルタイムで笑顔やしかめっ面を表示するアバターを作成できるようにするために使用されます。
Appleは、非構造化データを別の方法で使用することもできます。彼らはその同じ顔データを取得し、広告主にその広告がユーザーによってどのように受け入れられているかを知らせるために販売することができます。それははるかに個人的なユースケースです。非構造化データを分析する能力は、データが複数のユースケースで使用されることを可能にしました。
非構造化データを精査する能力により、ジムはカードメンバーシップを使用して人をジムに入れるのを避け、顔認識ソフトウェアを使用することができます。彼らは非構造化動画データを収集します。入場時間と退場時間のデータだけでなく、ジムメンバーがいつ来ていつ去ったか、誰と来たか、何を着ていたか、到着時と出発時の気分、運動能力など、より多くの情報を収集できます。ジムメンバーは、「より良いサービスを提供する」ためにデータを収集することに同意したかもしれません。
2020年のデータ収集に関する新しい合意
非構造化データは複数のユースケースに使用できます。今日、誰かが同意する際には条件を追加する必要があります。彼らは「はい、あなたはこれを収集できます」と言うのではなく、「はい、あなたはこれを収集できます、そして私はあなたが特定のユースケースのために使用することを許可します。このデータを他の理由で使用することは、私たちの間の境界の違反です。」と言います。
ウォルマートとアマゾンは、消費者に低コストの商品を提供する責任があります。彼らは結婚カウンセラーである責任はありません。彼らが収集するすべてのデータに基づいて、結婚の状態についての教育的な発言をすることができるかもしれませんが、彼らがその主題について行うかもしれない発言は、彼らの責任を超えています。
かつて、Facebookの唯一の責任は、人々がネットワークを形成し、情報を共有することを許可することでした。しかし、2016年の米国大統領選挙の後、人々は刺されたと感じ、Facebookにユーザー間で共有されるコンテンツを良いか悪いかで評価する責任を与えました。Facebookは情報をフィルタリングする権限を与えられ、より良いか悪いかのために、Facebookはユーザーのプラットフォーム上の保護を試みるという名目で、非構造化データを好きなように読むことができます—月間アクティブユーザーは約26億人です(たった1つのプラットフォームで。WhatsAppやInstagramも所有しています)。これは、全世界の人口の約3分の1に相当し、どの政府よりも大きな管轄権です。
今、奇妙なことに、Facebookの手は実際に嘘をつくことを強いられています。彼らの義務は、ユーザーを保護するためにできる限り非構造化データを読み取ることです。しかし、ユーザーはFacebookに対して、彼らのメンタルヘルスや人間関係、誰が浮気をしているのかを知る責任はないと言うでしょう。したがって、目的を達成し、悪いまたは有害なコンテンツを監視し、ユーザーの最も直接的なプライバシーの懸念を満たすために、Facebookは個人情報を収集したり決定したりしていないと言わなければなりません。Facebookは、社会の上層部でジェーン・オースティンの小説の手がかりを取りながら、二面性の市民に成長しました。
その欺瞞が完全にFacebookのせいだと言うのは公平ではありません。誤りは、人々の願望の矛盾にもあります。彼らは、ケーキを食べるだけでなく、同時にそれを食べたいと願っています。Facebookは、すべてのユーザーの投稿を監視するために、望まない方法で非構造化データを読み取る必要があります。
人々は決断を下す必要があります。
- Facebookが彼らの生活に関するプライベートで個人的な情報を持っていることを知って不快に思うこと。
- Facebookが彼らを不快にさせないために嘘をついていることを知ること。
後者はプライバシーに対する脅威をもたらし、真の懸念を隠します。
データ収集のベストプラクティス
企業が収集するデータについて正直に話すことが最も重要です。これは不快である可能性があるため、各人がそのプライベート情報の価値をどれだけ評価しているかを話すことに焦点を移すべきです。そのため、Facebookのような企業は、その情報を保護することに非常に注意し、悪意のある行為者の手に渡らないようにする必要があります。
Facebookが不快な個人情報を収集し、それを安全に保つために多くの作業を行っていることを知る方が、嘘をつかれてデータ侵害を通じて初めて不快な情報が知られるよりも、はるかに良いです。プライバシーとセキュリティに圧力をかけ、無知に対してではありません。
世界のデータのほとんどは非構造化データの形であり、データには、データを提供する人とデータを収集する人との間で異なる種類のプライバシー契約が必要です。
追加リソース
このトピックについての詳細は、BMC機械学習およびビッグデータブログを閲覧するか、次の記事を始めてください:

これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。