




ポイント: 機械学習アーキテクチャは、CNNが画像分類に、RNNがシーケンスモデリングに特化して設計されています。このリソースでは、さまざまなアーキテクチャ、GANやクラスタリングアルゴリズムを含む、それらの使用ケースや機能について説明します。
- 異なるアーキテクチャは、機械学習において異なる目的に対応します。
- 一般的なアーキテクチャには、CNN、RNN、GANが含まれます。
- アプリケーションは、画像分類から異常検知まで多岐にわたります。
異なる機械学習のアーキテクチャは異なる目的に必要です。自動車は、仕事に行くためや、ロードトリップをするためのモーター車両であり、トラクターはプラウを引き、18輪トラックは多数の商品を運びます。
各機械学習モデルは異なる目的に使用されます。あるモデルは画像を分類するために使用され、別のモデルはシーケンスの次の項目を予測するのに適しており、また別のモデルはデータをグループに分けるのに優れています。複数の目的に適したものもあれば、特定の目的にのみ適したものもあります。
この記事では、最も一般的なMLアーキテクチャとその使用ケースを見ていきます。これには、以下が含まれます:
畳み込みニューラルネットワーク(CNNs)
しばしば使用される:
- 画像分類
- 物体検出
- レコメンダーシステム
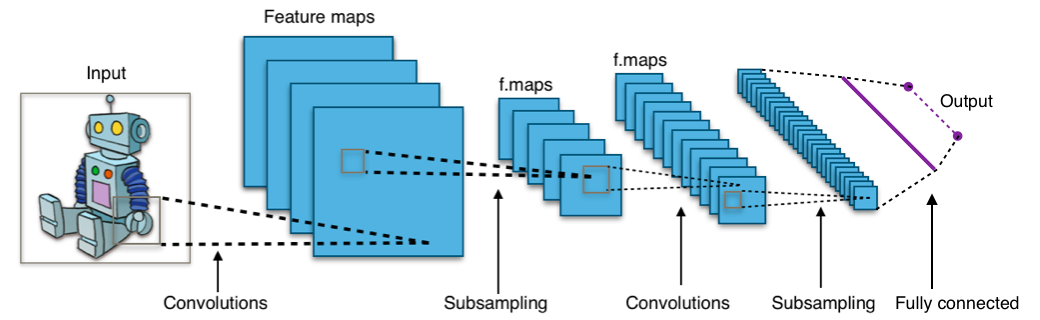
CNNの重要な要素は、その畳み込み層です。畳み込み層は入力と出力の間のフィルターです。これは、検出された特徴を要約する入力の特徴マップを作成します。畳み込み層は、画像を重要な特徴に分解し、それに基づいてラベルを予測することができます。
特徴マップを作成した後、次の層はプーリング層です。プーリング層は、データの次元を削減することによって計算を簡素化します。これを行うことで、次の層に進む前に1つの層の出力を組み合わせます。プーリングはローカルまたはグローバルに発生する可能性があります。違いは、プーリングが1つの畳み込みニューロンで発生するか、すべての畳み込みニューロンを通じて発生するかです。
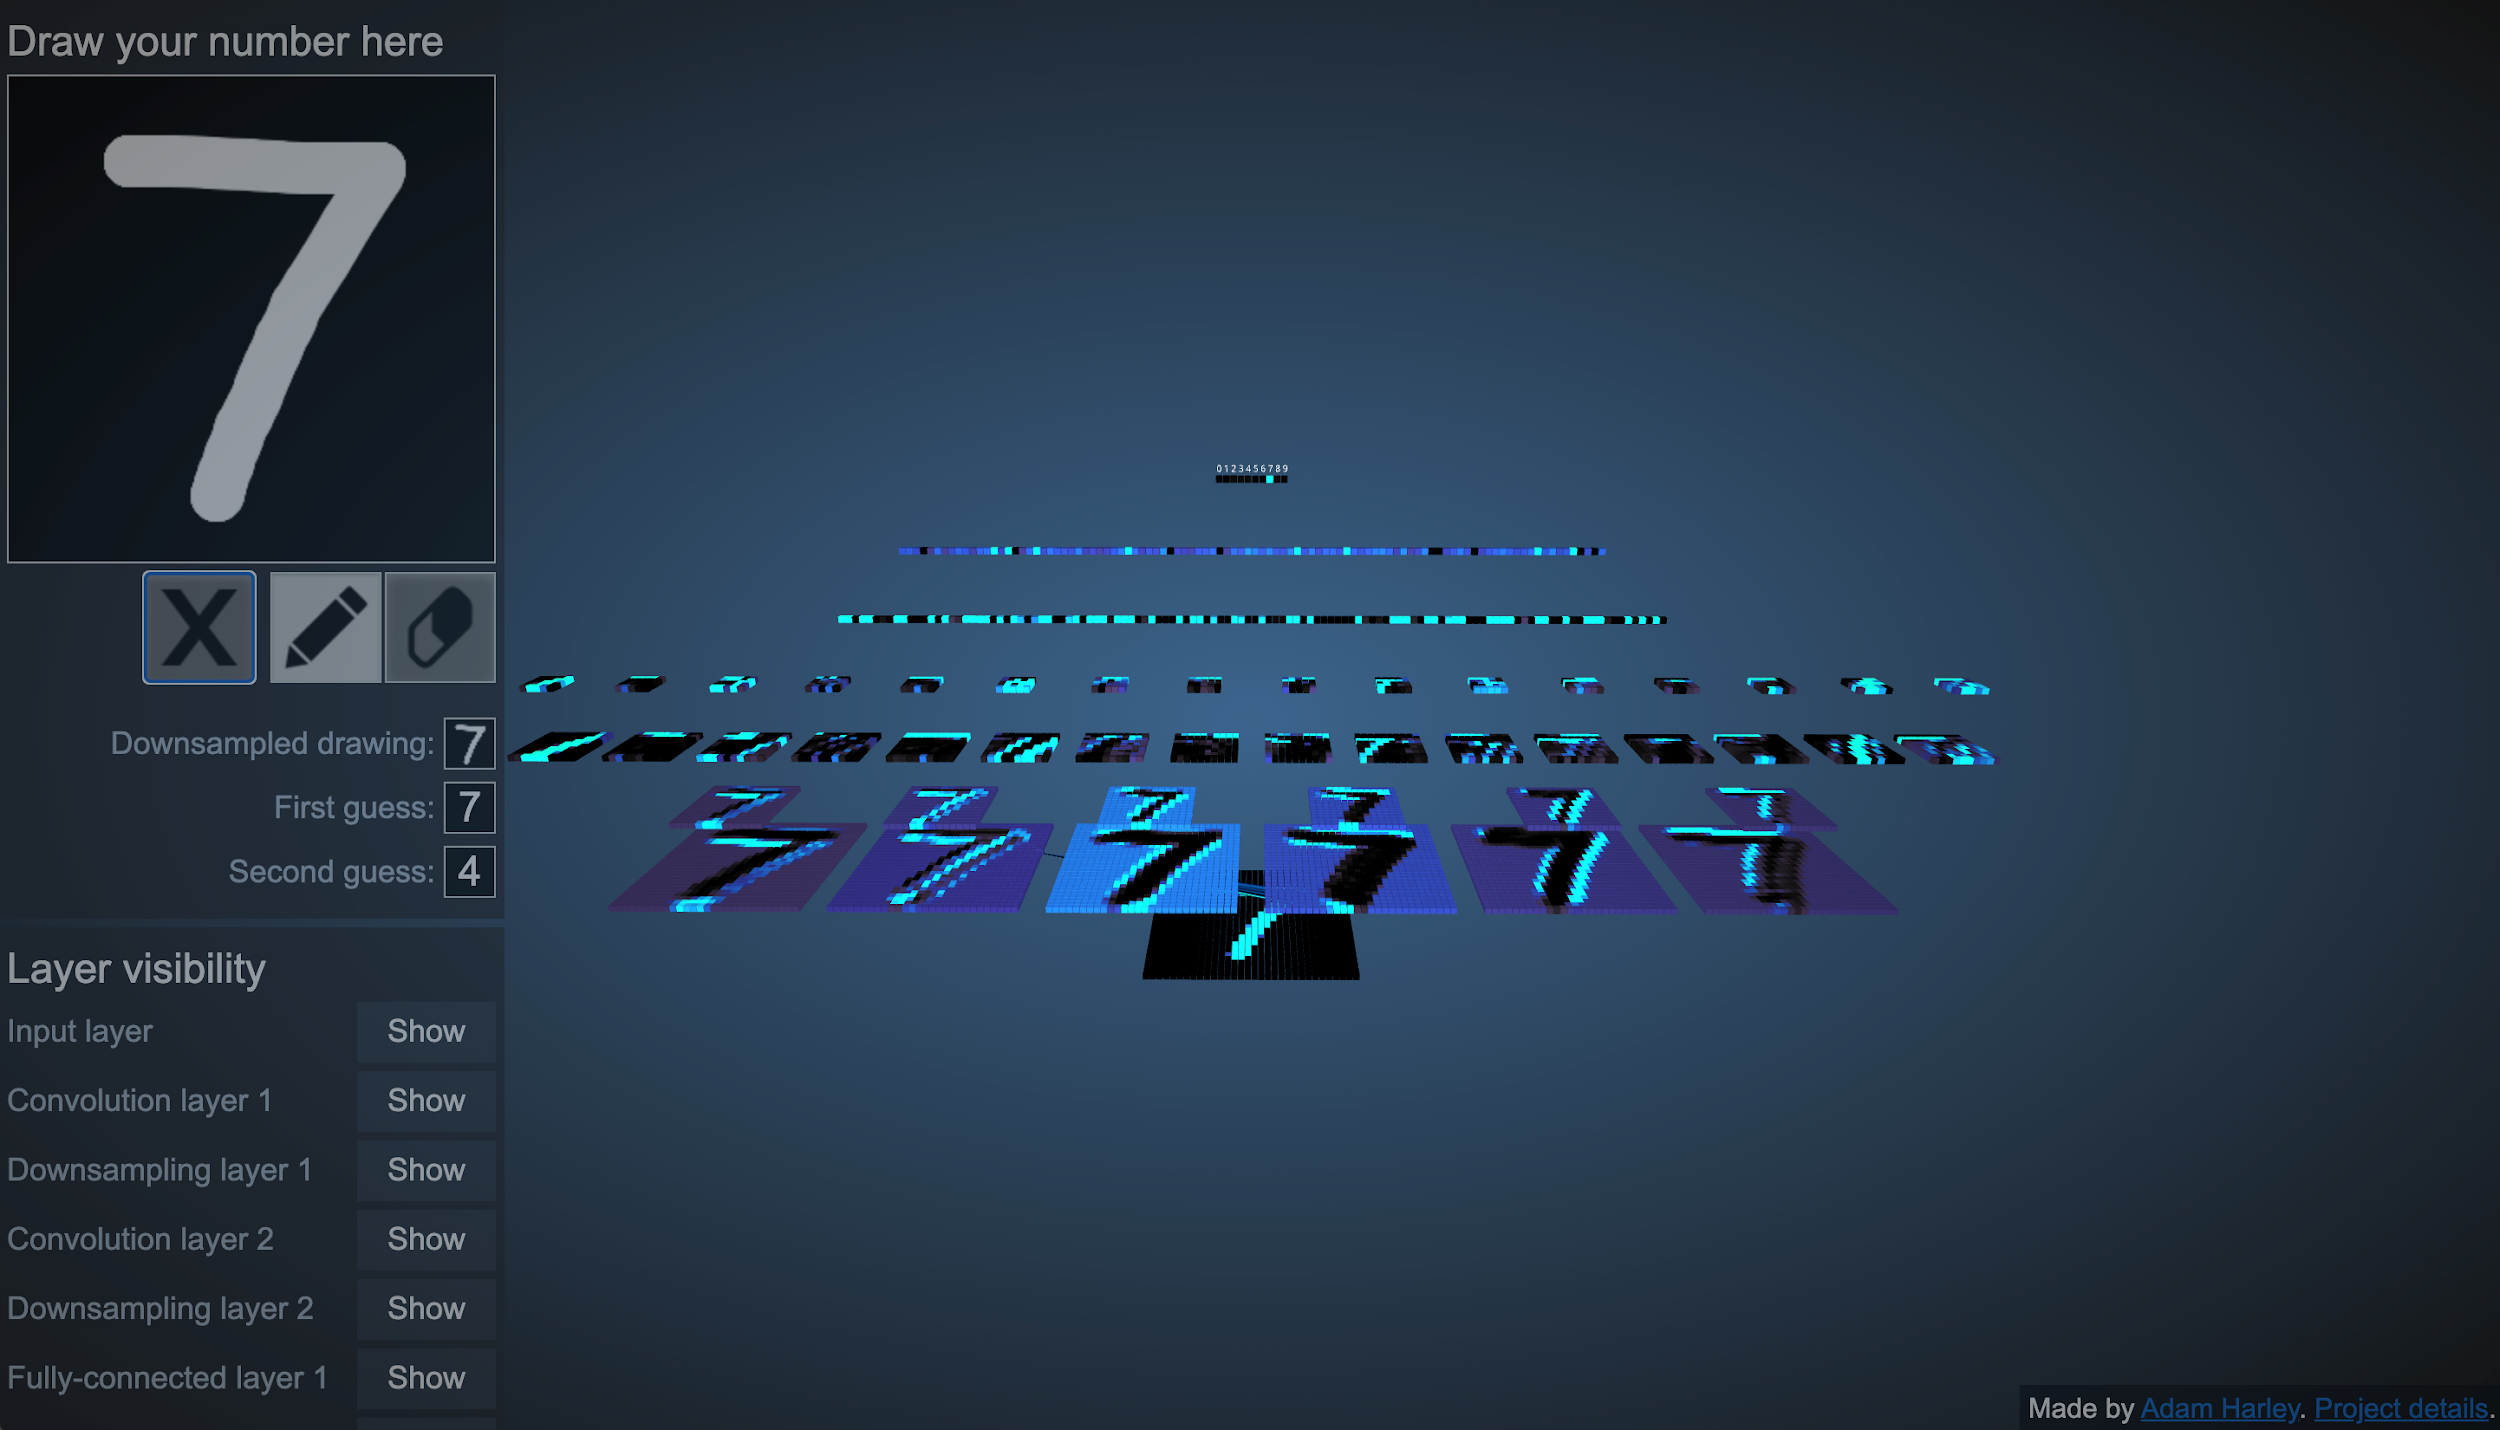
このインタラクティブな可視化では、上に示されているように、最初の層が入力層の6つの特徴マップ(スタックの底に見られる)であることがわかります。これらの6つの特徴マップはダウンサンプルされ、25x25の画像から14x14のサイズの画像に削減されますが、形状はそのまま保たれます。再び、これらの新しい画像から16の特徴マップで構成される特徴層が作成されます。

最後に、描画された画像の主要な特徴を見た後、CNNは入力を2つの全結合層を通過させ、ラベルが何であるべきかを予測します。
再帰的/再帰ニューラルネットワーク(RNNs)
使用される用途:
- シーケンスモデリング
- 次の単語の予測
- 音を単語に翻訳
- 人間の言語翻訳
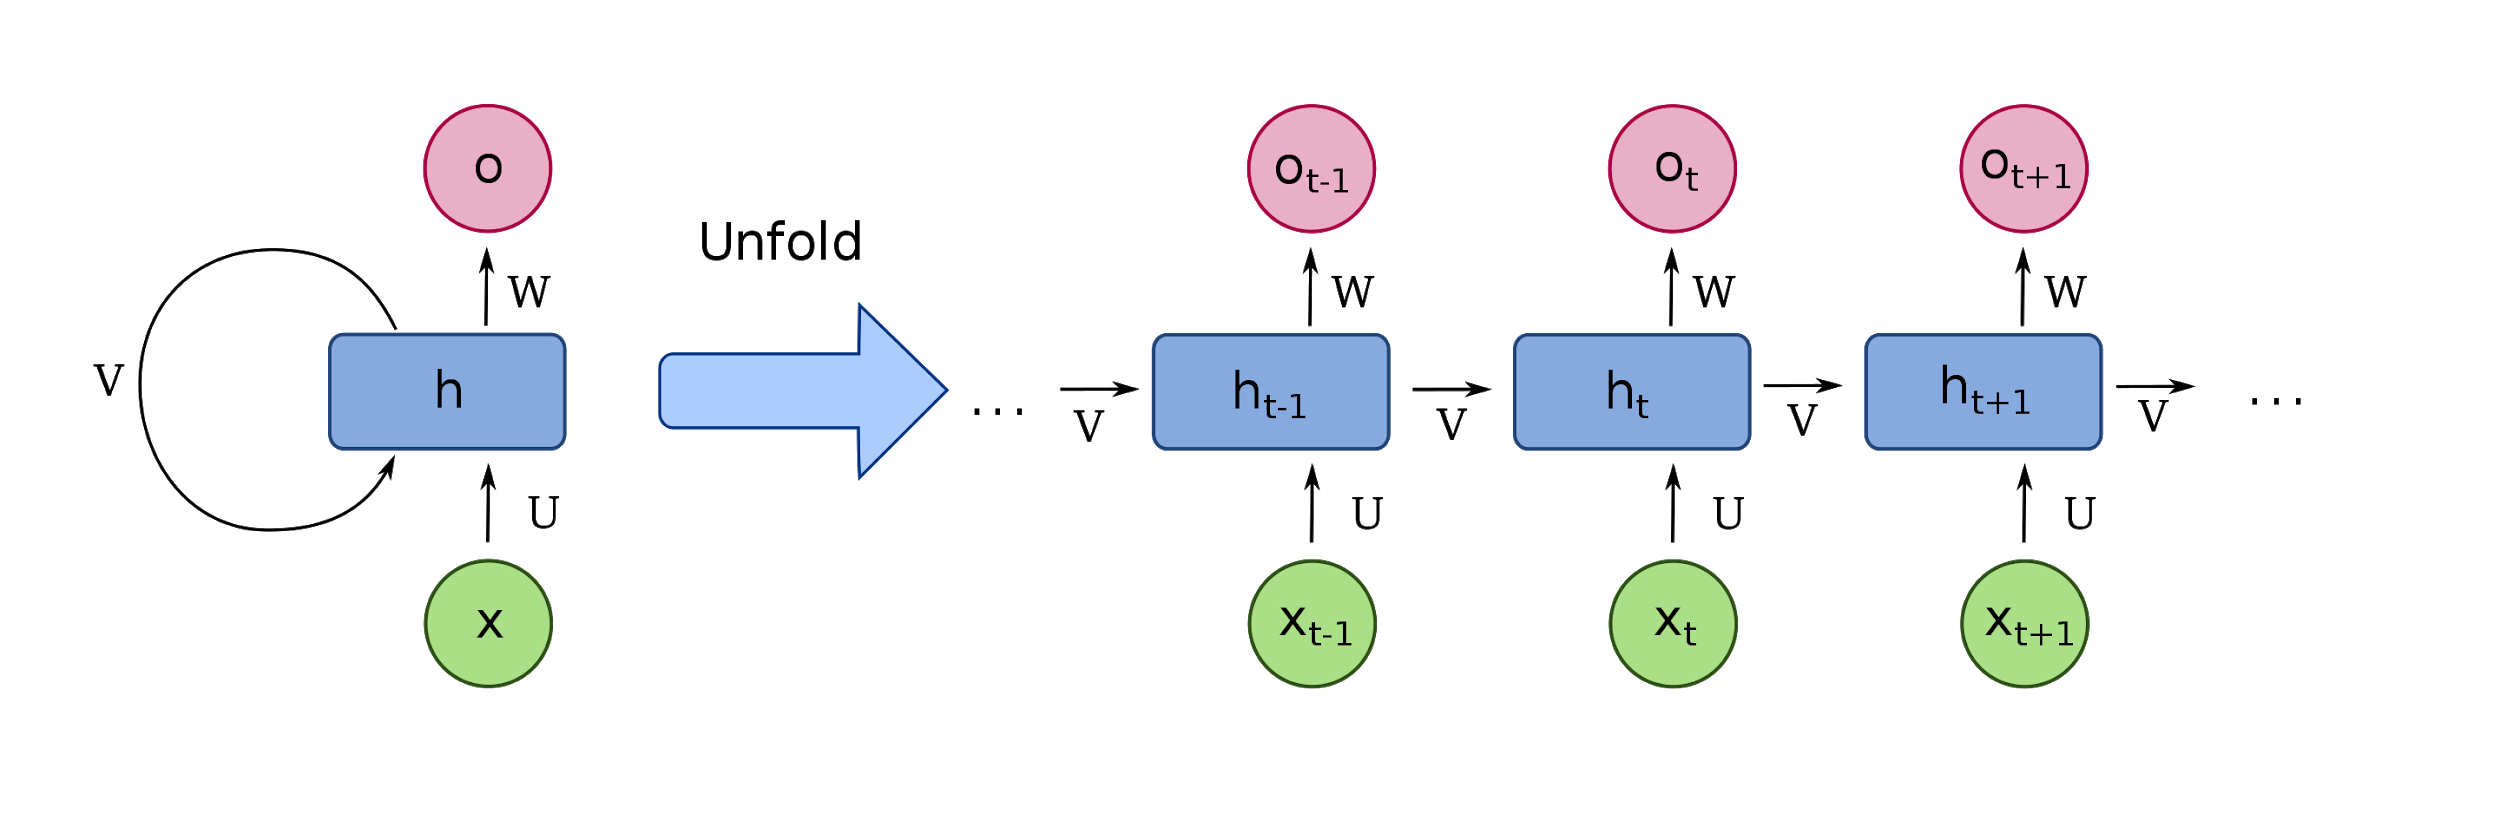
再帰的ニューラルネットワークは、さまざまなバリエーションを持つ基本的なアーキテクチャです。RNNは、入力がシーケンスで出力が別のシーケンスであるシーケンス対シーケンス問題を解決するために広く使用されます。これらの問題には通常、以下が含まれます:
- 言語翻訳(英語から中国語)
- 生成(シーケンスの次の項目を予測)
さまざまなバリエーションがあります。これらの中で、LSTMとTransformerは最も重要なものです。後者はOpenAI GPT-3の流行の原因となっています。LSTMとTransformerは、モデルにメモリを追加し制御する方法です。これらの動作は次のとおりです:RNNは、ノードのシーケンスであり、指向グラフとして表現できます。情報が各ノードを通過すると、ノードは次に何が来るかを予測することを学習します。
- LSTMは、従来のRNNに追加されたもので、RNNがそのメモリを制御し、最近発生したデータをより重要とし、過去に発生したデータを重要度の低いものとして定義できるようにします。
- Transformerは、RNNにメモリ制御をさらに追加し、過去の重要な距離をマッピングするだけでなく、過去の出来事の集団分布を作成し、その中で現在に最も重要なものを示します。
ソーティング/クラスタリングアーキテクチャ
使用される用途:
- 異常検知
- パターン認識
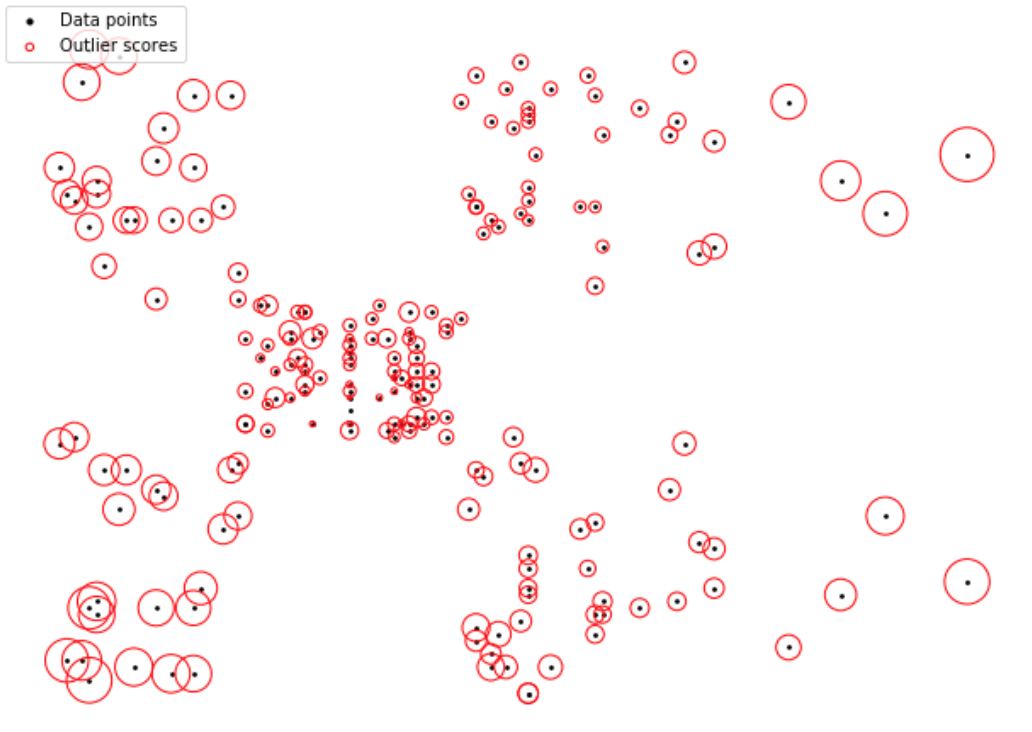
ソーティングとクラスタリングアルゴリズムは、集団の分布を調べ、データ内の未知の何かを発見するために使用されます。したがって、これらは教師なしモデリングシナリオや非構造化データで使用するのに適したモデルです。これらのモデルは以下のように使用できます:
- パターン認識を行い、集団をクラスに配置します。たとえば、カントリー、ロック、またはヒップホップが好きな人々のグループなどです。
- 異常を検出し、データセット内の外れ値を特定します。たとえば、これらのジャンルのいずれにも興味を示さない個人などです。
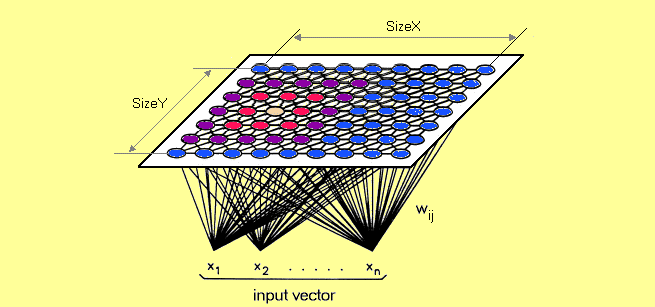
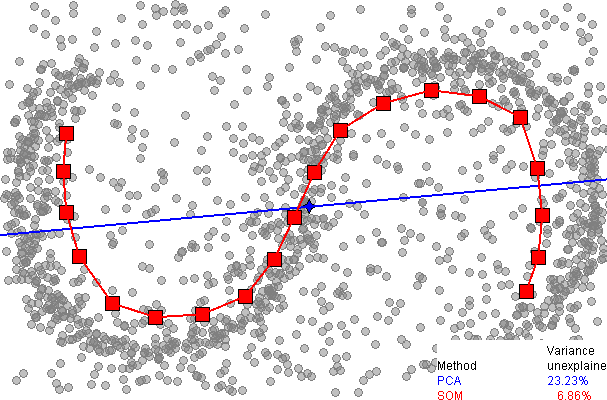
自己組織化マップは、RNNで一般的に使用されるツールです。SOMには、入力層と出力層の2層があります。自己組織化マップの出力層は特徴マップです。CNNの最初の層と非常に似ています:特徴マップが形成される方法はモデルによって大きく異なる場合があります。しかし、出力層は、データポイントを機械学習アーキテクチャ内で意味のあるものに変換するための重要なステップです。
データの出力は、以下のグラフィックに似ている可能性があります。
- 各青いノード(点)は、信用スコアが低い人々である可能性があります。
- 真ん中のカーキ色の点は、800以上の信用スコアを持つ人である可能性があります。
自己組織化マップは、もちろん事前にこれらの特徴を知っているわけではありません。マップを作成するとき、アルゴリズムはデータ入力を横並びに比較し、その後:
- 似ている場合、近くに配置します。
- 似ていない場合、2つを遠ざけます。
言語モデルは通常、無意味な単語を計算に使用できる特徴マップに変換するために類似のソーティング方法を使用します。
非構造化データで使用される人気のあるMLモデルは:
- 自己組織化マップ(SOM)
- K-means
- C-means
- 期待最大化メタアルゴリズム(EM)
- 適応共鳴理論(ART)
- 1クラスサポートベクターマシン
生成モデル
使用される用途:
- 異常検知
- パターン認識
- サイバーセキュリティ
- 自動運転車
- 強化学習
生成モデルは、サンプルと同じデータを生成することを目的としたMLモデルの一種です。これらは、ある例がどれほど可能性があるかを示すために使用されます。これらは、セレブに似た顔を作成することができます。サイバーセキュリティでは、画像がディープフェイクである可能性や、IPアドレスが攻撃者である可能性を示すために使用されます。GANは、フェイクを見つけることができます。
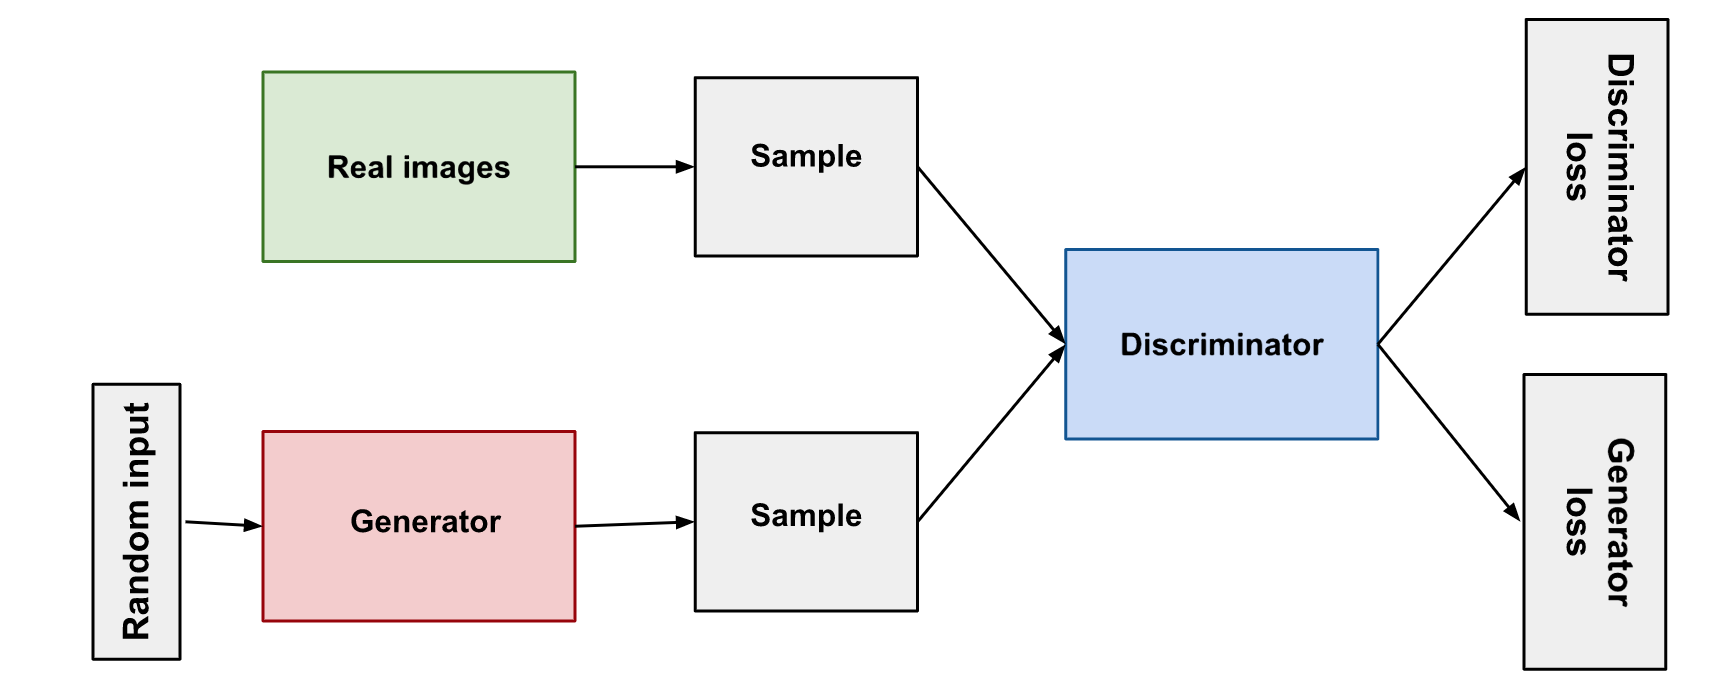
このアーキテクチャでは、MLモデルはランダムなデータの一部を生成し、それをリアルなデータの一部とテストします:
- 識別器がそれを本物として通過させると、それは機能します。そうでない場合は、戻って再試行します。
- 偽のデータポイントが通過する場合、識別器はその仕事が上手になります。そして、生成された偽データセットで更新されます。
生成器と識別器は、お互いを上回ろうとするゲームをプレイします。
シミュレーションゲームの場合、生成器はエッジ・オブ・トゥモローのトム・クルーズのように、生成(世代)をし、戦争に勝つために最後まで行こうとします。または、マトリックスのネオのように、常に偽のデータポイントである生成されたデータポイントが、偉大なる創造主の元にたどり着き、そこに達したときにシステムが壊れ、再起動しなければならなくなります。
人気のある生成的MLモデルは:
- 生成対抗ネットワーク(GANs)
- ボルツマンマシン
- 隠れマルコフモデル
- 変分オートエンコーダ
機械学習モデルとアーキテクチャ
モデルとアーキテクチャは同じではありません。機械学習アーキテクチャは大きな部分であることを忘れないでください。問題を解決するための全体的なアプローチとして考えてください。アーキテクチャは、動作パラメータを提供します。これには、ニューラルネットワークの層の数、サイズ、タイプなどが含まれます。
モデルはアーキテクチャの一部であり、選択したデータセットに基づいてトレーニングされる特定のインスタンスです。たとえば、ニューラルネットでは、各ノードのトレーニングされた重みがアーキテクチャに従ってモデルを構成します。
追加のリソース
このトピックについて詳しく知るには、これらのリソースを探ってください:
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を表すものではありません。