




ポイント: Hadoopは、主要なデータ分析フレームワークであり、Kubernetesやクラウドネイティブ技術と競争しています。大規模データセットの処理には優れていますが、小規模データセットには苦労し、リアルタイム分析が不足しています。この記事では、Hadoopの強み、弱み、および進化する技術ランドスケープにおけるその関連性について説明します。
- Hadoopは大規模データセットを効果的に処理しますが、小規模データセットには非効率的です。
- Kubernetesはデータワークロードのための高度なオーケストレーションと柔軟性を提供します。
Apache Hadoopは、分散データ分析およびデータストレージのための主要なソリューションの1つです。しかし、データ分析や一般的なコンピューティングニーズに直接対応する他の分散コンピューティングソリューションの登場により、Hadoopの有用性が疑問視されています。
インターネット上では多くの議論があります: Hadoopはまだ関連性がありますか?それとも、完全に死んでしまったのか?
実際、Apache Hadoopは死んでおらず、多くの組織が依然として堅牢なデータ分析ソリューションとして使用しています。1つの重要な指標は、すべての主要なクラウドプロバイダーがそれぞれのプラットフォームでApache Hadoopクラスタを積極的にサポートしていることです。
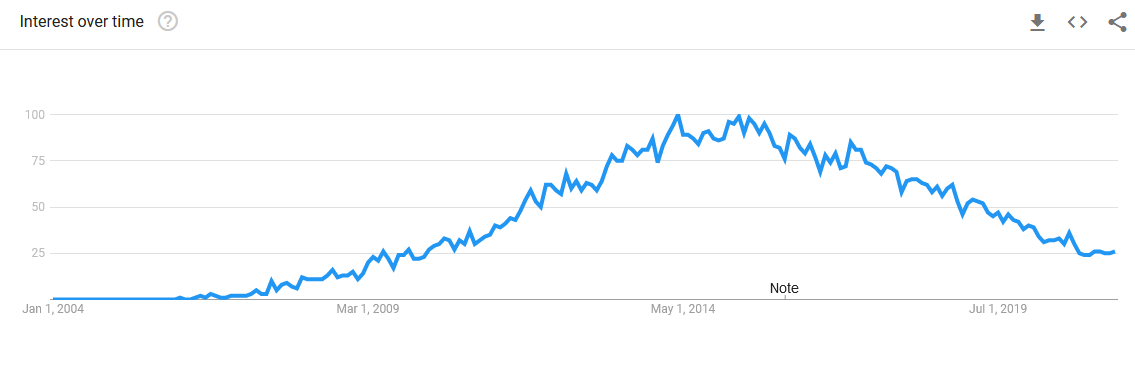
Google Trendsは、Hadoopへの関心が2014年から2017年にかけてそのピークの人気に達したことを示しています。その後、Hadoopの検索が明確に減少しています。しかし、これだけでは現在のHadoopの使用状況を測る良い指標ではありません。結局のところ、Hadoopは他のプラットフォームに統合して完全な分析ソリューションを形成できます。
この記事では、Hadoop、其の有用性、そしてKubernetesやCloud-Native開発のように急速に進化する技術によって置き換えられるかどうかについて詳しく学びます。
Hadoopとは何か?
Hadoopは、大規模なデータセットを効率的に保存および処理するために使用されるオープンソースのフレームワークです。信頼性が高く、スケーラブルな分散コンピューティングプラットフォームであり、コモディティハードウェア上で使用できます。
Hadoopは、そのデータストレージと分析の負荷を複数のノード(コンピュータ)に分散させて並列に作業を処理します。これにより、より速く、効率的で、低コストのデータ分析機能が得られます。
Hadoopモジュール
Hadoopは、その機能を支える4つの主要なモジュールから構成されています:
- HDFS. Hadoop分散ファイルシステムは、低性能のハードウェア上で動作しながら、従来のファイルシステムよりも優れたスループットを提供するファイルシステムです。さらに、内蔵のフォールトトレランスと大規模なデータセットを処理する能力を持っています。
- YARN. “Yet Another Resource Negotiator”は、タスク管理、ジョブのスケジューリング、およびクラスタのリソース管理に使用されます。
- MapReduce. MapReduceは、大規模なデータセットの並列計算をサポートするビッグデータ処理エンジンです。これはHadoopで利用可能なデフォルトの処理エンジンです。現在、HadoopはApache TezやApache Sparkなどの他のエンジンもサポートしています。
- Hadoop Common. Hadoop Commonは、他のすべてのHadoopモジュールで使用できる共通のライブラリセットを提供します。
Hadoopの利点
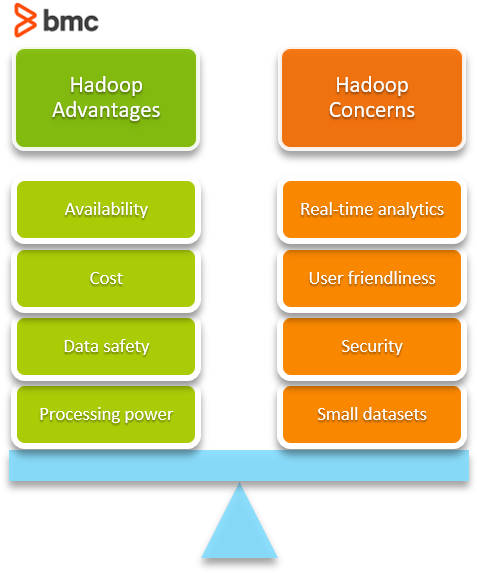
では、Apache Hadoopの人気の背後にあるいくつかの主な理由を見てみましょう。
- 処理能力。 Hadoopの分散コンピューティングモデルは、無限の同時タスクを処理できることを可能にします。
- データの安全性。 Hadoopは自動的にデータのバックアップを作成および管理します。したがって、障害が発生した場合は、バックアップからデータを簡単に復元できます。
- コスト。 Hadoopはコモディティハードウェア上で動作することができ、組織がデータ分析プラットフォームを簡単に展開できるようにします。また、高価で専門的なハードウェアが必要なくなります。
- 可用性。 Hadoopはアプリケーション層での障害処理に設計されており、ハードウェアに依存せずに高可用性を提供します。
柔軟性とスケーラビリティを持つHadoopは、個々のデータエンジニア/アナリストと企業の両方に迅速に支持されました。この柔軟性は、Hadoopが収集できるデータの種類にも及びます:
- 構造化データと非構造化データ
- ソーシャルメディアやストリーミングデータ、内部コレクションなど、さまざまな入力を通じて。
その後、Hadoopはすべてのデータセットを確認し、それぞれのデータセットの有用性を判断します。これらすべては、単一の形式にデータを変換するプロセスを経ることなく行われます。
Hadoopを高めるもう1つの特徴は、そのストレージ能力です。
大量のデータセットが蓄積され、必要なデータが抽出されると、未処理のデータをHadoopに無限に保存できます。これにより、ユーザーは古いデータを簡単に参照でき、ストレージコストも最小限に抑えられます。Hadoopはコモディティハードウェアで動作するためです。
Apache Spark
Hadoopの欠点
Apache Hadoopクラスタは、上記のすべての機能のおかげで注目を集めました。
しかし、技術が進化するにつれて、新しいオプションが登場し、Hadoopに挑戦し、特定の側面でそれを上回ることさえあります。これにより、Hadoopの固有の制限も相まって、実際に市場でのリーダーシップを失ったのです。
では、Hadoopの欠点は何でしょうか?
小規模データセットに対して非効率的
Hadoopは、大規模データセットで構成されるビッグデータの処理を目的としています。小規模データセットを処理する際には非常に非効率的です。小規模データセットを迅速に分析する際には不向きで、コストも高くなります。
もう一つの理由: Hadoopはデータを結合、処理、変換することができますが、必要なデータを出力する簡単な方法を提供していません。これにより、ビジネスインテリジェンスチームが処理されたデータセットを視覚化し、報告するための選択肢が制限されます。
セキュリティの懸念
Hadoopはデフォルトで緩いセキュリティ強制を含んでおり、ストレージやネットワークレベルでの暗号化を実装していません。Hadoopが正式にサポートするのはKerberos認証のみであり、これは維持が難しい技術です。
各Hadoop構成では、ユーザーは手動でセキュリティオプションを有効にする必要があるか、サードパーティツールを使用して安全なクラスタを設定する必要があります。
ユーザーフレンドリーではない
Hadoopは、広範な開発者ベースを持つ主要なプログラミング言語の1つであるJavaを使用して開発されています。しかし、Javaはデータ分析に最適な言語ではなく、新しいユーザーにとっては複雑です。
これにより、設定や使用において複雑さが生じる可能性があり、ユーザーはJavaとHadoopの両方を十分に理解している必要があります。そうでなければ、クラスタを適切に使用し、デバッグすることはできません。
リアルタイム分析には不向き
Hadoopは、優れたバッチ処理をサポートするように設計されています。しかし、小規模データセットの処理に制限があり、リアルタイム分析をネイティブにサポートしないため、Hadoopは迅速なリアルタイム分析には不向きです。
Hadoopの代替
では、Hadoopの代替としてどのようなオプションがありますか?Hadoopを完全に置き換える単一のソリューションはありませんが、Hadoopの必要性を減らしたり排除したりできる新しい技術があります。
Apache Sparkは、Hadoopのデフォルトのデータ処理エンジンであるMapReduceを置き換えるために、Apacheチーム自ら提供するソリューションの1つです。Sparkは、MapReduceの制限に対処するために開発された新しいデータ処理エンジンです。
Apacheは、SparkがMapReduceよりもほぼ100倍速いと主張し、インメモリ計算をサポートしています。さらに、マイクロバッチのデータを生成し、それを処理することでリアルタイム処理をサポートします。
Sparkは現代言語のサポートを提供しているため、好みのプログラミング言語を使用して対話できます。Sparkは、次のような言語でのデータ分析に優れたサポートを提供します:
- Scala
- Python
- Spark SQL
(私たちのApache Sparkガイドを探検してみてください。)
Apache Flink
もう1つの利用可能なソリューションはApache Flinkです。Flinkは、Sparkと同様の利点を持つ別の処理エンジンです。Flinkは、境界のあるおよび境界のないデータストリームを対象とした状態を持つ計算を処理するように設計されており、一部のワークロードでさらに高いパフォーマンスを提供します。
KubernetesとクラウドネイティブはHadoopを置き換えるのか?
新しいデータ処理エンジンがあっても、HadoopはユーザーをHDFSやYARNなどのツールや技術に制限しています。しかし、特定のデータストレージと分析ニーズに最適なツールやプラットフォームを統合する必要がある場合はどうでしょうか?
解決策は、クラスタを管理するオーケストレーションエンジンとしてKubernetesを使用することです。
コンテナ化されたクラウドネイティブアプリケーションの人気が高まる中で、Kubernetesは任意のコンテナ化されたアプリケーションを管理するための主要なオーケストレーションプラットフォームになりました。次のような機能を提供します:
- 便利な管理
- ネットワーキング
- スケーリング
- 高可用性
(私たちの包括的Kubernetesガイドを探検してみてください。)
次のシナリオを考えてみてください: 安価なクラウドストレージオプションに移行したいのですが、Amazon S3バケットや、Amazon Redshift、Google BigQuery、Panoplyなどの管理データウェアハウスが必要です。これはHadoopでは不可能です。
一方、Kubernetesは、これらをKubernetesクラスタに簡単に接続でき、コンテナからアクセスできるようにします。同様に、Kubernetesクラスタは、クラウドプロバイダーがデータの日常的なメンテナンスと可用性を管理するため、メンテナンスの責任が軽減され、無限のストレージを持っています。
ストレージが確保されると、Kubernetesは次のようなさまざまなサービスをホストできます:
- ビッグデータ分析ツール(Apache Spark、Presto、Flink)
- データサイエンスツール(BigML、Jupyter、NLTK、TensorFlow、PyTorch、MATLAB)
- Kubernetesクラスタ内の任意の他のツール
これにより、ユーザーはすでに慣れているツール、フレームワーク、またはプログラミング言語を自由に使用できるようになり、ユースケースに最も適したものを選択できるようになります。もはやJavaに制限されることはありません。
(どのようにコンテナとK8sが連携するかを正確に確認してください。)
Kubernetesのポータビリティ
Kubernetesを高めるもう1つの要因は、そのポータビリティです。Kubernetesは、さまざまな場所に分散させ、多くのクラウド環境で実行するように簡単に構成できます。コンテナ化されたアプリケーションを使用すると、ユーザーは開発環境と本番環境の間で簡単に移動でき、データ分析を行うために大規模な変更を行うことなく任意の場所で行うことができます。
Kubernetesを迅速なDevOpsやCI/CDパイプラインと組み合わせることで、開発者はデータ分析、機械学習、AIアプリケーションをほぼどこでも簡単に作成、テスト、および展開できます。
Kubernetesのサーバーレスコンピューティングのサポート
Kubernetesは、サーバーレスコンピューティングのサポートにより、インフラストラクチャを別々に管理する必要をさらに排除しました。サーバーレスコンピューティングは、クラウドプラットフォームがアプリケーションのニーズに応じて自動的にハードウェアリソースを管理し、スケールする新しい技術です。
fn、Apache OpenWhisk、およびnuclioなどのコンテナネイティブなオープンソースの関数としてのサービスコンピューティングプラットフォームは、サーバーレスアプリケーションを実行するためにKubernetesと簡単に統合でき、Hadoopのような技術の必要性を排除します。
nuclioのような一部のフレームワークは、サーバーレス関数を使用してデータサイエンスパイプラインを自動化することを目的としています。
以上の利点を考慮すると、Kubernetesは大規模データワークロードを管理するための完璧な選択肢になりつつあります。
Hadoopは大規模データセットを安価に処理する
他の技術と同様に、Hadoopも特定のニーズ、すなわちコモディティハードウェアを使用して大規模なデータセットを効率的に処理するために設計されています。
しかし、進化する技術トレンドは新しい要件やユースケースを生み出しています。Hadoopは死んでいませんが、Kubernetesやサーバーレスコンピューティングのような他の技術は、より柔軟で効率的なオプションを提供しています。
したがって、すべての技術と同様に、必要に応じて正しい技術スタックを特定し、活用するのはあなた次第です。
関連読み物
Hadoopガイド
- 初心者のためのHadoopチュートリアル: Hadoopの基本
- Hadoop管理の紹介
- Hadoopセキュリティの紹介
- Apache Flumeの紹介
- Hiveの紹介
- HDFSの紹介
- Hbaseの紹介
- Hadoopの例: 5つの実世界での使用事例
- Hadoopキャリア: 雇用されるために
- Hadoop面接質問
- Hadoop分析の紹介
- Apache Pigの紹介
- Apache Yarnの紹介
- Hadoopアーキテクチャの紹介
- Hadoopの利点と利点
- Apache CassandraとのHadoopの使用
- Hadoop vs Kubernetes: K8sとCloud NativeはHadoopを終わらせるのか?
- Hadoop認定
- Hadoopクラスタの紹介
- Hadoopエコシステムとコンポーネント
これらの投稿は私自身の意見であり、BMCの立場、戦略、または見解を必ずしも表すものではありません。