




ポイント: Hadoopは分散ファイルシステムおよびバッチ処理フレームワークであり、効率的なデータ管理のためにマスタースレーブアーキテクチャを利用しています。主要なコンポーネントには、耐障害性とデータ処理機能を可能にするNamenode、Datanode、およびJobTrackerが含まれます。
- Hadoopはデータ処理にMapReduceを使用します。
- さまざまなストレージ形式をサポートし、Apache SparkやHiveなどのツールと統合しています。
概要
Hadoopは、MapReduceジョブを実行するための分散ファイルシステムおよびバッチ処理システムです。つまり、データをネットワーク上のコモディティマシンのローカルストレージに保存するように設計されています。MapReduceは実際には2つのプログラムです。Mapは、csvファイルから文字列のような項目を取り出し、ファイル内の各行で操作を実行します。これにより、(key->value)ペアが作成されます。Reduceは、これらの(key->value)ペアをグループ化し、例えば、1つの文字列に連結したり、(key->sum)のように合計を計算したりします。
Reduceは、結合可能な任意の操作で機能することができます。それは数学の原則a + b = b + aです。そして、これは数字だけでなく、任意のプログラミングオブジェクトが加算、乗算、減算メソッドを実装できることを意味します。(除算は結合可能ではありません、なぜなら1 /2 <> 2 /1だからです)。結合可能性は、Hadoopがそれらを別々のチャンクに分割して処理するため、並列処理システムの要件です。
Hadoopは、障害に対して耐障害性を持つように設計されています。データを何回レプリケーションするかを指定します。すると、データノードがクラッシュしてもデータは失われません。
Hadoopはマスター・スレーブアーキテクチャを使用します。その設計の基本原則は、データをコンピューティングに持ってくるのではなく、コンピューティングをデータに持ってくるということです。それは理にかなっています。データファイルは、1つのサーバーに収まらないほど大きい場合、複数のサーバーに分散して保存されます。そして、MapおよびReduce操作を行うとき、それらをさらに分割し、各ノードのサーバーがコンピューティングを行うことを許可します。したがって、各ノードはコンピュータであり、コンピュータ能力のないディスクドライブだけではありません。

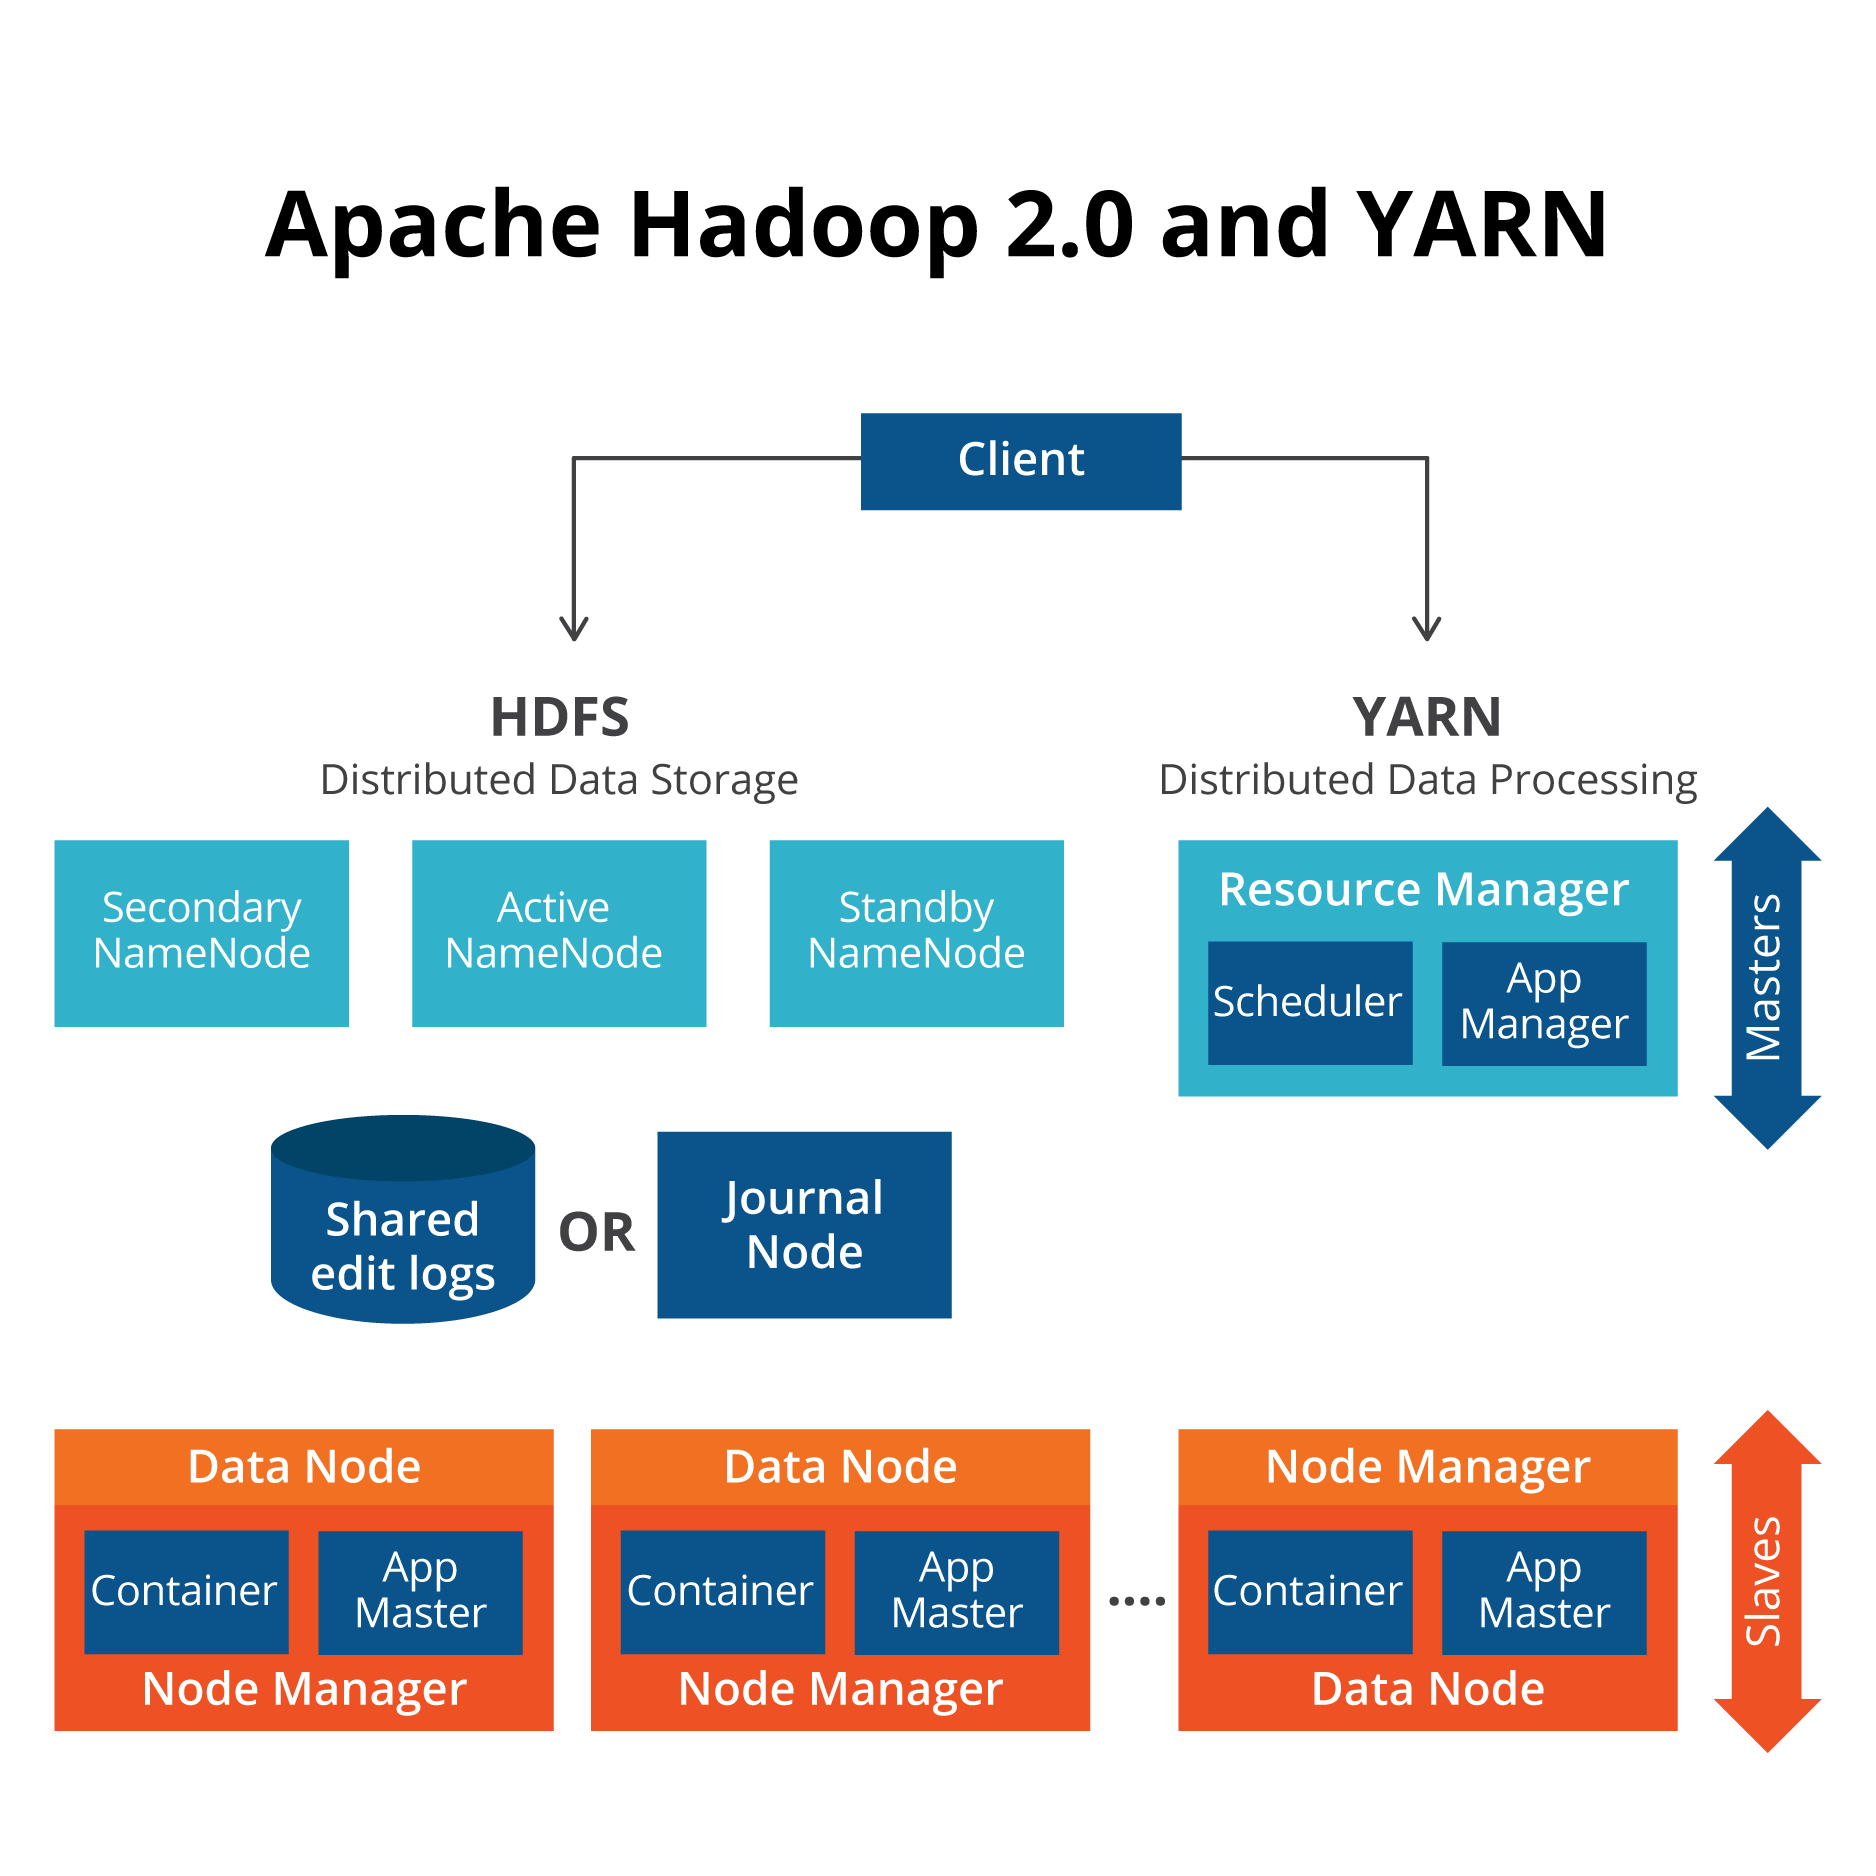
Hadoopの主なコンポーネントは次のとおりです。
- ネームノード—データジョブの操作を制御します。
- データノード—これはデータをローカルストレージにブロック単位で書き込みます。そして、他のデータノードにデータブロックをレプリケートします。データノードはラックを認識します。同じラックのサーバーにすべてのデータをレプリケートしたくないでしょう、なぜならそこに障害が発生するとすべてのデータを失うことになるからです。
- セカンダリネームノード—プライマリネームノードがオフラインになると引き継ぎます。
- ジョブトラッカー—クラスター内のノードにMapReduceジョブを送信します。
- タスクトラッカー—ジョブトラッカーからのタスクを受け入れます。
- Yarn—YarnコンポーネントのResourceManagerとNodeManagerを実行します。これは、他のアプリケーションが分散アーキテクチャで実行できるようにするリソースマネージャーです。例えば、Apache SparkをYarnで使用することができます。自分のプログラムをYarnで使用することもできますが、それは複雑です。
- クライアントアプリケーション—これは、あなたが書いたプログラムまたはApache Pigのような他のクライアントです。Apache Pigは、SQLのようなコマンドを受け取り、それをJava MapReduceプログラムに変換してHadoopで実行する使いやすいシェルです。
- アプリケーションマスター—Yarnによって指示されたコンテナ内でシェルコマンドを実行します。
クラスターと単一ノード
最初にHadoopをインストールすると、学習のために単一ノードで実行されます。しかし、本番環境では、異なるマシンで実行するデータノードを設定します。すべてのマシンのセットをクラスターと呼びます。Hadoopクラスターは、ペタバイトのデータを保存するために大規模にスケールします。
ここでクラスターの状態を確認できます
http://localhost:50070/dfshealth.html#tab-datanode.
MapReduceの例:eを計算
ここでは、Hadoopクラスターに対して実行するサンプルJava MapReduceプログラムを示します。数学定数eの値を計算します。
eは無限級数の合計Σ i = 0からnまで(1 + 1 /n!)です。これは:
e = 1 + (1 / (1 * 2)) + (1 / (1 * 2 * 3*) + (1 / (1 * 2* 3* 4)) + …
nを計算するほど、真の値eに近づきます。
したがって、これらの9つのnの値をテキストファイルin.txtにリストします:
    in.txt
1
2
3
4
5
6
7
8
9
map操作では、これらのキーと値のペアを作成します:
    (x, 1!)
(x, 2!)
…
(x,9!)
文字列xを各キーのキーとして使用することで、reduceステップでそれらを1つのキー(x,e)にまとめます。
次に、実行中の合計Σ i = (1 /n!)を計算し、reduceステップで1を値に追加してeの近似値を得ます。
まず、ファイルin.txtをHadoopファイルシステムにコピーします。(最初にそれをフォーマットし、ディレクトリを作成する必要があります)。
hadoop fs -put /home/walker/Downloads/in.txt /data/in.txt
以下はCalculateE.javaのソースコードです:コンパイルして実行するには、次の手順が必要です。
    export  HADOOP_CLASSPATH=${JAVA_HOME}/lib/tools.jar
hadoop com.sun.tools.javac.Main CalculateE.java
jar cf e.jar CalculateE*.class
hadoop jar e.jar CalculateE /data/in.txt /data/out.txt
コード:
    import java.io.IOException;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.DoubleWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class CalculateE {

public static class Factorial extends Mapper {public void map(Object key, Text value, Context context) throws IOException, InterruptedException {int n = Integer.parseInt(value.toString());double f = factorial(n);double x = (1 / f);DoubleWritable y = new DoubleWritable(x);Text ky = new Text("x");System.out.println("key=" + ky + " y= " + y);context.write(ky, y);}}public static int factorial(int f) {return ((f == 0) ? 1 : f * factorial(f - 1)); }  public static class DoubleSumReducer extends Reducer {		private DoubleWritable x = new DoubleWritable(0);		public void reduce(Text key, Iterable values, Context context)throws IOException, InterruptedException {			double sum = 0;			for (DoubleWritable val : values) {				sum += val.get();                                System.out.println("val=" + val + " sum=" + sum);			}                        sum += 1;			System.out.println("key=" + key.toString() + " e = " + sum);			x.set(sum);			context.write(key, x);		}	}	public static void main(String[] args) throws Exception {				Path inputPath = new Path(args[0]);	    Path outputPath = new Path(args[1]);	    		Configuration conf = new Configuration();		Job job = Job.getInstance(conf, "calculate e");				FileInputFormat.setInputPaths(job, inputPath);	    FileOutputFormat.setOutputPath(job, outputPath);	   	    		job.setJarByClass(CalculateE.class);		job.setMapperClass(Factorial.class);		job.setReducerClass(DoubleSumReducer.class);		job.setOutputKeyClass(Text.class);		job.setOutputValueClass(DoubleWritable.class);	 		System.exit(job.waitForCompletion(true) ? 0 : 1);	}}
プログラムが実行されると、結果は/data/out.txtのフォルダー内のファイルpart-r-00000に保存されます。最終結果は次のように表示できます:
    hadoop fs -ls /data/out.txt
hadoop fs -cat /data/out.txt/part-r-00000
 x 2.7182815255731922
それは実際の値e、2.71828に非常に近いです。プログラムを書いているときにデバッグを助けるために、stdoutログを確認できます。また、ジョブ履歴トラッキングサーバーをオンにして、ブラウザで確認することもできます:stdout出力には、デバッグの印刷を含む多くのHadoopメッセージが含まれています:
    key=x y= 1.0
key=x y= 0.5
key=x y= 0.16666666666666666
key=x y= 0.041666666666666664
key=x y= 0.008333333333333333
key=x y= 0.001388888888888889
key=x y= 1.984126984126984E-4
key=x y= 2.48015873015873E-5
key=x y= 2.7557319223985893E-6


val=2.7557319223985893E-6 sum=2.7557319223985893E-6
val=2.48015873015873E-5 sum=2.755731922398589E-5
val=1.984126984126984E-4 sum=2.259700176366843E-4
val=0.001388888888888889 sum=0.0016148589065255732
val=0.008333333333333333 sum=0.009948192239858907
val=0.041666666666666664 sum=0.05161485890652557
val=0.16666666666666666 sum=0.21828152557319222
val=0.5 sum=0.7182815255731922
val=1.0 sum=1.7182815255731922
key=x e = 2.7182815255731922
Hadoopのストレージメカニズム
Hadoopは、さまざまなクラウドベンダーや製品と連携できるように、主に複数のファイル形式でデータを保存できます。以下はそのいくつかです:
    Hadoop—these have the hdfs:// file prefix in their name.For example hdfs://masterServer:9000/folder/file.txt is a valid file name.

S3—Amazon S3.  The file prefix is s3n://

file—file:// causes Hadoop to use any other distributed file system.
HadoopはWindows Azure Storage Blobs(WASB)、MapR、FTPなどをサポートしています。
データファイルへの書き込み
Hadoopはデータベースではありません。つまり、データへのランダムアクセスはできず、テーブルに行を挿入したり、ファイルの中間に行を挿入することはできません。代わりに、Hadoopはファイルの書き込みと削除のみが可能ですが、切り詰めや追加はできますが、一般的には行われません。
他の製品のプラットフォームとしてのHadoop
Hadoopをより使いやすくし、SQLのようなインターフェースを提供するシステムがたくさんあります。例えば、Pig、Hive、HBaseなどです。
多くの他の製品も、インフラストラクチャの一部としてHadoopを使用しています。これにはPig、Hive、HBase、Phoenix、Spark、ZooKeeper、Cloudera Impala、Flume、Apache、Oozie、Stormが含まれます。
また、ElasticSearchのように、製品が自社の製品がそこにデータを読み書きできるようにするためにHadoopコネクタを書いた製品もたくさんあります。
Hadoopプロセスとプロパティ
jpsと入力して、どのプロセスが実行されているかを確認します。マスターとバックアップマスターにはネームノードとセカンダリネームノードが表示されるはずです。データノードはデータノードで実行されます。
最初にインストールすると、設定を変更する必要はありません。しかし、クラスターを設定するためのさまざまな設定オプションがあります。いくつかを以下に示します。
| プロセスまたはプロパティ | 一般的に使用されるポート | 設定ファイル | プロパティ設定項目の名前 |
| ネームノード | 50070 | hdfs-site.xml | dfs.namenode.http-address |
| セカンダリネームノード | 5090 | hdfs-site.xml | dfs.namenode.secondary.http-address |
| fs.defaultFS | 9000 | core-site.xml | ファイルアクセスに使用されるURL、例えばhdfs://master:9000。 |
| dfs.namenode.name.dir | file:///usr/local/hadoop |
| dfs.datanode.name.dir | file:///usr/local/hadoop |
| dfs.replication | レプリケーション値を設定します。一般的に3が使用されます。つまり、書き込むデータのコピーを3つ作成します。 |
Hadoop分析
Hadoopは一般的な信念とは逆に、分析を実行しません。つまり、Hadoopにはクラスタリング、線形回帰、線形代数、k-meansクラスタリング、決定木、およびその他のデータサイエンスツールは組み込まれていません。代わりに、Hadoopは分析の抽出と変換ステップのみを行います。
データサイエンス分析には、Spark ML(機械学習ライブラリ)やPython用のscikit-learn、R言語用のCran Rを使用する必要があります。しかし、最初のものだけが分散アーキテクチャで実行されます。他の2つは、入力データを単一のファイルにコピーする必要があります。Mahout分析プラットフォームもありますが、その著者はもはや開発しないと述べています。
これらの投稿は私自身の意見であり、BMCの立場、戦略、または意見を必ずしも表すものではありません。