




ポイント: レジリエントなデータパイプラインは、障害に適応しながら正確なデータ配信を確保します。主要な要素には、エラーを検出するための観測可能性、信頼性のための冪等性や不変性のような構造化されたプロセス、データの整合性を確認するためのデータバリデーターが含まれます。
- 観測可能性は迅速なエラー検出と修正を可能にします。
- 構造化プロセスは、障害時に一貫したデータ配信を保証します。
- データバリデーターは、受信データが期待される形式と制約に対して検証します。
レジリエントなデータパイプラインは、障害を検出し、そこから回復し、消費者に正確なデータを返します。レジリエンスは、観測可能性、構造化されたプロセス(冪等性や不変性を含む)、データバリデーターの3つの要素によって構築されます。これらは共に、何かがうまくいかないときに、データパイプライン が壊れるのではなく適応することを保証します。
データパイプラインをレジリエントにする要素は何ですか?
レジリエンスは、適応する能力を持つことを意味します。レジリエントなデータパイプラインは、障害が発生した場合に適応します。データパイプラインはデータを一地点から別の地点へ輸送し変換するために設計されているため、レジリエントなパイプラインは:
- 障害を検出する
- 障害から回復する
- 消費者に正確なデータを返す
冪等性
不変性
不変のインフラストラクチャ は、複雑さを減少させ、システムの動作についての明確な推論を可能にします。
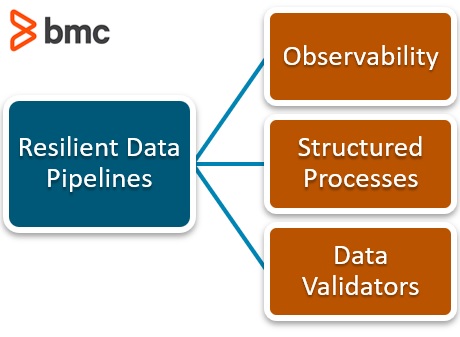
これを達成するには、観測可能性、構造化されたプロセス(冪等性や不変性を含む)、データバリデーターの3つの要素が必要です。
観測可能性はレジリエントなデータパイプラインをどのようにサポートしますか?
観測可能性は、エラーが迅速に修正されるように、迅速に視認されることを保証します。エラーが見逃されると、修正できません。良好なログの実践は、エラーを表面化させ、よく書かれたログはエラーを迅速に特定し、位置を特定できるようにします。開発者は通常、これらのログを読む人々であり、何が起こったのか、何をすべきかを理解する必要があります。
良いログメッセージには、3つの要素が含まれています:
- 発生したエラーのタイプに対して適切で一貫したカテゴリ
- エラーの原因に関する具体的な説明
- エラーを修正するために必要な行動に関する明確な指針
ログが開発者に、コードを調査することなく問題を修正するための道を示す場合、それは良いログです。
ログは、パイプラインとタスクの両方のレベルで書かれることもできます。次のことに答えるべきです:
- なぜパイプラインタスクが失敗したのか?
- パイプラインはいつスケジュールされたのか?
自分のプロセッサを使用する場合でも、第三者から借りる場合でも、各プロセッサはログを生成する必要があります。第三者のログにアクセスするか、自分のログを作成して視認性のウィンドウを広げるべきです。
最後に、データがパイプラインを通過した後、ログはデータが目的地に無事に到達したことを確認する必要があります。
観測可能性は、パイプラインリソースのメトリクスにも拡張されます。システムのレイテンシ、バッチキュー時間、実行ごとのリソース消費を監視して、パフォーマンスの低下を障害が発生する前にキャッチします。
構造化プロセスはパイプラインのレジリエンスをどのように向上させますか?
レジリエンスは、データパイプラインのインフラストラクチャが予測可能性を念頭に置いて設計されているときに向上します。目標は、障害が発生した場合でも、同じ期待される結果を一貫して提供するプロセスを使用することです。冪等性と不変性はそのようなプロセスの2つであり、プロセッサが利用できない、出荷途中で停止する、または複数回トリガーされる場合でも、データが最終ユーザーに正しく届くことを保証します。
構造化プロセスは2つのことを達成します:
- 良好なデータが最終ユーザーに届くことを保証する
- システムの障害が発生してもデータが到着することを保証する
冪等性 は、毎回の実行で同じ結果を返す関数です。絶対関数や丸め関数は本質的に冪等です。すべての関数が冪等であるわけではありませんが、冪等に動作するように関数を書くことができます。
データのリストに対して動作する削除関数を考えてみてください。目標がインデックス2の値2を削除することであれば、単に第二インデックスの値を削除する関数は冪等ではありません。複数回実行すると、順番に2、3、4を削除します。冪等版は、インデックス2の値が2であれば、それを削除することを指定します。このバージョンは繰り返し実行でき、常に正しい出力を生成します。(Wikipediaは冪等関数のさらなる例を示しています。)
従来、可変サーバーは使用中に更新および変更される可能性があります。しかし、各更新はサーバー間にわずかな違いを生じさせます。バージョン1.34を実行しているもの、1.74を実行しているもの、1.22を実行しているものがあります。このような異なるサーバー間でエラーを特定することは複雑になり、パイプラインのバージョン管理は、基盤となるインフラストラクチャがバージョンの移動混合であるときに困難です。
不変性とは、データがサーバーに書き込まれた後に削除または変更できないことを意味します。不変のインフラストラクチャは、パイプラインのバージョン管理を簡素化し、インフラストラクチャの構築エラーと実際のデータ処理タスクを分離します。
不変のインフラストラクチャでは、ステップ1はVMインスタンスを作成し、ステップ2はユーザーデータをそこに書き込むことかもしれません。VMの作成が失敗した場合、システムは安定したインスタンスが準備されるまでステップ1を再実行し、データが書き込まれることはありません。可変のインフラストラクチャでは、その同じ失敗パスはより複雑で、エラーが発生しやすく、バージョン管理が難しくなります。
データバリデーターはパイプラインのレジリエンスにどのように貢献しますか?
データバリデーターは、レジリエントなデータパイプラインにおける最終的な品質ゲートとして機能します。バリデーションは、データが消費者に到達したときに発生し、受信データが消費者の期待に合致することを迅速に処理します。
データバリデーターは次のことを確認します:
- データタイプ—整数、文字列、ブール値、その他の型制約
- 構造的制約—たとえば、有効な大学のメール形式、10桁の電話番号、またはゼロより大きい値
- 定量バリデーション—ドメイン固有の妥当性チェック、たとえば、4フィートのNBA選手の身長や、3週間前の日付の恐竜の化石
バリデーターは、適切なデータが消費者に返されることを保証しますが、実装に応じてパイプラインのレイテンシを増加させるリスクがあります。また、適切に書かれたバリデーターは、意図された機能を完全に果たさない場合もあります。
レジリエントなデータパイプラインは、障害が発生したときにどのように適応しますか?
レジリエンスは、障害発生時に適応することです。パイプラインに観測可能性を設計することで、障害が発表され、可視化され、是正措置が可能になります。冪等性や不変性のような構造化されたプロセスは、障害条件下でも機能するインフラストラクチャを構築します。データバリデーターは、パイプラインの最後で消費者に適切なデータが届くことを確認します。適切なログが全体に存在することで、障害が明らかになり、自動的または人的な修正によって、パイプラインは適応する自由を得ます。
企業規模でレジリエントなデータパイプラインを構築するには、SLAモニタリング、自動再試行ロジック、依存関係管理、そして単一のコントロールプレーンでのクロスプラットフォームの可視性を提供するデータパイプラインオーケストレーションソリューションが必要です。
よくある質問:レジリエントなデータパイプライン
レジリエントなデータパイプラインとは何ですか?
レジリエントなデータパイプラインは、障害を検出し、そこから回復し、消費者に正確なデータを返し続けるものです。レジリエンスは、観測可能性、冪等性や不変性などの構造化されたプロセス、そして受信データが期待される基準を満たしていることを確認するデータバリデーターによって構築されます。
データパイプラインにおける冪等性とは何ですか?
データパイプラインにおける冪等性とは、関数が実行される回数に関わらず同じ結果を返すことを意味します。冪等関数は、プロセッサが再起動したり、複数回トリガーされたり、実行途中で停止したりする場合の障害回復シナリオにとって重要です。
データパイプラインにおける冪等性と不変性の違いは何ですか?
冪等性は、繰り返し実行されても一貫した結果を生む関数を指します。不変性は、一度書き込まれたデータやインフラストラクチャが変更できないことを指します。両方の性質は、パイプラインの信頼性を向上させます:冪等性は再試行時に繰り返し可能な結果を保証し、不変性はバージョン管理を簡素化し、構築エラーをデータ処理から分離します。
良いデータパイプラインのログには何が含まれるべきですか?
良いデータパイプラインのログには、エラーのカテゴリ、エラーの原因に関する具体的な説明、そしてそれを修正する方法に関する明確な指針が含まれるべきです。ログはパイプラインとタスクの両方のレベルで書かれ、データがパイプラインを通過して無事に到達した際に確認エントリを含むべきです。
データバリデーターはデータの整合性をどのように保護しますか?
データバリデーターは、消費者に到達するデータが期待されるタイプ、構造的制約、ドメイン固有の妥当性基準を満たしているかどうかを確認します。彼らはパイプラインの最終的な整合性チェックとして機能し、腐敗したり、形式が悪かったり、あり得ないデータが下流のシステムや最終ユーザーに到達する前にキャッチします。
追加リソース
このトピックについての詳細は、BMC DevOpsブログを閲覧するか、次の記事をご覧ください:
この投稿で表明された意見や見解は著者のものであり、必ずしもBMCの公式な立場を反映するものではありません。
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。