




ポイント: Apache Yarnは、リソース管理とジョブスケジューリングを分離し、分散アプリケーションの効率を向上させるHadoopのリソースマネージャーです。SchedulerおよびApplicationsManagerデーモンを介してCPUやメモリなどのリソースを管理します。
- Yarnは、分散アーキテクチャ全体でのリソース配分を容易にします。
- Apache Sparkなどのアプリケーションと互換性があります。
Apache Yarn 101
ここでは、Hadoopに組み込まれたリソースマネージャーであるApache Yarnについて説明します。しかし、これは他のアプリケーションが分散アーキテクチャ全体でアプリケーションを実行するために使用できるスタンドアロンのプログラミングフレームワークでもあります。
Yarnを示すために、Hadoopクラスタを設定します。Yarn自体はあまり見るものではありません。特別な状況を除いて、コマンドラインから作業するものではありません。しかし、分散クラスタ全体で機能させることは、それが何をするのかを示すための演習です。単一のマシンにHadoopを設定すると、それはYarnの本来の使い方ではありません。これは、Yarnがサービスを共同配置するのを助けるからであり、それらを分割するのではありません。つまり、特定のタスクを実行するために単一のサーバーまたはサーバーを設定するのではなく、各サーバーを完全に活用することによって、組織が必要とするサーバーの数を減らすことを意味します。
Apache Yarn(Yet Another Resource Negotiator)は、YahooがHadoopを再設計してリソース管理をジョブスケジューリングから分離した結果です。これによりHadoopが改善されるだけでなく、YarnはApache Sparkなど他のソフトウェアと一緒に使用できるスタンドアロンコンポーネントであり、Yarnを使用して独自のアプリケーションを書くことができ、その結果、アプリケーションを分散アーキテクチャ全体で実行できるようになります。
Yarnは基本的にMesosと同じことをします。Yarnは、クラスタ全体(Hadoopが実行されているマシン)の利用可能なリソース(メモリ、CPU、ストレージ)を追跡します。次に、各アプリケーション(たとえばHadoop)は、リソースマネージャーに利用可能なリソースを尋ね、それに応じてそれらを配分します。これを行うために、SchedulerとApplicationsManagerという2つのデーモンを実行します。
Yarnは、タスクを制御し、割り当てられたリソース内に保つためにLinux cgroupsを使用します。Linux cgroupsはDockerやMesosコンテナに似ています。目標は、タスクが割り当てられたメモリ、CPU、ネットワーク、ストレージの使用量を維持することですが、Hadoop 2.7ではCPUの制限に制限されています。
Yarnはフレームワークであり、APIを意味します。以下のグラフィックでは、Node ManagerがリソースマネージャーにMapReduceタスクを実行して監視するように問い合わせるのが見えます。
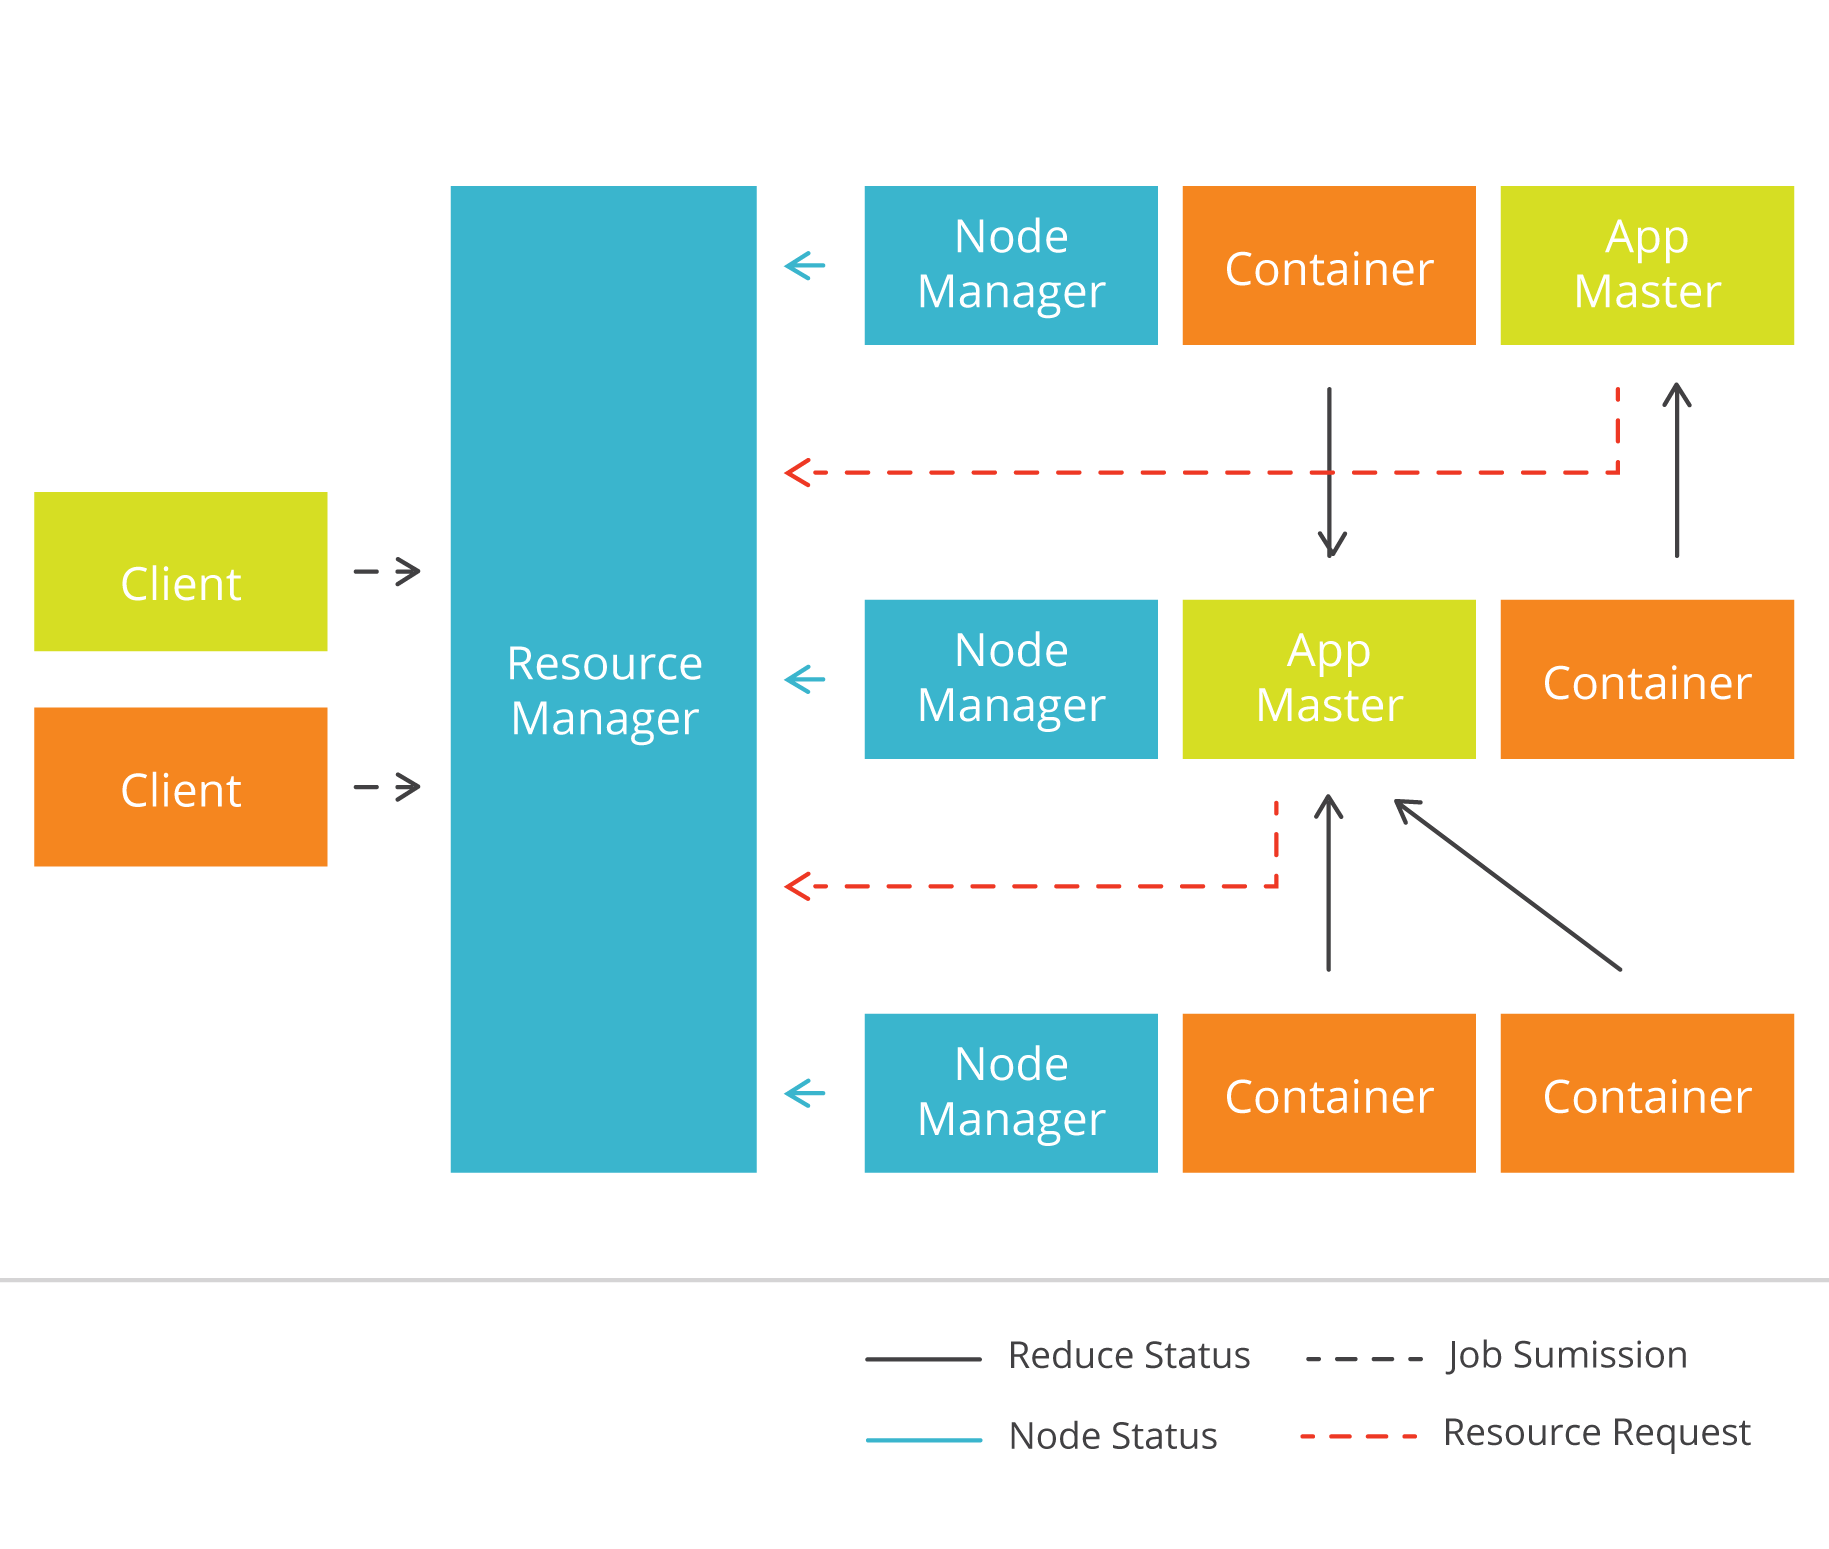
Hadoopを再確認すると、Hadoopは分散ファイルシステム(HDFS)であり、分散アーキテクチャ全体でファイルをコピーするために使用できます。しかし、分析のためにMapReduceジョブも実行します。つまり、入力ファイルを取得し、それをマッピング(つまり、データセット内のすべてのデータ要素に対して操作を実行)し、その後リデュースして、すべてを単一の値または(キー->値)ペアにグループ化します。したがって、それを調整するためにYarnのようなものが必要です。

yarn-site.xml
Hadoopでは、Yarnの設定ファイルは
$HADOOP_HOME/etc/hadoop/yarn-site.xml.
Hadoopの設定ファイルも同様です。
デフォルトのYarn設定には、基本テストに必要なこの1つのプロパティのみがあります。
    yarn.nodemanager.aux-services
    mapreduce_shuffle
ここに置いたものは、Yarnのデフォルトを上書きします。
HadoopクラスタでYarnを使用
Apache YarnとHadoopを学習している場合は、Hadoopクラスタを設定する必要があります。ほとんどのHadoopの学生は、1台のマシンにHadoopを設定し、そこで止まります。しかし、そうすると、Hadoopがクラスタでどのように実行されるか、またそれをどのように操作するかを見ることができません。裏側では、YarnがMapReduce操作を調整していますが、それを示す目に見える証拠はありません。ログを掘り下げない限り、Hadoopのログを掘り下げることになるでしょう。core-site.xmlとhdfs-site.xmlの構成は複雑な部分であり、ログは構成エラーを探して修正する場所です。Yarnに関しては、全く構成変更は必要ありません。
Hadoopをクラスタで実行するための設定手順は次のとおりです:
- 少なくとも2台の仮想マシンを起動します。3台が望ましいです。
- Hadoopユーザーを作成し、次のHadoopインストール手順を実行し、そのユーザーとしてHadoopコマンドを実行します。
- /etc/hostsにすべての3台のマシンのホスト名とIPを入力します。
- マスター上にHadoopデータを保存するフォルダを作成します。ここに入力する名前は、ステップ7と一致する必要があります。
- マスターとして指定したマシンにHadoopをインストールします。
- すべての3台の仮想マシンにJavaをインストールします。
- Hadoopのcore-site.xmlとhdfs.xmlの設定に関する指示を確認します。指示はHadoopのバージョンによって若干異なります。
- $HADOOP_HOME/etc/hadoop/slavesを編集し、スレーブのホスト名を追加します。
- hadoop-env.shにJAVA_HOMEを追加します。
- スレーブにHadoopをインストールしないでください。むしろ、Hadoop全体のインストール(つまり、$HADOOP_HOMEディレクトリ)をスレーブにコピーします。
- 以下に示すように、Hadoopユーザーの.bashrc構成ファイルを設定します。
- Hadoopを起動し、start_yarn.shを実行するためにstart_dfs.shを実行します。Hadoopのインストール問題を解決しながら作業している場合、Hadoopを再起動する必要はありません(正しく動作させるまで何度かかかることがあります)。
- スレーブでjpsを実行し、dataNodeプロセスが実行中であることを確認します。
- マスターでjpsを実行し、nameNodeプロセスが実行中であることを確認します。
- マスターでこのURLを開けることを確認します http://localhost:50070/dfshealth.html#tab-overview
- 次のコマンドを使用してHadoopファイルシステムをフォーマットします: hadoop namenode -format。
- Apache Pigをインストールし、以下に示す例を実行できることを確認します。
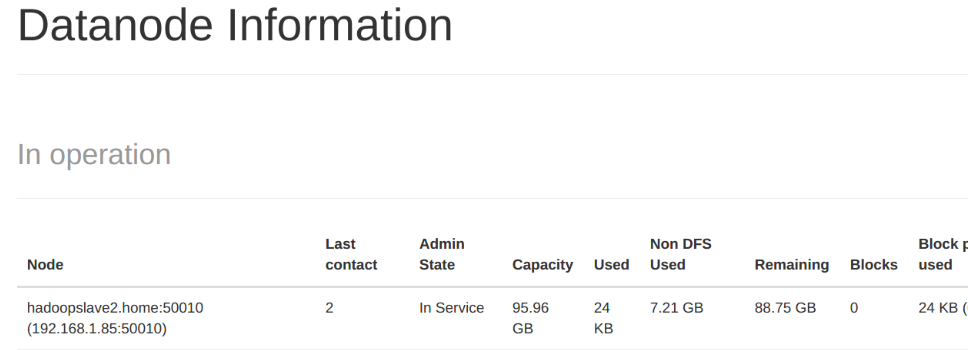
すべてが正常に動作していれば、ステップ15はこのウェブページを表示するはずです:
Yarnコマンドライン
コマンドラインからYarnを実行して情報を取得できます。ただし、実際には必要ありません。
ファイル$YARN_HOME/etc/hadoop/yarn-env.shは、YarnコマンドラインオプションのYarnオプションを上書きする場所です。
クラスパスを環境に追加して、コマンドラインからYarnを使用できるようにします。
export CLASSPATH=`yarn classpath`:$CLASSPATH
Yarnクラスパスコマンドは、Yarnを実行するために必要なすべてのjarファイルを返します。
.bashrc
ここでの.bashrcは次のようにする必要があります。使用しているJavaおよびHadoopディレクトリに合わせて変更してください:
    export JAVA_HOME=/usr/local/jdk-8u121/jdk1.8.0_121
export PATH=$PATH:$JAVA_HOME/bin
export HADOOP_HOME=/usr/local/hadoop/hadoop-2.7.3/
export HADOOP_MAPRED_HOME=$HADOOP_HOME
export HADOOP_COMMON_HOME=$HADOOP_HOME
export HADOOP_HDFS_HOME=$HADOOP_HOME
export YARN_HOME=$HADOOP_HOME
export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native
export PATH=$PATH:$HADOOP_HOME/sbin:$HADOOP_HOME/bin
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export HADOOP_CLASSPATH=$HADOOP_HOME/etc/hadoop
YarnでApache Pigの例を実行
ここでは、Apache Pigを使用してクラスタ全体でHadoopジョブを実行します。Pigは長いJavaコードを書くよりも使いやすいです。Netflixが行っていることです。
マスターにApache Pigをダウンロードしてインストールします。これは、ダウンロードして解凍し、環境をソースするだけなので簡単なインストールです。Hadoopユーザーとしてこれらのコマンドを実行します。
このシンプルなテキストファイルdata.csvを作成します。これはいくつかの人々とその年齢を示しています。ディレクトリを作成し、それをHadoopにコピーします:
    walker,23
steen,45
antonella,35
fernando,24
Hadoopディレクトリを作成します:
hadoop fs -mkdir /data
ファイルdata.csvをそこにコピーします:
hadoop fs -put /home/walker/Downloads/data.csv /data/
次に、mapReduceモードでPigを実行します。つまり、分散クラスタを使用します:
pig -x mapreduce
それはgruntコンソールを開きます:
次に、gruntシェルにこれらの2つのコマンドを入力します:
表示されるはずです:
    ages = LOAD '/data/data.csv' USING PigStorage(',') as (NAME:chararray,age:int);
dump ages
表示されるはずです:
    (walker,23)
(steen,45)
 (antonella,35)
 (fernando,24)
他のアプリケーションとYarnを使用
Yarnは、マルチスレッド分散プログラムを作成するために書いた任意のアプリケーションと一緒に使用できます。プログラム内でYarnClientオブジェクトを使用するだけで済みます。その後、ApplicationMasterを実装します。Yarnにアプリが必要とするJARファイルや他のファイル、および実行するコマンドを伝えます。そうすれば、それはコンテナ上でアプリケーションを実行します。
これを行うのはかなり複雑です。この複雑さを軽減することを目指したApache Twillを使用できます。この記事が書かれた時点では、Apache Twillは機能していませんでした。
YarnでApache Sparkを使用
YarnでApache Sparkを実行することもできます。Yarnサポートで構築されたSparkのディストリビューションが必要です。これを動作させると、次のようにScalaシェルを開くことができるはずです:
spark-shell --master yarn
Hadoopガイド
- 初心者のためのHadoopチュートリアル: Hadoopの基本
- Hadoop管理の紹介
- Hadoopセキュリティの紹介
- Apache Flumeの紹介
- Hiveの紹介
- HDFSの紹介
- Hbaseの紹介
- Hadoopの例: 5つの実世界のユースケース
- Hadoopキャリア: 採用されるために
- Hadoop面接質問
- Hadoop分析の紹介
- Apache Pigの紹介
- Apache Yarnの紹介
- Hadoopアーキテクチャの紹介
- Hadoopの利点と利点
- Apache CassandraとのHadoopの使用
- Hadoop対Kubernetes: K8sとクラウドネイティブはHadoopを終わらせるか?
- Hadoop認定
- Hadoopクラスタの紹介
- Hadoopエコシステムとコンポーネント
これらの投稿は私のものであり、BMCの立場、戦略、または意見を必ずしも代表するものではありません。