




ポイント: データレイク、データウェアハウス、データベースは、データストレージにおいて異なる目的を果たします。データレイクは、先進的な分析のための非構造化データを収容し、データウェアハウスはビジネスインテリジェンスのために構造化データを必要とします。それぞれに独自の強み、コスト、ユーザーベースがあり、組織のデータ戦略と意思決定に影響を与えます。
- データレイクは、多様なデータタイプのための柔軟性とコスト効果の高いストレージを提供します。
- データウェアハウスは、効率的なデータ分析と意思決定のための構造化環境を提供します。
データストレージは重要です。データ企業は最近ニュースでよく取り上げられており、特に企業がビッグデータの潜在能力から価値を最大化しようとする中でそうです。一般的な人々にとっては、データストレージは通常、従来のデータベースで処理されます。しかし、ビッグデータの場合、企業はデータウェアハウスやデータレイクを使用します。データレイクはしばしばデータウェアハウスと比較されますが、比較すべきではありません。データレイクとデータウェアハウスは非常に異なり、構造や処理から、誰がどのように使用するかまで違いがあります。この記事では、私たちは:
- データベース、データウェアハウス、データレイクを定義する
- データレイク対データウェアハウスに飛び込む
- 大きな違いを要約する
- データレイクの使用に注意する
- データストレージの未来を探る
- 適切なデータストレージソリューションの選び方を示す
- その他
データベース、データウェアハウス、データレイクの定義
概念から始めましょう。専門家のアナロジーを使って違いを引き出します。
データベースとは何ですか?
データベースは、構造化データを収容するストレージロケーションです。データベースは通常、コンピュータ上にあり、データを保持し、さまざまな方法でアクセス可能です。スマートフォンをデータベースと見なすこともできるかもしれません。なぜなら、あなたに関するすべてのデータを保持しているからです。すべての組織にとって、データベースの使用ケースには:
- 財務およびその他のデータのレポートを作成する
- 比較的小さなデータセットを分析する
- ビジネスプロセスを自動化する
- データ入力を監査する
データベースの例
商業データベースシステムには、さまざまな選択肢があります。以下の各例には、アプリケーションに最適なものを選択する際に考慮すべき異なる機能と能力があります。人気のあるデータベースは:
(データベースの主要な違いについてもっと学ぶ:SQL対NoSQL。)
データウェアハウスとは何ですか?
データベースの次のステップはデータウェアハウスです。データウェアハウスは、さまざまなソースから蓄積したデータのための大規模なストレージロケーションです。数十年にわたり、ビジネスインテリジェンスとデータの発見/ストレージの基盤はデータウェアハウスに依存していました。彼らの特定の固定構造は、実行可能なデータ分析を決定します。データウェアハウスは、中規模および大規模企業に人気があり、チームまたは部門のサイロ化されたデータベースを通じてデータとコンテンツを共有する方法として使用されます。データウェアハウスは、組織がより効率的になるのを助けます。データウェアハウスを使用する組織は、しばしば管理の決定を導くために使用します——あなたが常に耳にする「データ駆動型」の決定です。
データウェアハウスの例
これらの大規模データストレージソリューションは、複数のソースからデータを集約して、ビジネス分析と意思決定をサポートする単一のリポジトリにすることを可能にします。データウェアハウスを提供する人気の企業は:
- Snowflake
- Yellowbrick
- Teradata
データレイクとは何ですか?
データレイクは、必要になるまで元の形式で大量の生データを保持する大規模なストレージリポジトリです。データレイクは、データウェアハウスの最大の制限を活用します:より柔軟である能力です。以下で見るように、データレイクの使用ケースは一般的にデータサイエンス研究とテストに限られています——したがって、データレイクの主なユーザーはデータサイエンティストやエンジニアです。たとえば、実際にデータウェアハウスを構築する企業にとって、データレイクはすべてのデータを一時的に捨てて保存する場所です。中小企業はデータレイクを使用する理由がほとんどありません。
データレイクの例
これらの巨大な貯水池は、構造化されたデータ、部分的に構造化されたデータ、または完全に非構造化されたデータを含む柔軟性があります。AI、機械学習、新しいタイプのデータ分析がますます多様なデータタイプや構造を処理する中で、データレイクはスケーラブルで柔軟な選択肢として浮上しています。人気のデータレイク企業は:
- Hadoop
- Azure
- Amazon S3
データレイク対データウェアハウス
データストレージオプションの違いを理解することで、アプリケーションに適した選択をすることができます。各オプションが提供するものの簡単な要約は次のとおりです: データベース:
- トランザクションのリアルタイム処理に最適です。
- データは高度に構造化され、値と属性の行と列に正規化されています。
- スキーマは厳格で、一貫性を強調します。
- スケーラビリティは制限されています。
データウェアハウス:
- ビジネスインテリジェンスを格納し、運用上の意思決定のための過去のデータを分析するのに最適です。
- データは複数のソースから来ており、構造化されているか半構造化されています。
- スキーマは事前定義されていますが、分析をサポートするためにある程度適応可能です。
- スケーラビリティは高く、大量のデータを効率的かつ経済的に処理します。
データレイク:
- 多様でまだ定義されていないアプリケーション(機械学習やその他の高度な使用を含む)のために大量のデータを格納するのに最適です。
- データは構造化、非構造化され、テーブル、ログ、画像、文書などのさまざまな形式で存在する可能性があります。
- スキーマはデータがアプリケーションで読み取られ、使用されるときに適用され、それ以外の場合はストレージ内のデータにスキーマはありません。
- スケーラビリティと柔軟性はコスト効率が高く、データレイクの中心的な価値です。
データレイク対データウェアハウス対データベース:違いを説明する
データサービスプロバイダーのAeroVision.ioの社長、リー・イーストンは、違いを理解するためのツールのアナロジーを推奨しています。この場合、あなたのデータは使用できるツールです。あなたの裏庭にあるツール小屋を想像してください。いくつかのツール——データ——をツールボックスに入れるか、(かなり)整理された棚に置きます。この特定の、アクセス可能で整理されたツールストレージがあなたのデータベースです。ツール小屋、すべてが保存されているところがあなたのデータウェアハウスです。あなたはショップにたくさんの(たくさんの!)ツールボックスを持っているかもしれません。いくつかのツールボックスはあなたのものかもしれませんが、あなたの小屋が大きければ、友人や隣人のツールボックスを保管することもできます。彼らのツールを保管しながらも、近隣の人々は自分のツールボックスに整理されたままにしています。しかし、もしあなたの友人がすべてのツールを保管するのにツールボックスを使っていない場合はどうでしょう?彼らはすべてをそこに捨てて、整理されておらず、何のツールが何のためのものなのかもわからない——これがあなたのデータレイクです。データレイクでは、データは生の状態で未整理であり、おそらく非構造化です。データレイクからの生データが棚(データベース)や整理されたシステム(データウェアハウス)に整理されていない場合、ほとんどツールとしての価値はありません——生の形では、そのデータは役に立ちません。
データストレージの比較
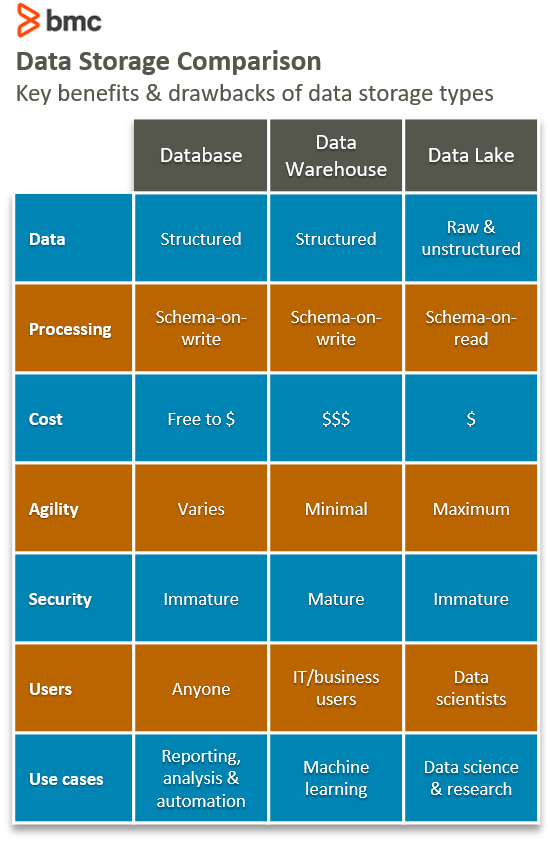
概念を把握したので、データベース、データウェアハウス、データレイクの違いを6つの重要な領域で見ていきましょう。
データ
データベースとデータウェアハウスは、構造化されたデータのみを保存できます。一方、データレイクはデータウェアハウスやデータベースのようにデータを尊重せず、すべてのタイプのデータ(構造化、半構造化、または非構造化)を保存します。3つのデータストレージロケーションはすべてホットデータとコールドデータを扱うことができますが、コールドデータは通常、データレイクに最適であり、レイテンシは問題ではありません。(以下のレイテンシについてもっと。)
処理
データをデータウェアハウスにロードする前に、データには形と構造が必要です——つまり、モデルが必要です。データに形と構造を与えるプロセスをスキーマオンライティングと呼びます。データベースもスキーマオンライティングアプローチを使用します。一方、データレイクは生の形式のデータを受け入れます。データを使用する必要があるときには、形と構造を与えなければなりません。これをスキーマオンリードと呼び、データを処理する非常に異なる方法です。
コスト
ビッグデータ技術の最も魅力的な特徴の1つは、データを保存するコストです。ビッグデータ技術でデータを保存することは、データウェアハウスに保存するよりも比較的安価です。これは、データ技術がオープンソースであることが多く、ライセンスやコミュニティサポートが無料だからです。データ技術は、低コストのコモディティハードウェアにインストールされるように設計されています。データウェアハウスの保存は高価になる可能性があり、特にデータのボリュームが大きい場合はそうです。一方、データレイクは低コストのストレージを目的としています。データベースは、ニーズに応じて高くも低くもなる柔軟なストレージコストがあります。
アジリティ
データウェアハウスは、高度に構造化されたデータバンクであり、固定された構成であり、アジリティがあまりありません。構造を変更することは技術的には難しくありませんが、すでにデータウェアハウスに結びついているすべてのビジネスプロセスを考慮すると、時間がかかります。同様に、データベースもその構造的な性質のため、構成が難しいです。対照的に、データレイクは構造を欠いています。このアジリティにより、データ開発者やデータサイエンティストは、データモデル、クエリ、およびアプリケーションを簡単に構成および再構成できます。(これが、データの専門家が主に——一般の従業員ではなく——データレイクで作業している理由です:研究やテストのためです。構造の欠如は非専門家を遠ざけます。)
セキュリティ
データウェアハウステクノロジーは、ビッグデータ技術とは異なり、何十年も前から存在しており使用されています。データウェアハウスは、データレイクよりもはるかに成熟しており、安全です。ビッグデータ技術は相対的に新しいものであり、データレイクのデータを保護する能力は未熟です。驚くべきことに、データベースはしばしばウェアハウスよりも安全性が低いです。これは、データベースが小さなデータセットのために開発されたためであり、今日のビッグデータの使用例には合致しません。幸いなことに、データセキュリティは急速に成熟しています。
ユーザー
データウェアハウス、データレイク、データベースは、異なるユーザーに適しています:
- データベースは非常に柔軟で、したがって、あらゆるユーザーに適しています。
- データウェアハウスは主にビジネス業界のビジネス専門家によって使用されます。
- データレイクは主に科学分野でデータサイエンティストによって使用されます。
データレイクに関する注意
企業はデータレイクを採用しており、時にはデータウェアハウスの代わりに使用しています。しかし、データレイクは欠点や短所がないわけではありません。新技術はしばしば課題を伴い——予測可能なものもあれば、そうでないものもあります。データレイクも例外ではありません。データレイクがエラーに陥りやすいわけではありません。むしろ、データレイクに進出する企業は、注意を払うべきです。
データレイクの欠点
データレイクはすべてのデータ問題を解決することはありません。実際、データレイクは問題を引き起こす可能性があり、解決しようとする問題よりも多くの問題を作り出すことがあります。これは、データレイクがデータのベストプラクティスを見落とす傾向があるからです。
- データレイクは、すべてのデータが必要かどうかを疑問に思うことなく、何でも保存できます。このアプローチは誤りであり、データレイクユーザーがデータから価値を得るのを難しくします。
- データレイクは、サプライチェーンにどのデータを入れるか、どのデータが有益かを優先しません。このデータの優先順位付けの欠如は、データレイクのコスト(データウェアハウスやデータベースと比べて)を増加させ、必要なデータの明確さを曇らせます。これにより、あなたの全体的な分析プロセスが遅くなり、さらには停止します。この問題を避けるために、データを保存する前に要約し、行動を起こしてください。
- データレイクでは、データのレイテンシが高くなります。データレイクは報告や分析に頻繁に使用されるため、データを取得する際の遅延が分析に影響を与えます。データのレイテンシは対話的な応答を遅くし、結果的に組織の時計の速度を低下させます。そのデータの目的と、それにアクセスする速度が、データをデータウェアハウスまたはデータベースに保存する方が良いかどうかを決定すべきです。
- データレイクには、受け入れることができるデータに関するルールがなく、組織のリスクを増加させます。すべてのデータを保存できるため、データの起源に関係なく、さまざまな規制リスクにさらされます。これを組織内のデータレイクのすべてのユーザーに当てはめます。データの優先順位付けの欠如は、コンプライアンスリスクをさらに悪化させます。
- データレイクはデータの過剰摂取を助長します。優先順位付けされていないデータが多すぎると、複雑さが生じ、企業にとってコストと混乱が増え、価値がほとんど得られません。組織は独自のデータレイクを追求すべきではなく、データレイクは実用的なソリューションと整合する包括的なデータ戦略の中でのみ使用されるべきです。
データは、タイムリーな方法で意思決定を支援するために利用される場合にのみ価値があります。データレイクに保存されたデータを分析しようとするユーザーや企業は、そのデータを見つけて分析の準備をするのに多くの時間を費やすことになります——データ駆動型の操作におけるデータ効率の正反対です。代わりに、常にデータをサプライチェーンの視点から見るべきです:始まり、中間、終わり。データに関係なく、あなたは常に次のように計画すべきです:
- データを見つける
- データを組織のデータストレージに持ち込む
- データを探求し、変換する
このアプローチにより、データから価値を引き出す最適化が可能になります。
データウェアハウスの未来
データウェアハウスがデータレイクに取って代わられている場合、復活しているかもしれません。これは、マーク・キュサック、イエローブリックのCTOによる2つの主な理由によります:
- データウェアハウス企業は、消費者のクラウド体験を向上させ、管理の負担をほとんどかけずにウェアハウスを試し、購入し、拡張することを容易にしています。
- データウェアハウジングは、機械学習とAIにおいて重要になります。これは、MLの可能性が最新のデータに依存しているため、そのデータはウェアハウスに保存されるのが最適です——レイクではなく。
機械学習モデルを開発する際、データの準備に約80%の時間を費やします。ウェアハウスには変換機能が組み込まれており、このデータ準備を簡単かつ迅速に実行でき、特にビッグデータスケールでの処理が容易です。また、これらのウェアハウスは、さまざまな分析プロジェクトで機能や機能を再利用し、異なる機能にスキーマを重ねることができます。これにより、重複が減り、データの質が向上します。
企業が機械学習とデータサイエンスを採用するにつれて、データウェアハウスはデータツール小屋の中で最も価値のあるツールになります。
どのデータストレージソリューションが私に適していますか?
データベースとデータウェアハウス、データレイクについては、適切な選択はユースケースと組織のニーズによります。一部の組織は、さまざまなデータ使用をサポートするために、すべてのアプローチを使用します。ハイブリッドアプローチは、柔軟性、スケール、およびパフォーマンスをバランスよくコスト効果的にサポートします。
- 組織がリアルタイムでトランザクションを効率的に処理する必要がある場合、データベースが理想です。
- ビジネスインテリジェンス分析と、大量の構造化および半構造化データからの報告をサポートする必要がある場合、データウェアハウスが力とパフォーマンスを提供します。
- 大規模な多様な生データを使用し、高度な分析、機械学習、またはビッグデータ処理を適用することを予測している場合、データレイクが最適です。
BMCのデータソリューション
BMCの受賞歴のあるControl-Mは、企業の自動化とオーケストレーションのための業界標準です。そして、私たちの新しいSaaSソリューションControl-M SaaSは、クラウド上で同じ組織、制御、オーケストレーションを提供します。
追加リソース
このトピックについてさらに探求するには、次のリソースをチェックしてください:
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも表すものではありません。