




ポイント: Pandasは、さまざまなデータ形式を効率的に変換および処理できるデータ分析および操作のための強力なPythonライブラリです。NumPyおよびMatplotlibと統合されて、機能が強化されています。
- Pandasは、データをデータフレームのような構造化された形式に簡単に変換できます。
- CSV/JSONファイルの読み込みやデータ変換などのタスクを簡素化します。
この記事では、データ分析ライブラリであるPandasを紹介します。私たちは:
- ツールを簡単に見てみます
- 基本的な操作を実行する方法を示します
Pandasとは何ですか?
PythonのPandasデータフレームは、配列データ構造以上のものです。Pandasは、次のことを可能にする強力なツールです:
- JSON、CSV、配列、辞書、および他のデータを行と列の形式に変換する
- インデックスの代わりに名前を使用して作業する(インデックスを選択することもできます)
要するに、Pandasはスプレッドシートのようなもので、Microsoft Excelではなくコードを使用して作業するものです。最大の利点は:
- Pandasは非常に複雑なデータ変換を簡単で自然にします。
- 数多くの数学、分析、その他の関数が含まれています。
PandasはNumPyとMatplotlibの上に構築されています。したがって、Pandasは:
Pandasの動作
- 大規模なn次元配列(NumPy)で効率的に作業する
- スライスを取り、それらを異なる形状に変換する(NumPy)
- チャートを描く(Matplotlib)
NumPyはほとんどのPython機械学習ソフトウェア開発キット(SDK)の作業馬です。PandasがNumPyを拡張するため、機械学習操作もサポートします。
Pandasの基本操作
さて、Pandasの基本を示す簡単なチュートリアルに移りましょう。
配列からデータフレームを作成する
まず、配列からデータフレームを作成します。
これは2x2の配列です(つまり、その形状は2x2です)。2行2列です。列名の配列には2つの要素が必要です。ここではstudentとgradeを入れます。
    import pandas as pd

df = pd.DataFrame([["Fred",80],["Jill",90]],columns=["student", "grade"])
その後、dfと入力してそれを確認します。Jupyter Notebookでは、表示がフォーマットされています。(以下では、チャートを作成するため、グラフィックスをサポートするJupyterを使用する必要があります。)
df
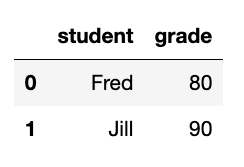
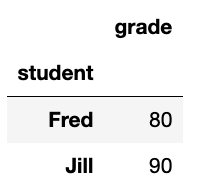
データフレームのインデックスは単に行のカウントで、0と1です。学生名をインデックスとして使用する方が自然です。これを行うにはset_indexを使用します。
通常、Pandasデータフレーム操作は新しいデータフレームを作成します。しかし、いくつかの操作ではinplace=True を使用して、新しいものを作成することなく既存のデータフレームを更新できます。
df.set_index("student",inplace=True)
今はこのように見えます:
Pandasデータフレームに列を追加
Pandasデータフレームに列を追加しましょう。このプロセスはその場で行うことができます。2つの行があるので、2つの値を期待しています。新しい列を追加するにはdataframe['new column name']を使用します。新しい列が既存のデータフレームに挿入されます。
df['birthdate']=['1970-01-12', '1972-05-12']
列値でデータフレームをフィルター
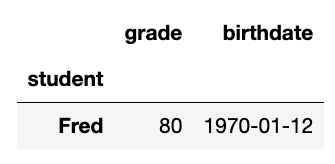
ここでは、1970-01-12に生まれたすべての学生を選択します:
df[df['birthdate']=='1970-01-12']
生成物:
Pandasシリーズ: データフレームから1列を選択
ここでは、1列を選択します。これはデータフレームとは呼ばれませんが、seriesと呼ばれます。基本的には1列のデータフレームです。しかし、異なるタイプのオブジェクトであり、やや異なるメソッドを持っています。
grade=df['grade']
インデックスが学生名のままであることに注意してください。Pandasは、成績が int64型のものであることを教えてくれます—64ビット整数です。これは、数多くの数値型をサポートするNumPyを使用しているためです。通常のPythonは整数と浮動小数点数のみをサポートしています。したがって、NumPyはそれらをエミュレートします。Pythonのdecimalオブジェクトが10進数をエミュレートするのと同じように。
    student
Fred    80
Jill    90
Name: grade, dtype: int64
Pandasデータフレームに行を追加
もう少し学生を追加しましょう。
ここでは、新しいデータフレームを作成し、既存のものに追加して新しいものdf3を作成します。この例では、df2ではPandasに学生名をインデックス値として指定しています。上記で行ったようにset_indexを使わずに行います。
    df2 = pd.DataFrame([[70,'1980-11-12'],[97, '1984-11-01']],index=["Costas", "Ilya"], columns=["grade", "birthdate"])

df3=df.append(df2)
今では、さらに学生がいます:

インデックス位置でPandasデータフレームの行を選択
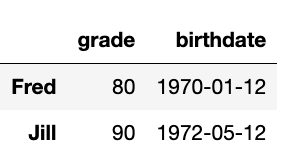
ここでは、インデックスオフセットで選択するilocを使用して最初の2行を選択します。
df3.iloc[0:2]
生成物:
Pandasマップ関数と散布図
Pandasが他に何をできるかを示すために、散布図を作成しましょう。年齢を成績でプロットします。
まず、誕生日を数値に変換する必要があります。次のようにdatetime64型のNumPyフィールドを作成します:
bday=pd.to_datetime(df3['birthdate'])
bdayはシリーズです。次に、今日の日付を計算します:
    from datetime import datetime
import numpy as np

today = datetime.now()
次に、map関数を使用する方法を示します。これは、データフレームまたはシリーズのすべての行を走査します。
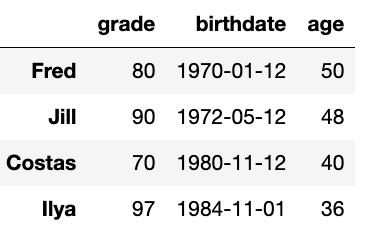
誰かの年齢は今日の日付からその誕生日を引いたものです。その引き算はtimedeltaオブジェクトを与えるので、365日で割ります np.timedelta64(365, 'D') ことで、その年齢の非常に近い推定値を得ます。(すべての年が365日ではありません。)これを行わなかった場合、年齢は時間差オブジェクトになり、単一の整数値にはなりません。
    bday.map(lambda l: int((today-l)/np.timedelta64(365, 'D')))

df3['age']=bday.map(lambda l: int((today-l)/np.timedelta64(365, 'D')))
今はこのように見えます:
次に、成績と年齢をプロットすることで、PandasがMatplotlibを含む方法を示します。x軸とy軸に使用する列と点の色を指定します。
    df3[['grade','age']].plot.scatter(x='grade',
                      y='age',
                      c='DarkBlue')
こちらがチャートです:
列の相関関係を表示
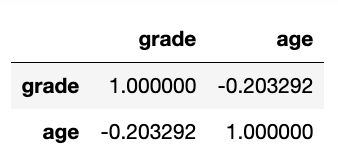
もう一つの機能を示すために、年齢が成績と相関しているかを見てみましょう。もちろん、そうではありませんが、Pandasがこれと他の多くの高度な機能を持っていることを示しましょう。
df3[['grade','age']].corr()
したがって、成績は自分自身と完全に相関している(1.0)ことが明らかですが、年齢とはまったく相関していません(< 0):
追加リソース
関連する読み物やチュートリアルを探索するには、これらのリソースを参照してください:
- BMC機械学習およびビッグデータブログ
- Python開発ツール: あなたのPythonスターターキット
- 2021年に使用するための主な機械学習フレームワーク
- データ可視化ガイド、さまざまなツールを使用したチュートリアルのシリーズ
- MongoDBガイド、MongoDBチュートリアルのシリーズ
Pandasガイド
これらの投稿は私自身のものであり、必ずしもBMCの見解、戦略、または意見を代表するものではありません。