




ポイント: TensorFlow、PyTorch、Keras、scikit-learnなどのトップ機械学習フレームワークは、複雑なアルゴリズムを単純化することでモデル開発を容易にします。これらは機械学習と深層学習のさまざまなニーズに応え、データサイエンティストにとって不可欠なツールを提供します。
- TensorFlowとPyTorchは広範な機能を持つ主要な競合者です。
- Kerasはニューラルネットワークモデリングを簡素化し、scikit-learnは迅速なプロトタイピングに最適です。
多くの機械学習フレームワークがあります。各フレームワークを学ぶには時間がかかり、また、いくつかは他よりもユーザーベースが広いので、どれを使用するべきでしょうか?
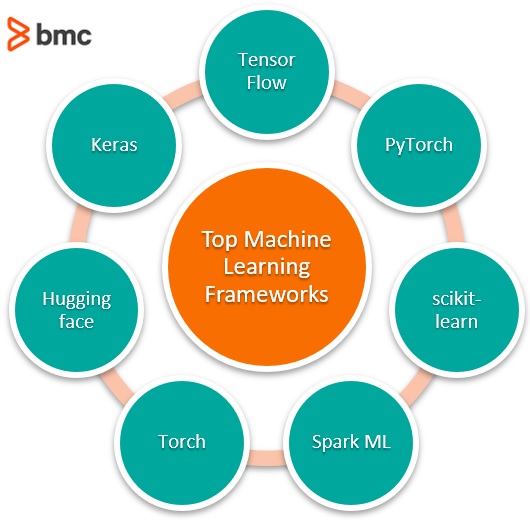
この記事では、主要なMLフレームワークと新しいものを高レベルで見ていきます:
TensorFlow
PyTorch
scikit-Learn
Spark ML
Torch
Keras
MLフレームワークとは何ですか?
機械学習はアルゴリズムに依存しています。あなたがデータサイエンティストやML専門家でない限り、これらのアルゴリズムは非常に複雑で理解するのも扱うのも難しいでしょう。
したがって、機械学習フレームワークは機械学習アルゴリズムを簡素化します。MLフレームワークは、基本的なアルゴリズムを理解することなく、MLモデルを簡単に開発できるツール、インターフェース、またはライブラリです。
さまざまな目的に応じた機械学習フレームワークが存在します。ほとんどのMLフレームワークは、ここで説明するもの、しないものを含め、Pythonで記述されています。Pythonは主要な機械学習プログラミング言語です。
MLツールの選択
ツールを選ぶ際には、目標は何かを考える必要があります:機械学習か深層学習か? 深層学習は、データを分析するために多くのタスクを実行するためにニューラルネットワークを使用することを意味します:
- 画像データ
- 言語データ
- 数値データとカテゴリーデータの大規模なデータ
データを使用することで、次のことが可能です:
- 顔検出モデルの作成
- ディープフェイクを使った画像の操作
- 特定のテーマに関するほぼ一貫した記事を生成する
- 人がジムの会員資格をキャンセルする可能性がある時期を予測する
- 特定のレストラン/映画/製品が好きな場合、他に楽しめるものを勧める
一方、機械学習は数学と統計に基づくアルゴリズムに依存してパターンを見つけます。最近のMLフレームワークのチュートリアル、ユースケース、エンジニアリングのほとんどは、画像データベースやテキスト生成または分類で自己訓練するフレームワークを構築することに焦点を当てています。
すべてのMLタスクに対して単一の包括的なAPIを提供しないのはなぜですか?たとえば、画像分類APIを提供して、データサイエンティストが画像データベースをその中にドロップするだけで済むようにすることです。
それは、データサイエンティストが手書き認識のためだけでなく、ビジネスに適用可能な問題を解決するツールに関心があるからです。2020年には、これらのツールに多くの選択肢があります。
人気のある機械学習フレームワーク
おそらく、TensorFlow、PyTorch、scikit-learnは最も人気のMLフレームワークです。しかし、どのフレームワークを使用するかは、実行しようとしている作業によって異なります。これらのフレームワークは、数学と統計モデル(機械学習)を重視しており、ニューラルネットワークのトレーニング(深層学習)とは異なります。
これらの人気のあるMLフレームワークの簡単な内訳は次のとおりです:
- TensorFlowとPyTorchは、類似性から直接的な競合です。どちらも豊富な線形代数ツールを提供し、回帰分析を実行できます。
- scikit-learnは長い間存在しており、Rプログラマーには最も馴染みがありますが、大きな警告があります:クラスター全体で実行するようには構築されていません。
- Spark MLは、Apache Sparkの本質であるクラスターで実行するように構築されています。
さて、特定のフレームワークを見てみましょう。
TensorFlow
TensorFlowはGoogle Brainで開発され、その後オープンソースプロジェクトになりました。TensorFlowは:
- 回帰、分類、ニューラルネットワークなどを実行できます。
- CPUとGPUの両方で実行可能
TensorFlowは現在使用されている事実上の機械学習フレームワークの1つであり、無料です。(Googleはこのライブラリが無料であると考えていますが、MLモデルは生産目的に大きなリソースを使用するため、ツールを実行するためのリソースを販売することで利益を上げています。)
TensorFlowは完全なML研究および製品ツールです。非常に複雑ですが、そうである必要はありません。Excelのスプレッドシートのように、TensorFlowはシンプルに使用することも、より専門的に使用することもできます:
- TFは、与えられたデータセットに対して予測を返したい基本的なユーザーには十分にシンプルです
- TFは、複数のデータパイプラインを設定し、データをモデルに合わせて変換し、モデルのすべてのレイヤーとパラメータをカスタマイズし、ユーザーのプライバシーを維持しながら複数のマシンでトレーニングする高度なユーザーにも対応できます。
TFはNumPy配列を深く理解することを要求します。TensorFlowはテンソルで構成されています。これは、テンソルを処理する方法です。したがって、PythonのNumPyツールです。NumPyは、n次元配列(1次元配列はベクトル、2次元配列は行列、その他)を扱うためのPythonフレームワークです。このように、配列を自動的にワンホットベクトルに変換するなどのタスクは、データサイエンティストが処理しなければなりません。
しかし、TensorFlowには豊富なツールセットがあります。たとえば、ニューラルネットワークの活性化関数は、統計のすべての作業を行うことができます。深層学習をニューラルネットワークを実行する能力と定義するなら、TensorFlowはそれを行います。しかし、回帰などのより日常的な問題も処理できます。
シンプルなTF MLモデルはこのようになります:
    import tensorflow as tf
mnist = tf.keras.datasets.mnist
    (x_train, y_train),(x_test, y_test) = mnist.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0

model = tf.keras.models.Sequential([
  tf.keras.layers.Flatten(input_shape=(28, 28)),
  tf.keras.layers.Dense(128, activation='relu'),
  tf.keras.layers.Dropout(0.2),
  tf.keras.layers.Dense(10, activation='softmax')
])
    model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

model.fit(x_train, y_train, epochs=5)
model.evaluate(x_test, y_test)
シンプルなモデルとより高度なモデルはこちらで見ることができます。
PyTorch
PyTorchはFAIR、Facebook AI Researchによって開発されました。2018年初頭、FAIRチームは別のMLフレームワークであるCaffe2をPyTorchに統合しました。これはTensorFlowの主要な競合相手です。エンジニアがMLプラットフォームを使用するかどうかを決定するとき、一般的にその選択は「TensorFlowを使うかPyTorchを使うか?」ということになります。どちらも目的に応じて機能しますが、かなり互換性があります。
TensorFlowと同様に、PyTorchは:
- 回帰、分類、ニューラルネットワークなどを実行します。
- CPUとGPUの両方で実行します。
PyTorchはよりPythonicであると考えられています。TensorFlowはモデルを迅速に立ち上げ、カスタマイズするのに対し、PyTorchはより伝統的なオブジェクト指向プログラミングアプローチに従って、クラスを構築するためによりカスタマイズ可能であると考えられています。
PyTorchはトレーニング時間が速いことが示されています。この速度は多くのユーザーには微妙ですが、大規模なプロジェクトでは違いを生むことができます。PyTorchとTensorFlowの両方は活発に開発されているため、速度の比較は両者の間で揺れ動く可能性があります。
Torchに対して、PyTorchはPythonを使用し、LuaやLuaパッケージマネージャーを必要としません。
Asad Mahmoodによると、PyTorchモデルはこのようになります:
    import torch
from torch.autograd import Variableclass linearRegression(torch.nn.Module):
    def __init__(self, inputSize, outputSize):
        super(linearRegression, self).__init__()
        self.linear = torch.nn.Linear(inputSize, outputSize)

    def forward(self, x):
        out = self.linear(x)
        return out
    inputDim = 1 # takes variable 'x'
outputDim = 1 # takes variable 'y'
learningRate = 0.01
epochs = 100

model = linearRegression(inputDim, outputDim)
##### For GPU #######
if torch.cuda.is_available():
model.cuda()
    criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=learningRate)
    for epoch in range(epochs):
   # Converting inputs and labels to Variable
   if torch.cuda.is_available():
       inputs = Variable(torch.from_numpy(x_train).cuda())
       labels = Variable(torch.from_numpy(y_train).cuda())
   else:
       inputs = Variable(torch.from_numpy(x_train))
       labels = Variable(torch.from_numpy(y_train))

   # Clear gradient buffers because we don't want any gradient from previous epoch to carry forward, dont want to cummulate gradients
   optimizer.zero_grad()
    # get output from the model, given the inputs
   outputs = model(inputs)

   # get loss for the predicted output
   loss = criterion(outputs, labels)
   print(loss)
   # get gradients w.r.t to parameters
   loss.backward()

   # update parameters
   optimizer.step()

   print('epoch {}, loss {}'.format(epoch, loss.item()))
scikit-Learn
時には、仮説の成功の可能性を測るために、迅速なテストだけが必要です。Scikit-learnはデータサイエンスの世界の古いスタンダードであり、モデルがいくつかの解釈可能性を持つかどうかを確認するために、迅速なMLモデルスケッチを実行するのに良いです。

Scikitは、さまざまな便利な機械学習タスクを実行できる別のPythonパッケージです:
- 線形回帰
- 決定木回帰
- ランダムフォレスト回帰
- K-近傍
- SVM
- 確率的勾配降下モデル
- その他
Scikitは、モデルの性能を評価するための混同行列などのモデル分析ツールを提供します。多くの場合、scikit-learnでMLジョブを開始し、その後別のフレームワークに移動することができます。たとえば、scikit-learnは、カテゴリーデータのワンホットエンコーディングのための優れたデータ前処理ツールを備えています。一度データがScikitを通じて前処理されると、それをTensorFlowやPyTorchに移動できます。
    from sklearn import linear_model

regr = linear_model.LinearRegression()
regr.fit(diabetes_X_train, diabetes_y_train)
print(regr.coef_)
私たちはSpark MLの使用方法について長々と書いてきました。前述のように、Spark MLはクラスターで実行できます。言い換えれば、非常に大きな行列の乗算を処理でき、行列のスライスを取り、その計算を異なるサーバーで実行します。(行列の乗算は、最も重要なML操作の1つです。)それには分散アーキテクチャが必要であり、大量のデータを扱うときにコンピュータがメモリ不足になったり、長時間実行されたりしないようにします。
Spark MLは複雑ですが、NumPy配列を扱う代わりに、Sparkのビッグデータの役割で使用する人が理解するSpark RDDデータ構造を使用できます。そして、Spark MLを使用して、ほとんどのPythonプログラマーが知っているSpark SQLデータフレームで作業することもできます。したがって、MLアルゴリズムにフィードするデータの準備の一部の複雑さを取り除き、密なスパークフィーチャー-ラベルベクトルを作成します。
2019年1月、YahooはTensorFlowOnSparkをリリースしました。このライブラリは「TensorFlow深層学習フレームワークの重要な機能をApache SparkおよびApache Hadoopと統合します。TensorFlowOnSparkは、GPUおよびCPUサーバーのクラスターで分散深層学習を可能にします。」このパッケージは、ビッグデータと機械学習を大規模な製品ユースケースのための使いやすいMLツールに統合します。
Spark MLモデルは、ScalaまたはJavaで記述され、TensorFlowコードに似た宣言的な形式です:
    // Build the model with the desired layers
val training = sparkContext.parallelize(Seq(
  LabeledPoint(1.0, Vectors.dense(0.0, 1.1, 0.1)),
  LabeledPoint(0.0, Vectors.dense(2.0, 1.0, -1.0)),
  LabeledPoint(0.0, Vectors.dense(2.0, 1.3, 1.0)),
  LabeledPoint(1.0, Vectors.dense(0.0, 1.2, -0.5))))
val lr = new LogisticRegression()
    // We may set parameters using setter methods.
lr.setMaxIter(10)
  .setRegParam(0.01)
    // Train a LogisticRegression model.  This uses the parameters stored in lr.
val model1 = lr.fit(training)
Torch

Torchは最も簡単なMLフレームワークであると主張しています。これは2002年に最初にリリースされた古い機械学習ライブラリです。
以前は、PyTorchを使用して、PythonがTorchが計算を実行する基本テーブルにアクセスするための選択された方法でした。Torch自体は、Luaを使用して、LuaRocksパッケージマネージャーで使用できます。Torchの相対的な単純さは、そのLuaプログラミング言語インターフェースによるものです(QTやiPython/Jupyterなどの他のインターフェースやC実装もあります)。Luaは確かにシンプルです。浮動小数点数や整数はなく、数値だけです。そして、Luaのすべてのオブジェクトはテーブルです。したがって、データ構造を作成するのは簡単です。そして、テーブルをスライスしたり、追加したりするための理解しやすい機能の豊富なセットを提供します。
TensorFlowと同様に、Torchの基本データ要素はテンソルです。torch.Tensorと書くことで作成します。CLI(コマンドラインインターフェース)はインラインヘルプを提供し、インデントを手助けします。Pythonを使用したことのある人は安心します。これは、間違いを犯したときに最初からやり直す必要なく、その場で関数を入力できることを意味します。そして、複雑さとスパースコードが好きな人のために、Torchは関数型プログラミングをサポートしています。
新しいMLフレームワークタイプ
機械学習の世界はライブラリで豊かです。以前に述べたライブラリのいくつかを基にした高レベルのライブラリが存在し、データサイエンティストのために機械学習を容易にします。
huggingface.co
トップ機械学習ライブラリの1つは、huggingface.coであり、TensorFlowとPyTorchの上に構築された良い基盤モデルを研究者のために作成します。彼らは、GPT-2のような複雑なツールを、あなたの機械で簡単に動作するように適応させます。
Kerasは、MLモデリングを簡素化するためにTensorFlowの上に構築されたニューラルネットワークライブラリです。すべてのステップを簡素化し、KerasはCPUまたはGPUで動作するために同じコードを使用できます。
KerasはTensorFlowに限定されていませんが、最も一般的にそこに使用されます。Kerasは次のものでも使用できます:
- Microsoft Cognitive Toolkit (CNTK)
- R
- Theano
- PlaidML
追加リソース
機械学習の詳細については、BMC機械学習&ビッグデータブログやこれらのリソースを探索してください:
これらの投稿は私自身の見解であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。