




ポイント: Pandasにおける欠損データの処理は、NaN値を理解し、fillna()、dropna()、およびinterpolate()のような関数を利用して効果的に管理することを含みます。
- NaNは欠損データを表し、Noneとは異なります。
- 方法には行または列を削除するか、適切に値を埋めることが含まれます。
適用データサイエンスでは、通常、欠損データがあります。たとえば、センサーを備えた産業用アプリケーションでは、特定の日にセンサーデータが欠落することがあります。
欠損データを扱う方法はいくつかあります。次のようにできます:
- 行全体を削除する
- 行-列の組み合わせにいくつかの値を埋める
列を削除することは意味がないでしょう。すべての行に対してそのメトリックを捨てることになるからです。では、これらのシナリオをどのように処理するか見てみましょう。
NaNは欠損データを意味します
欠損データはNaNとしてラベル付けされます。
np.nanはPythonのNoneとは等しくないことに注意してください。また、np.nanはnp.nanとも等しくありません。np.nanは基本的に未定義を意味します。
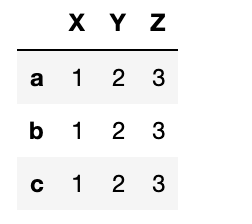
ここでは、3列3行のデータフレームを作成します。配列np.arange(1,4)は各行にコピーされます。
結果:
nat
    import pandas as pd
import numpy as np
df = pd.DataFrame([np.arange(1,4)],index=['a','b','c'],
columns=["X","Y","Z"])
結果:
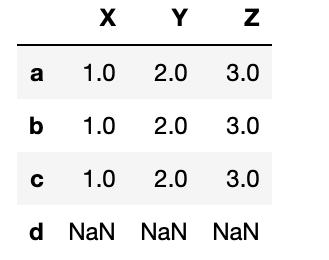
今、インデックスdを追加してこの配列を再インデックスします。dには値がないので、NaNで埋められます。
df.reindex(index=['a','b','c','d'])
isna
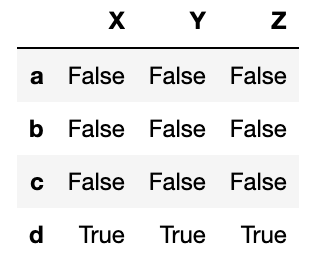
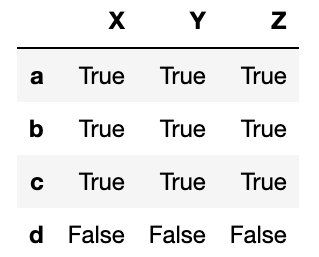
今、isnaを使って欠損値をチェックします。
pd.isna(df)
notna
反対のチェック—実際の値を探す—はnotna()です。
pd.notna(df)
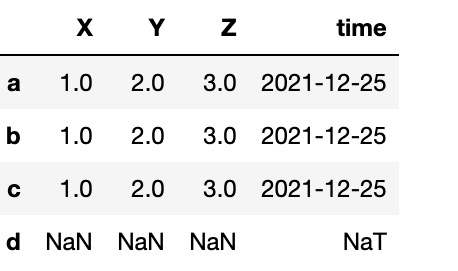
natは欠損日を意味します。
    df['time'] = pd.Timestamp('20211225')
df.loc['d'] = np.nan
fillna
ここでは、整数1を使用してNaN値を埋めることができます。fillna(1)。日付列は整数1が日付ではないため、変更されません。
df=df.fillna(1)
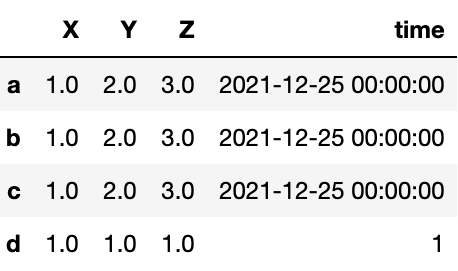
それを修正するには、空の時間値を次のように埋めます:
df['time'].fillna(pd.Timestamp('20221225'))
dropna()
dropna()は、値が空の行または列を削除することを意味します。別の言い方をすれば、空でない行または列のみを表示することです。
ここでは、行cをNaNで埋めます:
    df = pd.DataFrame([np.arange(1,4)],index=['a','b','c'],
columns=["X","Y","Z"])
df.loc['c']=np.NaN
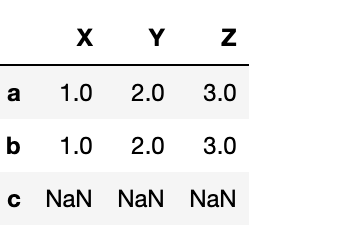
次に、行(axis=0)に対してdropnaを実行します。
df.dropna()
次のように書くこともできます:
df.dropna(axis=0)
cを除くすべての行が削除されました:
列を削除するには:
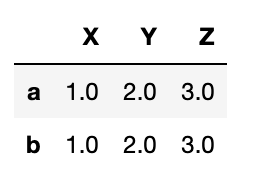
列を削除するには:
    df = pd.DataFrame([np.arange(1,4)],index=['a','b','c'],
columns=["X","Y","Z"])
df['V']=np.NaN
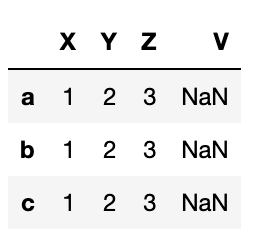
df.dropna(axis=1)
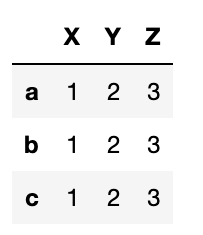
Pandasのもう一つの機能は、論理的な方法で欠損値を埋めることです。
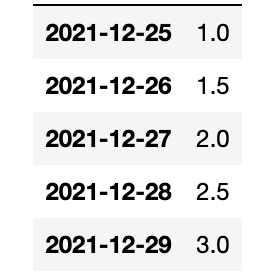
時系列を考えてみましょう。特定の日に機械を監視しているとしましょう。機械はクリスマスとその週の他の日に報告します。その後、Pandasシリーズを再インデックスして、タイムラインにギャップを作成します。
    import pandas as pd
import numpy as np
arr=np.array([1,2,3])
idx=np.array([pd.Timestamp('20211225'),
pd.Timestamp('20211227'),
pd.Timestamp('20211229')])
df = pd.DataFrame(arr,index=idx)
idx=[pd.Timestamp('20211225'),
pd.Timestamp('20211226'),
pd.Timestamp('20211227'),
pd.Timestamp('20211228'),
pd.Timestamp('20211229')]
df=df.reindex(index=idx)
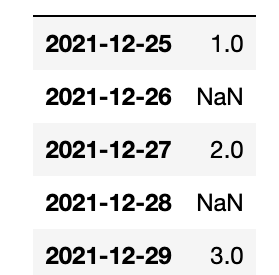
補間
私たちはinterpolate()関数を使用します。Pandasは、ポイント間の中間点を使用して、それらをうまく埋めます。もちろん、これは曲線であれば、その関数を適合させ、別の方法で平均を見つけるでしょう。
df=df.interpolate()
これでこのチュートリアルは終了です。
関連する読み物
Pandasガイド
これらの投稿は私自身の意見であり、BMCの立場、戦略、または意見を必ずしも表すものではありません。