




ポイント: フィーチャーストアは、モデルのトレーニングと推論に重要なデータを管理することでMLOpsを強化し、コラボレーションとデータ品質を向上させます。ワークフローを合理化し、データのアクセス性と共有をサポートします。
- フィーチャーストアは、データの変換、ストレージ、モデルへのフィーチャー提供を促進します。
- 重複を減らし、規制遵守を確保し、開発を加速します。
フィーチャーストアは機械学習のワークフローとMLツールに含まれます。フィーチャーストアはデータと機械学習モデルの間に位置します。
フィーチャーストアとは何ですか?
フィーチャーストアは、特に機械学習運用(MLOps)のためにデータを管理する方法です。
MLOpsの簡単な説明は、AIモデルをデプロイ、実行、トレーニングするために結集しなければならないすべてのエンジニアリング要素です。そのため、MLOpsは以下の重要な要素を織り交ぜます:
- 機械学習
- DevOps
- データエンジニアリング
フィーチャーストアを使用することで、MLチームの職人技が向上します。なぜなら、彼らのデータ—どのMLモデルでも生命線である—がより簡単に見えるからです。
(私たちの機械学習とAIの比較を読んでください。)
フィーチャーストアの仕組み
データはどこかのサーバーに快適に格納されていました。データサイエンティストは分析に必要なときにデータにアクセスしていました。または、ユーザーがサーバーにクエリを実行してデータを表示していました。
しかし、ビッグデータの時代では、このようなデータストレージとリコールはもはや実現可能ではありません。
機械学習、そしてAIシステムの構築は、異なる種類のユースケースを提示します:異なるデータをそのソースから引き出し、標準的なフィーチャーセットを作成するために変換し、結合する必要があります。
チームはMLモデルを本番環境に投入する際に挑戦に直面します。Tecton.aiの共同創設者であり、UberのMichelangelo MLプラットフォームの作成者であるMike Del Bascoは、チームが直面するこれらの課題を述べています:
- 適切な生データにアクセスする
- 生データからフィーチャーを構築する
- フィーチャーをトレーニングデータに結合する
- 本番環境でフィーチャーを計算して提供する
- 本番環境でフィーチャーを監視する
フィーチャーストアは、MLワークフローによって要求されるデータの複雑さの増大に関する問題を解決します。データサイエンティストは、簡単に次のことができる必要があります:
- データの有効性を検証する
- その品質を確認する
- 新鮮であることを知る
- データのバージョンを管理し、他の人と共有する
フィーチャーストアは、MLモデルとデータソースの間に位置し、機械学習チームが必要とするアクセス性を提供します。
データストレージ
監視
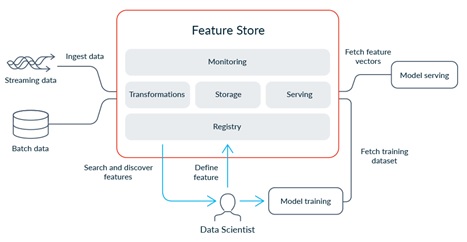
フィーチャーストアはチームを助けます:
- より良いコラボレーション
- 重複を減らす
- より良い規制遵守
- より迅速な開発
データがMLモデルの基本的なコンポーネントである場合、フィーチャーストアはチームの能力を高めます:
- データについてコミュニケーションする
- よりユニークなMLモデルを作成する。
フィーチャーストアの主要機能
Feastは、GoogleとGojekとのコラボレーションで構築されたオープンソースのフィーチャーストアプロジェクトです。GoogleデプロイメントにはAPIを介してアクセスします。FeastはRedisに基づいて構築され、Big Queryをストレージに使用します。
今日、Feastはすべての主要なプラットフォームで運営されています。それでも、その設計実践はフィーチャーストアで探すべき良いモデルです。したがって、フィーチャーストアの主要な機能とコンポーネントを探求しましょう。
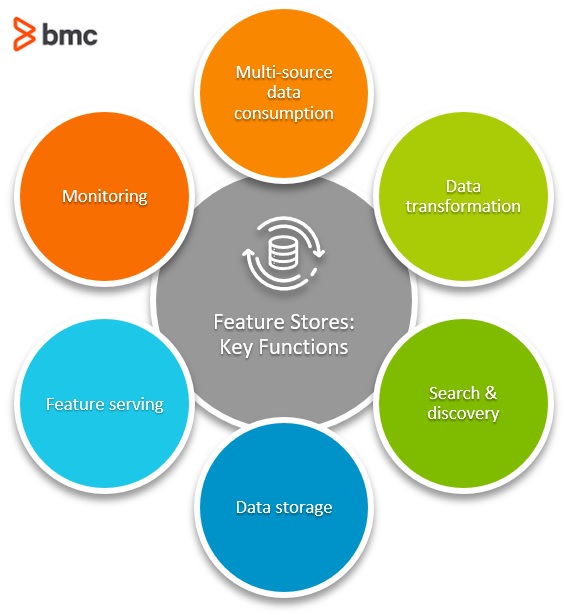
マルチソースデータ消費
フィーチャーストアはアップストリームソースからデータをロードします。データは多くのソースから来ます。フィーチャーはこれらのソースから抽出され、フィーチャーセットに結合される必要があります。
フィーチャーストアは多くのソースから読み取ることができる必要があります。フィーチャーストアは次の方法でデータをロードできます:
- さまざまなストリーム
- データウェアハウス
- データファイル
データ変換
フィーチャーストアの重要な利点は、異なるタイプのフィーチャーを同じモデルで簡単に使用できることです。
データサイエンティストは異なるソースからデータを引き出し、フィーチャーストアはモデルがデータを一貫した方法で結合または変換できるようにします。アクションが完了し、成功裏に完了したことを監視します。
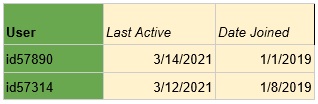

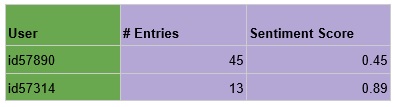
異なるソースからフィーチャーセットを作成するだけでなく、データはモデルをサポートするためにさまざまな方法で変換されます。1つの方法は、データにワンホットエンコーディングまたはラベリングを行うこと、またはテキストデータをエンコーディングしてモデルが処理できるようにすることです。
フィーチャーストアは、データがモデルに提供される前にステップが正常に完了したことを確認するために、適切な分析と監視を通じてこれらの変換の一貫性を検証します。
検証ステップがなければ、古く不完全なデータでモデルをトレーニングし、製品化する可能性があります。
検索と発見
フィーチャーストアの主要な設計上の考慮事項は、チーム間のコラボレーションを促進することです。1つのフィーチャーセットが作成され、モデルでうまく機能する場合、そのセットが他のモデルで共有および消費されることを目指します。
良いフィーチャーストアは、フィーチャーが標準化され、すべてのチームのモデル間で一貫性が保たれるように、セットを共有する方法を持っている必要があります。
フィーチャーストアは、データソースからデータが通過する際に、オンラインまたはオフラインでデータをどこかに保存する必要があります。
Tecton.aiから:
- “オフラインストレージレイヤーは、トレーニング目的で数ヶ月または数年分のフィーチャーデータを保存するために一般的に使用されます。 オフラインフィーチャーストアデータは、通常、データウェアハウスやデータレイク(S3、BigQuery、Snowflake、Redshift)に保存されます。オフラインフィーチャーストレージのために既存のデータレイクやデータウェアハウスを拡張することが一般的に好まれ、データサイロを防ぎます。
- オンラインストレージレイヤーは、推論中の低遅延ルックアップのためにフィーチャー値を永続化するために使用されます。 それらは通常、各エンティティの最新のフィーチャー値のみを保存し、実質的に世界の現在の状態をモデル化します。オンラインストアは通常、最終的一貫性がありますが、ほとんどのMLユースケースに対して厳密な一貫性の要件はありません。通常、DynamoDB、Redis、またはCassandraのようなキー・バリューストアで実装されます。
フィーチャー提供
フィーチャーストアは、異なるモデルにフィーチャーを提供できる必要があり、このためのツールは通常APIを介して行われます。
モデルは、提供されるフィーチャーがモデルが要求する要件に合致することを確認できるため、一貫性が必要です。
最後に、コードのブロックに常に存在する懸念は、フィーチャーストアを監視する能力を統合することです。フィーチャーストアは、データに関する多くのメトリクスを提供し、それを通過するデータセットの完全性、正確性、および品質を発見できます。
監視は、システムの更新、エラー時のデバッグ、複雑さの進化を助けます。
フィーチャーストアの始め方
MLチームが大きくなると、データを維持する方法を見つけることが必要になります。AIを利用する大企業のほとんどは、すでに内部フィーチャーストアを構築しています:Google、Uber、Facebook、Amazon、Salesforceなど。
今、それらのツールは新しい企業がAIの旅を進めるためのMLaaSになりつつあります。
以下は、自分のフィーチャーストアを開発するためのツールです:
- Tecton.ai
- Feast.ai(オープンソースフィーチャーストア)
- Amazon Sagemaker
- Molecula
- Feast/Kubeflow統合
MLOpsの成長にはさらなるニーズがある
フィーチャーストアは、大規模なML Opsチームの新たな必要性の1つに過ぎません。MLOpsの分野には高い運用レベルでの高い要求があります。真のMLOpsには、次のことができる必要があります:
- データアクセスとデータ品質を容易にする。
- モデルの開発を開始からトレーニング、提供まで追跡する。
- モデルが本番環境に提供されたときの成功を監視する。
一般的に、ML業界は3つの主要な分野にグループ化されています:
フィーチャーストアはこれらのグループにうまくフィットします。
関連する読み物
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を表すものではありません。