




ポイント: Amazon DynamoDBは、高性能とトランザクションサポートを備えたスケーラブルなキーバリュー型NoSQLデータベースであり、JSONのようなデータ構造を利用しています。効率的なクエリと更新を可能にし、シームレスな統合のためのさまざまなSDKを提供します。
- DynamoDBはトランザクションをサポートし、操作中のデータの一貫性を確保します。
- 統合オプションには、データ処理のためのAmazon GlueおよびApache Hiveが含まれます。
DynamoDBは、Amazonが開発したキーバリュー型のNoSQLデータベースです。他の製品と異なるのは、オープンソースのシステムでなく、Amazonの内部ニーズのために書かれ、顧客に提供されていることです。
DynamoDBはどのように機能しますか?
DynamoDBはJSONのように見えますが、1つの違いは、各JSONレコードがレコードキーを含む必要があることです。これにより、レコードの更新が可能になります。JSONデータベース(例:MongoDB)では、レコードの更新はできず、削除して変更版を再追加する必要があります。
DynamoDBは、MongoDBもサポートしているトランザクションを扱うことができます。すべてのNoSQLデータベースがこれを許可しているわけではありません。これは、特定のデータベース操作が論理的に一緒に行う必要があるため重要です。たとえば、販売トランザクションでは、在庫が減少し、現金が増加する必要があります。これらの2つの操作のいずれかが失敗した場合、販売と在庫システムは不均衡になります。
AWSコマンドラインクライアント、さまざまなプログラミング言語用のAPI、NoSQLワークベンチデスクトップツール、またはAmazon AWSウェブサイトを使用してデータベースと作業します。以下の画面は、テーブルを作成する方法を示しています。
キーだけを作成することに注意してください。これはJSONであるため、構造やスキーマがないからです。したがって、他の属性は何でも可能です。
DynamoDBの定義
DynamoDBには、これらの概念が含まれます:
- テーブル: アイテムのコレクション
- アイテム: 属性のコレクション(他のデータベースではこれをレコードまたはドキュメントと呼びます。)
- ストリーム: メモリ内で変更を保持するキャッシュのようなものです。
- パーティションキー: プライマリキー。ユニークである必要があります。
- パーティションキーおよびソートキー: 複合プライマリキー、つまり、従業員名と従業員IDのように、複数の属性を持つパーティションキー(同じ名前の2人の従業員がいる可能性があるため必要です)。
- セカンダリインデックス: よくクエリする他の属性をインデックス化して読み取りを高速化できます。
APIとSDK
ほとんどのクラウドシステムと同様に、DynamoDBはウェブサービスを介してサービスを公開します。しかし、データをJSON形式にフォーマットしてからHTTPを使用して投稿する必要はありません。代わりに、ソフトウェア開発キット(SDK)を提供しています。SDKは、送信されたリクエストを受け取り、裏でHTTP呼び出しに変換します。このようにして、SDKはデータベースと作業するための、より自然で、はるかに簡潔な方法を提供します。SDKを使用すれば、DynamoDBを通常のオブジェクトのように扱うことができます。
SDKにはこれらのメソッドがあります:
- PutItem
- BatchWriteItem
- GetItem
- BatchGetItem
- Query
- Scan
- UpdateItem
- DeleteItem
- ListStreams
- GetShardIterator
- GetRecords
- TransactWriteItems
- TransactGetItems
AWS CLI
他のAmazon製品と同様に、AWSコマンドラインクライアントを使用できます。これにより、プログラムを記述せずにコマンドラインからデータベース操作を実行できます。JSONを使用してDynamoDBと作業します。
たとえば、以下の操作とその他いくつかがあります:
- aws dynamodb create-table
- aws dynamodb put-item
SDK
DynamoDBは以下のプログラミング言語に対してSDKを提供しています:
- Java
- JavaScript
- .NET
- js
- PHP
- Python
- Ruby
- C++
- Go
- Android
- iOS
Javaと.NETの場合、オブジェクトを提供しています。これにより、テーブルのアイテムをそれらのプログラミング言語のオブジェクトのように扱うことができます。データ型の変換も行い、たとえば、日付やバイトを文字列や数値に制限されることなく使用できます。
たとえば、Javaではこの@annotationを追加すると、テーブルをJavaオブジェクトのように扱うことができます。これにより、SQLやJSONのような冗長なことをする必要がなくなります。
    @DynamoDBTable(tableName = "ProductCatalog")
    public static class CatalogItem {
        private Integer id;
        private String title;
        private String ISBN;
        private Set bookAuthors;
DynamoDBはダウンロード可能
DynamoDBをダウンロードしてローカルシステムで実行することもできます。彼らのウェブサイトでは、これが無料で使用できるかどうか、つまり永遠に支払わずに使用できるかどうかは言及されていません。このアイデアは、コードをローカルでテストするために使用し、クラウドにコミットする前にコストを節約することです。
たとえば、JavaプロジェクトにMaven依存関係として追加できます。これにより、コードエディタでJavaコードを実行すると、DynamoDBがダウンロードされ、ほとんど設定なしでインスタンスが起動します。
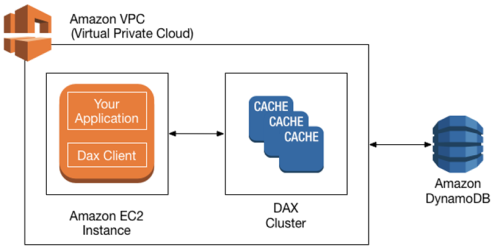
Amazon DynamoDB Accelerator (DAX)
DAXは、DynamoDBをインメモリデータベースに変えるオプションの機能です。
他のシステムとの統合
- Amazon Glue。 この場合、DynamoDBからAmazon Glueにデータを引き出します。そこでETLを行い、Amazon Redshiftデータウェアハウスなどの他のシステムに書き出します。
- Apache Hive on Amazon EMR。 これは主に双方向インターフェースです。これを使用して、たとえば、HiveQL(Hive SQL言語)を使用してDynamoDBテーブルをクエリできます。また、Hadoopにデータをコピーできます。(HiveはHadoopの上に乗っかり、EMRをサポートします。)また、DynamoDBテーブルをHiveで結合することもできます。
クォータ
DynamoDBユーザーは、Amazonによってクォータの対象となります。これらはキャパシティユニットで示されています。ユーザーは追加のクォータを要求できます。たとえば、1つの書き込みトランザクションでは、1キャパシティユニット = 1秒あたり1回の書き込み(最大1KB)です。
トランザクション、読み取り、ストリーム操作もすべてキャパシティユニットです。
価格
EC2と同様に、オンデマンドおよびプロビジョンド(つまり、専用)リソースには別々の価格があります。プロビジョンドインスタンスの場合、書き込みキャパシティユニットは$0.00065です。読み取りは$0.00013です。
ストレージ価格は、Amazonデータセンターによって異なります。オハイオのUS-Eastは25GBあたり$0.25です。
DAXは時間単位で料金が設定され、仮想CPUとメモリサイズによって異なります。たとえば、1 vCPUと1.5GBのメモリは、時間あたり$0.04です。
追加リソース
このトピックについての詳細は、BMCビッグデータ&機械学習ブログを探索するか、以下のリソースをチェックしてください:
- AWSガイド、AWSに関する15以上の記事とチュートリアル
- AWS、Azure&GCPの可用性リージョンとゾーン
- AWS上のデータベース:マルチクラウドの世界でのクラウドデータベースの位置付け
- データベースの信頼性の紹介
- MongoDBガイド&Apache Cassandraガイド、それぞれに記事とチュートリアルがあります。
DynamoDBガイド
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも代表するものではありません。