




ポイント: 辞書からPandasデータフレームを作成するのは簡単で、DataFrameコンストラクタやfrom_dict()などのメソッドを使用します。これらのアプローチにより、ユーザーは指定された列名とさまざまな向きでデータフレームを作成できます。
- 辞書からデータフレームを作成するための2つの方法が詳述されています。
- 適切なPythonとPandasのバージョンとの互換性が重要です。
Pandasがどれほど便利で強力であるかの別の例を示します。Pandasは、多くの種類のデータ構造からデータフレームを作成できます。これにより、長いコードを書くことなく、辞書からデータフレームを作成する方法をこのチュートリアルで2つのアプローチで示します。
Pandasのバージョンについて
始める前に、Pythonをアップグレードして少なくとも3.7にしてください。Python 3.4では、利用可能なPandasの最高バージョンは0.22であり、すべてのケースで辞書を作成する際に列名を指定することをサポートしていません。virtualenvを実行している場合は、新しいPython環境を作成し、次のようにPandasをインストールします。
    virtualenv py37  --python=python3.7
pip install pandas
Pandasのバージョンを確認できます:
    import pandas as pd
pd.__version__
PandasのDataFrameコンストラクタでデータフレームを作成する
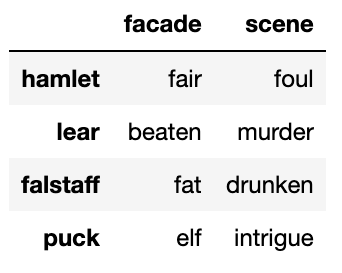
ここでは、辞書からPandasデータフレームを構築します。Pandasコンストラクタを使用します。これは、さまざまなデータ構造を処理できるからです。以下の辞書には、sceneとfacadeの2つのキーがあります。各値には4つの要素の配列があり、2列4行のテーブルとして自然にフィットします。Pandasは行と列のデータで作業するように設計されています。各行には行インデックスがあります。デフォルトでは、0、1、2、3の数字です。名前を使用することもできます。したがって、配列idxで同じことを使用しましょう。
    import pandas as pd

dict =  {'scene': ["foul", "murder", "drunken", "intrigue"],

'facade': ["fair", "beaten", "fat", "elf"]}

idx = ['hamlet', 'lear', 'falstaff','puck']

dp = pd.DataFrame(dict,index=idx)
これが結果のデータフレームです:
辞書からPandasのfrom_dict()メソッドでデータフレームを作成する
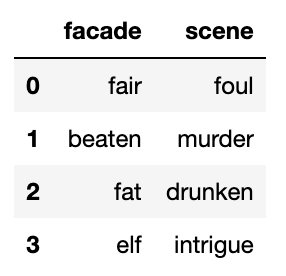
PandasにはPandas.DataFrame.from_dict()メソッドもあります。それが繰り返しのように聞こえるかもしれませんが、通常のコンストラクタは辞書とともに機能するので、以下の例から、from_dict() メソッドが辞書に特有のパラメータをサポートしていることがわかります。コード内で、辞書のキーは列です。行インデックスは数字です。それがデフォルトの向きであり、orient='columns'は辞書のキーを列として取得し、値を行に配置することを意味します。
pd.DataFrame.from_dict(dict)
今、私たちはそれを横にひっくり返します。 行を辞書のキーにします。
pd.DataFrame.from_dict(dict,orient='index')
列には名前がなく、数字だけです。それはあまり役に立たないので、以下でcolumnsパラメータを使用します。これはPandas 0.23で導入されました。
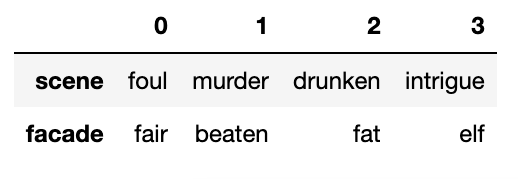
列名を配列に入れて、それをcolumnsパラメータとして渡すのは簡単です。なぜ以前のバージョンのPandasにそれがなかったのか不思議です。
    pd.DataFrame.from_dict(dict,orient='index',columns=idx)

hamlet    lear falstaff      puck

scene    foul  murder  drunken  intrigue

facade   fair  beaten      fat       elf
関連する読み物
- BMC機械学習とビッグデータブログ
- Pandas: CSVおよびJSONファイルの読み取り方法
- Apache Sparkガイド、一連のチュートリアル
- Snowflakeガイド
- PythonでRedshiftユーザー定義関数(UDF)を作成する
Pandasガイド
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を表すものではありません。