




ポイント: Amazon Redshift で SQL ステートメントを書くことは、データ分析のためにクエリエディタを利用する方法を説明し、集約や結果のエクスポートなどの基本的な SQL コマンドに焦点を当てます。また、クラウドデータウェアハウスとしての Amazon Redshift の機能についても説明します。
- SQL コマンドを実行するためにクエリエディタを使用します。
- 大規模データセットを管理するための Amazon Redshift の機能を理解します。
このチュートリアルでは、Amazon Redshift SQL ステートメントの書き方を示します。このトピックは大きく複雑なため、基本から始めます。
このチュートリアルでは、以下のことを示します:
- クエリエディタの使用
- グループ化を使用して行を集約する
- 日付を年と月に変換する
- 結果を CSV ファイルにエクスポートする
Amazon Redshift とは?
Amazon Redshift は、SQL ベースの Amazon Web Services クラウドデータウェアハウスです。大規模なデータセットと複雑なクエリを処理するように設計されています。データウェアハウジング、ビジネスインテリジェンス、ビッグデータ分析、機械学習、および Extract-Load-Transform ワークフローに最適です。
Redshift のコンポーネントには、以下が含まれます:
- クラスターは、接続を管理し、クエリを調整するリーダーノードを中心に編成されたコンピュータノードです。
- スライスは、効率的で大規模な並列処理のためにメモリ、処理、およびディスクスペースリソースを割り当てるノードの区分です。
- データ配布方法論は、キー値に従ってまたはすべてのノードに均等にデータを割り当てます。
- データのカラムストレージは、I/O(入出力)を削減し、より効率的なストレージのために垂直スタックで行われます。
- 実行エンジンは SQL クエリをサポートし、データを取得し使用する最良の方法を計画します。
- Spectrum は、Amazon S3 のデータを Redshift 環境に取り込むことなくクエリできる Amazon Redshift サービスです。
- 統合データローディングは、さまざまな Amazon およびサードパーティのツールを使用します。
- バックアップと復元は、回復力を追加します。
- セキュリティは、アイデンティティとアクセスを制御し、パターン認識と事後の応答のためのログを提供します。
- メンテナンスと監視は、この完全管理サービスに内在しており、あなたのチームの継続的な管理負担を軽減します。
Redshift クエリエディタ
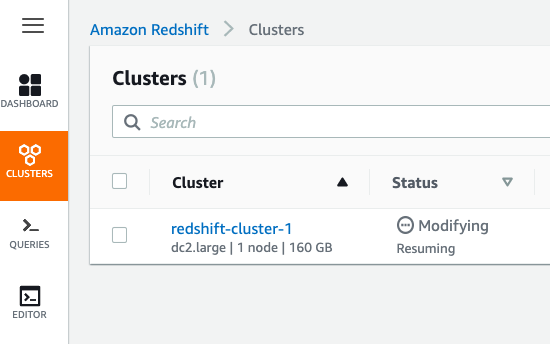
クエリエディタを開くには、クラスター画面からエディタをクリックします。Redshift はデータベースへの接続のために認証情報を求めます。便利な機能の一つは、一時的な認証情報を生成するオプションがあるため、パスワードを覚えておく必要がないことです。Amazon AWS コンソールへのログインがあれば十分です。
以下に、停止状態から再開するクラスターがあります(Amazon の請求額を削減するため)。
ここに SQL ステートメントを書きます。一度に許可されるのは1つのステートメントのみで、Redshift は同時に1セットの結果しか表示できません。複数のステートメントを書くには、プラス(+)をクリックして追加のタブを追加します。
各クエリを実行すると、ジョブを提出して実行するのに数秒かかります。したがって、他の製品で期待されるような瞬時ではありません。
結果は下部に表示され、CSV、TXT、または HTML としてエクスポートできます。結果をチャート化することもできます。

テーブルスキーマを取得
このチュートリアルでは、天気データのテーブルを使用します。(S3 から Amazon Redshift にデータをロードするを参照してください。)これは、キプロスのパフォスに関する20年間の天気データです。4つの列があります:
- dt_iso
- temp
- temp_min
- temp_max
dt_dso の型は timestamp であり、主キーです。Redshift の素晴らしい点の一つは、日付をほぼ任意の形式でロードでき、Redshift がそれを理解することです。次に、Redshift は日付の任意の部分を印刷するための to_char() 関数を提供します。
テーブルスキーマを見るには、pg_table_def テーブルを照会します。
こちらがスキーマです。
    SELECT *

FROM pg_table_def

WHERE tablename = 'paphos'

AND schemaname = 'public';
こちらがスキーマです。
    schemaname,tablename,column,type,encoding,distkey,sortkey,notnull

public,paphos,dt_iso,timestamp without time zone,none,t,1,t

public,paphos,temp,real,none,f,0,f

public,paphos,temp_min,real,none,f,0,f

public,paphos,temp_max,real,none,f,0,f
SQL ステートメントを集約
このクエリは、5月から9月までの夏の月ごとの平均気温を計算します。注意してください:
- to_char() は、YYYY年やMM月番号など、日付の任意の部分を抽出します。
- 月を選択するために in() ステートメントを使用します。
- オーダーステートメントは 1 を使用します。これは、クエリによって返された最初の列を使用することを意味します。これは、列名を入力する代わりの方法です。
- 年と月でグループ化します。これは、年ごとの月の平均を計算するためです。
- round() 関数を使用して、小数点以下2桁に丸めます。さもなければ、Redshift は小数点以下を多く表示します。
- 他のデータベースと同様に、as ステートメントを使用して計算結果の列にエイリアスを付けます。そうでなければ、列には説明的な名前が付きません。ここでは、平均気温を aveTemp と呼びます。
    select round(avg(temp),2) as aveTemp,

                 to_char(dt_iso,'YYYY') as year,

                 to_char(dt_iso,'MM') as month

                 from paphos where

                 month in ('05','06','07','08','09')

                 group by year, month

                 order by 1 desc
こちらが結果です。これは、20年間のデータの最も暑い月を示しています。表示を短くするためにカットオフしています。例えば、20年間の中で、2010年8月が最も暑い月でした。
年ごとにグループ化し、日々の天気観測を元に年内の月を求めました。
| avetemp | 年 | 月 |
| 84.11 | 2010 | 8 |
| 83.12 | 2012 | 8 |
| 83.05 | 2012 | 7 |
| 82.9 | 2015 | 8 |
| 82.39 | 2017 | 7 |
| 82.04 | 2014 | 8 |
| 81.85 | 2007 | 7 |
| 81.73 | 2020 | 9 |
| 81.72 | 2013 | 8 |
| 81.72 | 2008 | 8 |
| 81.62 | 2000 | 7 |
| 81.61 | 2009 | 8 |
| 81.49 | 2017 | 8 |
結果を右側のボタンを使用して CSV 形式にエクスポートします。その後、スプレッドシートにインポートして、結果をより簡単に見ることができるようにし、色をつけたりします。
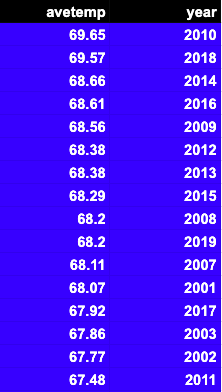
こちらが最も暑い年です。集約から月を削除することで得られます。
    select round(avg(temp),2) as aveTemp,

                 to_char(dt_iso,'YYYY') as year

                                    from paphos

                                                group by year

                 order by 1 desc
追加リソース
このようなチュートリアルの他のリソースを探すには、以下を探ってください:
Amazon Redshiftガイド
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。