




ポイント: ニューラルネットワークは、データを処理し意思決定を行うために、重みを調整して損失を減少させることを模倣します。手書きや顔認識などのタスクで優れた性能を発揮します。
- ニューラルネットワークは、バイナリ入力を用いて高い精度を達成するためにパーセプトロンを利用します。
- トレーニングは、重みの調整を通じて損失関数を最小化することを含みます。
私たちは、ニューラルネットワークについて議論することによって、機械学習をより深く探求したいと考えています。それを行うために、TensorFlowを使って手書きを認識する方法を説明します。しかし、その前にニューラルネットワークとは何かを理解する必要があります。
私たちは、線形モデルに基づく議論を始め、マイケル・ニールセンによって書かれた この本 からいくつかの導入資料を引きます。これは TensorFlow によって推奨されています。
ニューラルネットワークとは?
TensorFlowを使ってニューラルネットワークを操作する方法の議論を始めるために、まずは ニューラルネットワーク とは何かを議論する必要があります。
ここで何度も見てきた線形回帰問題を考えてみましょう。私たちには 損失関数の概念があります。ニューラルネットワークは、損失関数を最小化することで問題の正しい答えに近づきます。
たとえば、この単純な線形方程式を考えてみましょう: y = mx + b。これは、xの値が与えられた場合のyの値を予測します。
予測モデルは常に100%正しいわけではありません。誤りの程度は損失として測定されます。機械学習の目標は、トレーニングセットを使用して損失関数を最小化することです。これは線形回帰、ニューラルネットワーク、その他のMLアルゴリズムにも当てはまります。
たとえば、m = 2、x = 3、b = 2とすると、予測されるyの値はy = 2 * 3 + 2 = 8です。しかし、実際の観測値は10です。したがって、損失は10 - 8 = 2です。
パーセプトロンとは?
ニューラルネットワークでは、同じ基本原則が適用されますが、入力はバイナリで出力もバイナリです。計算を行うオブジェクトは パーセプトロンです。これは、モデルが非常に正確になるまで損失関数を最小化するように自分自身を調整します。たとえば、手書きの分析を99%の精度で実現できます。
ニューラルネットワークは、人間の脳が機能するのと同じように設計されています。手書き認識や顔認識の場合、脳は非常に迅速にいくつかの決定を下します。たとえば、顔認識の場合、脳は「女性か男性か?黒人か白人か?年老いているか若いか?傷はあるか?」のように始まります。
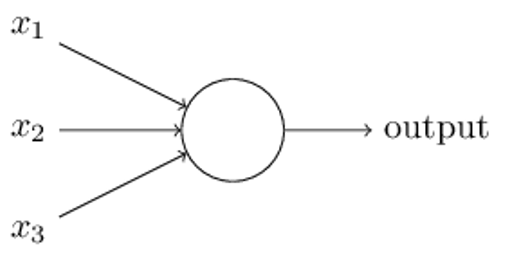
マイケル・ニールセンは、彼の本の中でこれを以下の図のように説明しています。これらのすべての入力(x1、x2、x3)は、パーセプトロンに投入されます。それはその後、はいまたはいいえの決定を下し、次の決定のために次のパーセプトロンに渡されます。このプロセスは最終的なパーセプトロンまで繰り返されます。この時点で、私たちは手書きが何であるか、または私たちが見ている顔が誰であるかを知ります。
小さな例を使って説明しましょう。このトピックは複雑なので、ここでは最初の概念を紹介し、次の投稿でさらに進めます。
先ほど述べたように、 パーセプトロン はバイナリ入力を受け取りバイナリ出力を生成するオブジェクトです。それは、結果がはい(1)またはいいえ(0)であるべきかを決定するために、重み付き合計としきい値を使用します。
たとえば、フランスに行きたいが、次の条件を満たす場合のみ行くとしましょう:
- x1 -> 航空券が$1,000未満であること。
- x2 -> あなたのガールフレンドまたはボーイフレンドが一緒に行けること。
この決定を、次のような単純なベクトルで表現します:
(1,0)、(0,1)、(1,1)、および(0,0)。
最初のケース(1,0)では、チケットは$1,000を超えており、あなたのガールフレンドまたはボーイフレンドが一緒に行けません。
これらの2つの計算のそれぞれに重みを掛けます。たとえば、予算があり、コストが重要な場合は、重みw1=4を与えます。そして、あなたのパートナーが行けるかどうかはそれほど重要ではありません。したがって、重みはw2=3を与えます。
したがって、 フランスに行く ためのこの関数を持ちます:
(x1 * w1) + (x2 * w2) = (x1 * 4) + (x2 * 3) > しきい値b、例えば4。
bを他の側に移動して書きます:
(x1 * 4) + (x2 * 3) - 4 > 0 ならフランスに行く(すなわち、パーセプトロンが1と言っている)-
それからベクトルを式に投入します。明らかに、チケットが$1,000を超えていて、あなたのガールフレンドが行けない場合(0,0)は、あなたは旅行をしないでしょう。なぜなら、
(0 * 3) + (0 * 4) - 4は明らかに0未満だからです。
チケットが安いが、一人で行く場合はそれでも行きます:
(1 * 4) + (0 * 3) - 4 = 0は0より大きくありません。
ニューラルネットワークによる手書き認識
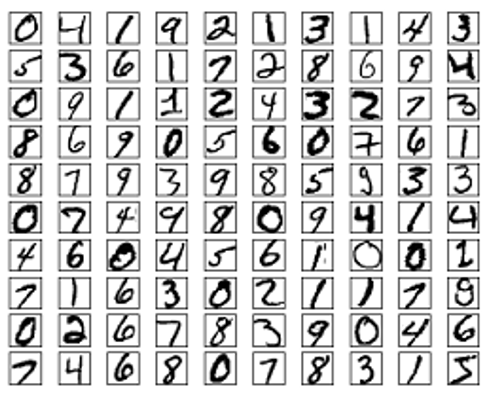
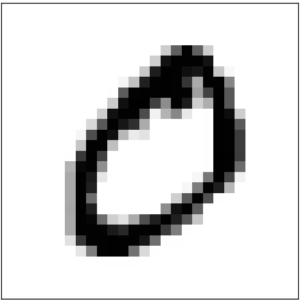
ニューラルネットワークを使用した手書きおよび顔認識は、同じことを行います。つまり、一連のバイナリ決定を下すことです。これは、任意の画像がその最小のオブジェクトであるピクセルに分解できるためです。手書きの場合、以下のように、各ピクセルは黒(1)または白(つまり空、または0)です。
ニューラルネットワークによる画像認識
すでに パーセプトロンの概念を紹介しました。このパーセプトロンは、単純な線形方程式から入力を受け取り、1(真)または0(偽)を出力します。これは、ニューラルネットワークの左側にあります。
しかし、マイケル・ニールセンが説明するように、 彼の本 では、パーセプトロンは画像認識のようなタスクには適していません。なぜなら、重みやバイアスに小さな変更を加えると出力に大きな変化が生じるからです。結局のところ、0から1への変化は大きな変化です。たとえば、0.6から0.65に変わる方が良いでしょう。
たとえば、x1とx2の2つの入力変数とバイアス3、重み-2と-3を持つ単純なニューラルネットワークがあるとします。その方程式は次のようになります:
-2×1 + -3×2 + 3 < 0 の場合は1(真)、それ以外は0(偽)。
(これは代数的に正確な表現ではありませんが、十分に近いです。ここでの目標は、理解を容易にするために数学を最小限に抑えることです。マイケルの論文は、数学のバックグラウンドがない人には理解しづらいです。)
機械学習は、重みとバイアスを調整して、結果として得られる式が正しい値を最も正確に計算します。前回の投稿から思い出してください。これは、重みとバイアスを調整することが損失 関数 を最小にすることと同じことです。ほとんどのML問題はそのように機能します。たとえば、線形回帰です。
では、0から1に変わるという大きな変化をどのように避けるのでしょうか?入力と出力の数値を0と1の間にすることを許可します。
最も簡単な方法は、方程式を1で割ることです。これはロジスティック回帰で使用されるのと同様の式を使用します。そして、最終的なニューラルネットワークの出力値にしきい値がある場合、たとえば0.5の場合、結果が1であると結論できます。
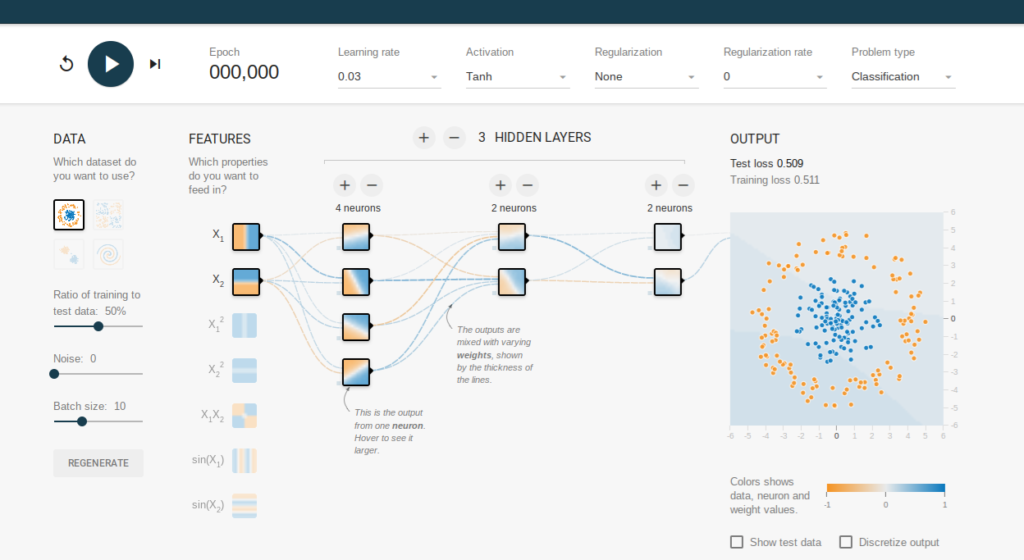
しかし、それは0または1のいずれかの結果を計算するための回り道ではないでしょうか?いいえ。ニューラルネットワークでは、初期の入力値と結果の出力だけではなく、その間に 隠れ層 と呼ばれる中間ステップがあります。これらは0または1に評価する必要はありません。
(この オンラインツールを使用して、ニューラルネットワークを操作して隠れ層を追加または削除することができます。)
z=x1w1 + x2w2 + bを上の関数とすると、次に、 シグモイドニューロン 関数(δ)を次のように修正します。

今、関数zのx1とx2の値は整数である必要はありません。0と1の間の任意の値である可能性があり、その結果、シグモイドニューロン関数δは0と1の間で変化します。
exp、定数e = 2.714を思い出してください。負の冪に上げることは、1で割ることと同じです。すなわち、exp(-z) = 1 / exp(z)。
zの値が大きいと、exp(-z)は小さく(0に近い)なります。なぜなら、大きな数で割ると小さくなるからです。その場合、シグモイドニューロン関数はほぼ1になります。逆に、zが小さいと、1/(1 + exp(-z))は0に近くなります。しかし、大きくもなく小さくもない値の場合、δはあまり変化しません。
ニューラルネットワークのトレーニング
人工知能を用いて、ニューラルネットワークを トレーニング します。これは、重みx1、x2、x3、…、xnとバイアスbを変化させることを意味します。つまり、損失関数を最小化するために入力を変化させます。これは単純な線形回帰と同じです。
損失関数は、予測値と観測値の違いです。入力が1つまたは2つだけのときは簡単です。しかし、手書き認識の場合、数百または数千の入力があります。
(256ピクセルの画像の場合、ニューラルネットワークには256 * 256の入力があります。これは、視覚化できるように小さくされたものですが、このネットワークは数字だけを見ており、アルファベット全体を見ているわけではありません。)
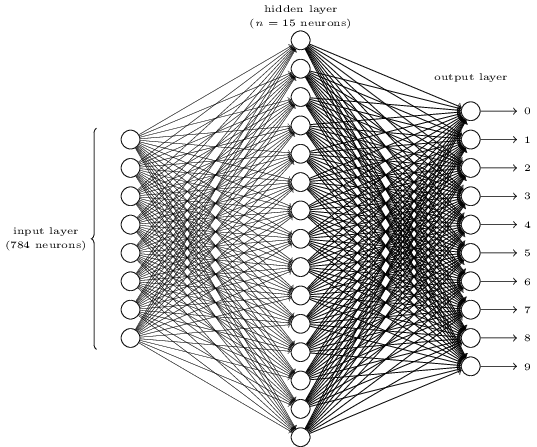
単純な線形回帰の場合、損失関数は観測値zと予測値pの距離、すなわちz - pです。ニューラルネットワークでは、より複雑なものを使用します。これは 確率的勾配降下 と呼ばれるもので、必ずしも理解する必要はありません。基本的には同じことです。しかし、数千の入力変数を持つ関数の最小値を見つけることは難しいので、 確率的勾配降下 は最初に推測を行い、そこから作業を進めます。
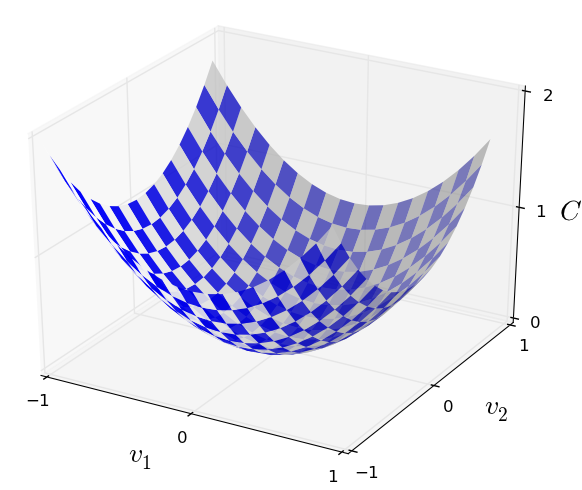
マイケル・ニールセンはこの比喩を示しています。以下は、損失関数f(x,y)のグラフです。すなわち、2つの入力を持つ関数です。もしそのボウルにビー玉を落とすと、最低点に転がっていきます。 確率的勾配降下 は、多くの入力変数を持つ損失関数のためにその点を見つけるアルゴリズムです。(微積分を知っている人は、なぜその関数の導関数を取って最小値を見つけないのかと言うかもしれません。その答えは、数千の変数を持つ関数の導関数を簡単に見つけることはできないからです。)
さて、手書き認識でこれがどのように機能するかを見てみましょう。以下は「0」の数字の画像です。ニューラルネットワークは、各ピクセルとそのピクセルがどれほど暗いかを見て、どのピクセルが塗りつぶされているかを判断します。その後、それを数字0を表す手書きサンプルと一致させます。
MNIST トレーニングセットは、250人からの手書きサンプルを取り込みます。このデータは、各描画のピクセルの組み合わせを取り込み、それが0、1、2、…、または9であるかどうかを示します。
ニューラルネットワークは、そのデータに基づいて トレーニング されます。すなわち、最も正確にどの数字であるかを判断するまで、係数とバイアスを調整します。
次に、トレーニングセットに存在しない人々からの手書きサンプルを投入します。この新しいデータセットは テスト セットと呼ばれ、これらの人々が何を書いたかを読むことが可能になります。
関連読むべきこと
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。