




ポイント: Kerasは、データセットを使用して糖尿病を予測するなど、分類問題のためのニューラルネットワークの構築を容易にします。このガイドでは、Kerasの基本をカバーし、パーセプトロンとモデル精度の使用を含め、ユーザーが約72%の精度を達成できるようにします。
- KerasはTensorFlowに比べてシンプルなAPIを提供します。
- ニューラルネットワークモデルを構築するための実用的なコードスニペットを含みます。
Kerasは分類問題を解決するためにニューラルネットワークを構築するために使用できます。この記事では、
- Kerasを説明し、TensorFlowの代わりに使用すべき理由
- ニューラルネットワークにおけるパーセプトロンを説明
- Kerasを使用してバイナリ分類問題を解決する方法を示す
このコードの一部は、Karlijn WillemsによるDataCampのブログ投稿からの洞察を基にしています。
Kerasとは?
Kerasは、GoogleのTensorFlow、Microsoft Cognitive Toolkit(CNTK)、および他の機械学習フレームワークの上に位置するAPIです。目標は、これらすべてで作業するための単一のAPIを持ち、作業をより簡単にすることです。
私の見解では、Kerasははるかに単純であるため、常にTensorFlowの代わりにKerasを使用すべきです。そのため、誤った結論を持つモデルを作成する可能性が低くなります。多くの人が飛び込んでTensorFlowを使用しようとして苦労しています。Kerasはシンプルさを加えます。しかし、KerasでTensorFlowの関数を直接使用することもでき、自分の関数を書くことでKerasを拡張することもできます。
Kerasの前提条件
以下の例を実行するには、Zeppelinがインストールされていることと、次のPythonパッケージが必要です:
- TensorFlow
- Keras
- Theano
- Seaborn
- Matplotlib
- NumPy
- pydot
- scikit-learn
このパッケージも必要です:
- sudo apt install install graphviz
まず、このデータセットをKaggleから使用します。このデータセットは、Pima Native Americansにおける糖尿病を追跡します。これを使用して、年齢、体重指数、グルコースおよびインスリンレベル、皮膚の厚さなどを考慮して、誰かが糖尿病にかかる可能性を予測するモデルを構築します。
以下のコードは、これらの特徴(グルコース、BMIなど)とラベル(単一の値、はい[1]またはいいえ[0])をKerasニューラルネットワークに挿入して、約80%の精度で誰かが2型糖尿病にかかるかどうかを予測できるモデルを構築します。
ニューラルネットワーク
ここでは、マルチレイヤーパーセプトロンを構築します。これは、精度を向上させるためにネットワークを一度だけ通過させることができるより洗練されたものとは対照的に、フィードフォワードニューラルネットワークとしても知られています。
ニューラルネットワークが1層だけの場合、それは単なるロジスティック回帰モデルになります。
これをロジスティック回帰モデルとして考えることはできますが、ロジスティック回帰計算を複数回実行することによって精度を高めるモデルです。それがニューラルネットワークの基本的なアイデアです:計算、テスト、再計算、再テスト、最適な解決策が見つかるまで繰り返します。このアプローチは、手書き文字認識、顔認識、糖尿病の予測に効果的です。
ニューラルネットワークの説明
以下のコードを学ぶ前に、ニューラルネットワークの背後にある論理を基本的に理解している必要があります。ここでの簡単なレビューです。議論を理解するためには、線形代数の基本的な理解が必要です。
基本的に、ニューラルネットワークはパーセプトロンの接続されたグラフです。各パーセプトロンは単なる関数です。分類問題では、その結果は分類問題のラベルと同じです。このモデルでは0または1です。手書き認識の場合、結果はアルファベットの文字になります。
各パーセプトロンは計算を行い、その計算を次のパーセプトロンに引き渡します。この計算は実際には確率です。分類問題の場合、閾値tが任意に設定され、事象xの確率が> tの場合、結果は1(真)になります。それ以外は偽(0)です。ロジスティック回帰の場合、その閾値は50%です。
使用される関数はシグモイド関数であり、これは2つの既知の値の間を変化する曲線、つまり正弦波のようなものです。ロジスティックシグモイド関数は、この例では、誰かが糖尿病にかかっているかどうか(1)またはそうでないか(0)を予測しようとしているため、うまく機能します。
ニューラルネットワークは大きな線形またはロジスティック回帰問題です
ロジスティック回帰は線形回帰と密接に関連しています。唯一の違いは、ロジスティック回帰が離散的な結果を出力し、線形回帰が実数を出力することです。実際、線形モデルy = wx + bがあり、t = yとすると、ロジスティック関数は次のようになります。
コード
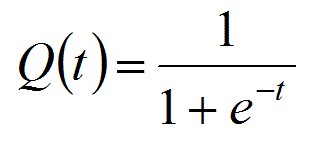
それは1と0の間で範囲を持つように設計された数値であり、確率計算に適しています。
単純な線形方程式y = mx + bでは、1つの変数xのみを扱っています。ExcelやGoogle Sheetsを使用してその問題を解決できます。ニューラルネットワークは必要ありません。
実世界で直面するほとんどの問題では、多くの変数を扱っています。その場合、mとxは行列です。しかし、数学は似ています。なぜなら、mx + bの重みとバイアスの概念が依然として存在するからです。
以下の式では、行列のサイズはm x 1です。したがって、これはベクトルであり、一次元の行列です。各i=1, 2, 3,…, mの重みはwiです。そして、mの特徴(x)はx1, x2, x3,…, xmです。xは糖尿病データにおけるBMI、グルコースなどです。重みw1, w2,…, wmとバイアスは、これらの指標とその人が糖尿病である確率との関係を最も正確に予測する数値です。
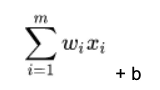
ニューラルネットワーク内の各ノードについて、w • xのドット積を計算します。これは、訓練セットから取ったすべての特徴xに対して、重みwを掛けて、計算を上下にシフトさせるためのバイアスbを加えることを意味します。
拡張された計算は、このようになります。ベクトルwの各要素をベクトルx内のそれに対応する要素で掛けます。
f(x) = (w1* x1 + w2 * x2 + … + wm * xm) + b.
これにより、私たちに実数が得られます。ロジスティック関数の場合、上記で述べたように、f(x) > %50の場合、パーセプトロンは1を出力します。それ以外は0です。
ニューラルネットワーク問題の解決
アルゴリズムは、モデルが収束するまで停止します。これは、エラーが可能な限り最小値に達することを意味します。平易な英語で言うと、それは特定の精度を持つモデルを構築したことを意味します。エラーは、エラーの値 = 1 - (モデルが正しい回数)/(観測数)です。
数学者は、モデルが収束するのは、m次元空間の各点を最大の距離で分けるハイパープレーンを見つけたときだと言います。すべての正の結果はハイパープレーンの一方の側にあり、すべての負の結果はもう一方の側にあります。言い換えれば、これは単純な線形回帰問題におけるLSE(最小二乗誤差)を計算するのと似ていますが、これは1次元以上で動作しています。
そのようなハイパープレーンが存在しない場合、問題に対する解決策はありません。そうすれば、相関関係が不十分であるため、モデルを構築できないと結論します。
ニューラルネットワークの層
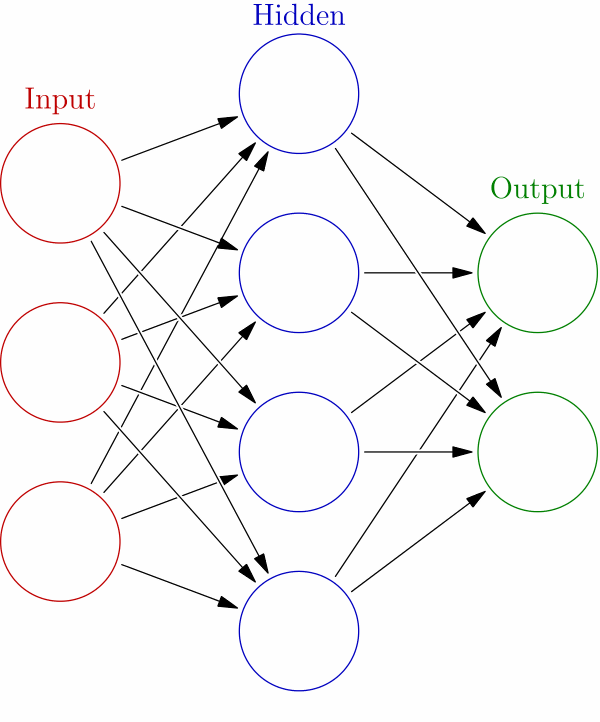
このような問題を解決するアプローチは反復的であることを忘れないでください。ニューラルネットワークの観点からは、以下のグラフィックにこれを見ることができます。
出典:Wikipedia
データ
入力層があり、ここに特徴とラベルの行列を供給します。これらのパーセプトロン関数は初期の重みを計算し、任意の数の隠れ層に渡します。これが何回行われるかは、アルゴリズムに渡すパラメータ、損失と活性化関数のために選択するアルゴリズム、ネットワークに使用を許可するノードの数によって決まります。
最終的な解決策は出力層に出てきます。入力層と出力層は1つだけです。隠れ層の数を決定する科学的な方法はありません。データサイエンティストは、最も正確な解決策が見つかるまで、それらを変え、各層で使用されるアルゴリズムを変更します。したがって、これは試行とエラーです。
この例のコードは、Jupyterノートブックここに保存されています。
Seaborn相関プロット
データ分析の最初のステップは、プロットすることです。パターンを識別しやすくなります。
変数間に相関関係があるかどうかを確認するために、強力なSeaborn相関プロットを使用します。Seabornはmatplotlibの拡張です。
最初にデータをデータフレームにロードします:
活性化関数
    import tensorflow as tf
from keras.models import Sequential
import pandas as pd
from keras.layers import Dense

data = pd.read_csv('/home/ubuntu/Downloads/diabetes.csv', delimiter=',')
次に、それを視覚的に検査します:
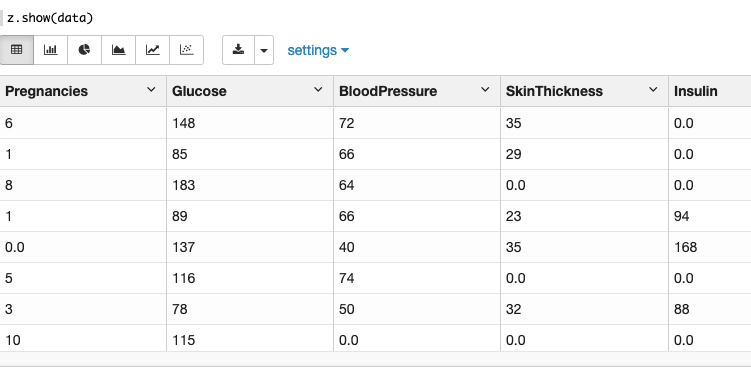
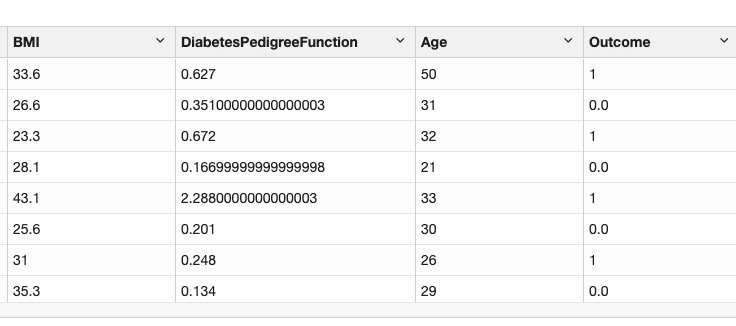
まず、データをブラウズし、最大値、最小値、平均値をリストします
data.describe()
    Pregnancies Glucose BloodPressure SkinThickness Insulin \
count 768.000000 768.000000 768.000000 768.000000 768.000000
mean 3.845052 120.894531 69.105469 20.536458 79.799479
std 3.369578 31.972618 19.355807 15.952218 115.244002
min 0.000000 0.000000 0.000000 0.000000 0.000000
25% 1.000000 99.000000 62.000000 0.000000 0.000000
50% 3.000000 117.000000 72.000000 23.000000 30.500000
75% 6.000000 140.250000 80.000000 32.000000 127.250000
max 17.000000 199.000000 122.000000 99.000000 846.000000

BMI DiabetesPedigreeFunction Age Outcome \
count 768.000000 768.000000 768.000000 768.000000
mean 31.992578 0.471876 33.240885 0.348958
std 7.884160 0.331329 11.760232 0.476951
min 0.000000 0.078000 21.000000 0.000000
25% 27.300000 0.243750 24.000000 0.000000
50% 32.000000 0.372500 29.000000 0.000000
75% 36.600000 0.626250 41.000000 1.000000
max 67.100000 2.420000 81.000000 1.000000

prediction
count 768.000000
mean 0.317708
std 0.465889
min 0.000000
25% 0.000000
50% 0.000000
75% 1.000000
max 1.000000
FINISHED
データフレーム内の値をこのように検査することもできます:
data.info()
    RangeIndex: 768 entries, 0 to 767
Data columns (total 9 columns):
Pregnancies                 768 non-null int64
Glucose                     768 non-null int64
BloodPressure               768 non-null int64
SkinThickness               768 non-null int64
Insulin                     768 non-null int64
BMI                         768 non-null float64
DiabetesPedigreeFunction    768 non-null float64
Age                         768 non-null int64
Outcome                     768 non-null int64
dtypes: float64(2), int64(7)
memory usage: 54.1 KB
ヒートマップグラフで相関関係を確認
次に、変数間に相関関係があるかどうかを確認するためにこのコードを実行します。最終モデルには重要ではありませんが、データに関するさらなる洞察を得るのに役立ちます。
Seabornは、データセットの各値を自身および他のすべての値に対してプロットし、ヒートマップタイプのチャートを作成します。次に、これら2つの値がどのように相関しているかを確認します。
    import seaborn as sns
import matplotlib as plt
corr = data.corr()
sns.heatmap(corr,
            xticklabels=corr.columns.values,
            yticklabels=corr.columns.values)
完全に相関している項目は相関値1を持っています。当然ながら、各メトリックは自分自身と完全に相関していることは明らかであり、チャートの中央を斜めに横切るタン線で示されています。
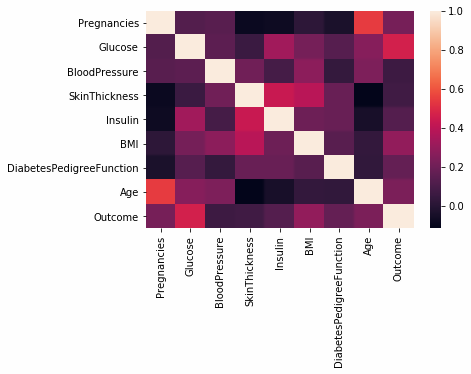
チャートにはオレンジの四角があまりありません。したがって、1つの値が80%の確率で糖尿病を引き起こすとは言えません(結果)。これらの個々の変数の間にはあまり相関関係がないようです。しかし、集計すると、これらの要因すべてを考慮して、誰が糖尿病を発症するかをほぼ75%の精度で予測できることがわかります。
以下のようにデータフレームで2つの変数の相関関係を確認できます。0.28と0.54は1.00からかなり離れているため、ここにはあまり相関関係がありません。
    data['BloodPressure'].corr( data["BMI"])

0.2818052888499106

data["Pregnancies"].corr(data["Age"])

0.5443412284023394
テストデータセットとトレーニングデータセットの準備
- 結果はラベルのある列(0または1)です。
- 残りの列は特徴です。
- scikit-learn関数train_test_split(X, y, test_size=0.33, random_state=42)を使用してデータをトレーニングデータセットとテストデータセットに分割します。レコードの33%がテストデータセットに割り当てられます。トレーニングデータセットはモデルをトレーニングするために使用され、重みとバイアスを見つけます。テストデータセットはその精度を確認するために使用されます。
- ラベルは配列ではありません。それはデータセットの列です。したがって、NumPy np.ravel() 関数を使用してそれを配列に変換します。
    import numpy as np

labels=data['Outcome']
features = data.iloc[:,0:8]

from sklearn.model_selection import train_test_split

X=features

y=np.ravel(labels)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=42)
次に、値を正規化します。これは、トレーニングデータセットとテストデータセットの各xについて、(x - μ)/ δ、つまり平均(μ)からの距離を標準偏差(δ)で割ることを意味します。これにより、データが標準スケールに置かれ、機械学習の標準的な慣行になります。
StandardScalerは、これを2つのステップで行います:fit() とtransform()。
    from sklearn.preprocessing import StandardScaler

scaler = StandardScaler().fit(X_train)

X_train = scaler.transform(X_train)

X_test = scaler.transform(X_test)
Kerasの順次モデル
以下のコードはKerasの順次モデルを作成しました。これは、ニューラルネットワークの層を1つずつ追加して構築することを意味します。他の技術やニューラルネットワークのタイプとは対照的です。
各層の活性化関数を選択します。それは((w • x)+ b)を取り、それに確率を計算させます。その後、ニューロン((w • x)+ b)が1(真)または0(偽)であるべきかを決定するための閾値を設定します。これは、糖尿病、1またはそうでない、0を示すこととは異なります。ニューラルネットワークは、2つの離散的な結果だけでなく、複数の問題を処理できます。
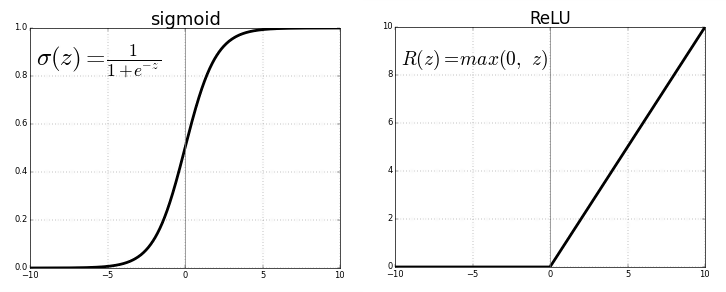
最初の2つの層では、relu(修正線形ユニット)活性化関数を使用します。その選択は重要ではありません。sigmoidを選んでもよかったのです。reluIはすべての正の値に対して1であり、すべての負の値に対して0です。
f(x) = 0 if x <=0
f(x) = 1 if x > 0
これは、f(x) = max (0, x)と言うのと同じです。例えば、f(-1)はmax(0, -1)で0になります。つまり、確率関数が負であれば、0(偽)を選択します。それ以外の場合は1(真)を選択します。
どの活性化関数を選択するかのルールは試行錯誤です。異なるものを選択して、どれが最も正確な予測を生成するかを確認します。他にも、Sigmoid、tanh、Softmax、ReLU、Leaky ReLUなどがあります。いくつかは、バイナリ出力よりも複数の出力に適しています。
シグモイドはロジスティック関数を使用します。1 / (1 + e**z)で、ここでz = f(x) =((w • x)+ b)です。
以下のデータサイエンスのグラフは、各関数を曲線としてプロットしたものです。
コードに関するいくつかのメモ:
- input_shape —最初の層の入力の形状(次元)を与える必要があります。それは(8,)です。これは8つの特徴のベクトルです。すなわち、8 x 1です。
- Dense —((w • x)+ b)に対して活性化関数を適用します。Dense関数の最初の引数は隠れユニットの数です。これはモデルの精度を改善するために調整できるパラメータです。隠れユニットは、隠れ層の数と同様に、理解または説明が難しい複雑なトピックですが、私たちは安全にそれを無視できます。
(これらの2つのトピックの複雑さが、ほとんどの人にニューラルネットワークの作業がアートだと言わせる理由です。数学者はその厳密さの欠如を嘲笑するでしょう。)
    from keras.models import Sequential
from keras.layers import Dense

model = Sequential()

model.add(Dense(8, activation='relu', input_shape=(8,)))

model.add(Dense(8, activation='relu'))

model.add(Dense(1, activation='sigmoid'))
- loss —ニューラルネットワークの目標は、予測値と観測値の間の差、すなわち損失関数を最小化することです。私たちは多くの関数を使用できます。私たちはbinary_crossentropyを選びます。なぜなら、私たちのラベルデータはバイナリ(1)糖尿病および(0)非糖尿病だからです。
- optimizer —最適化関数sgd、確率的勾配降下法を使用します。これは、損失関数をできるだけ早く最小化するために設計されたアルゴリズムです。他にもあります。
- epoch —モデルを何回実行するかを意味します。これは反復的なプロセスであることを忘れないでください。追加のエポックを追加することもできますが、精度はあまり変わらないかもしれません。試してみる必要があります。
- metrics —実行中に表示するメトリックを意味します。精度は、進行中のモデルが結果をどれだけ正確に予測するかを示します。
- batch size —nは、入力データをnバッチに分割し、各バッチを並行して処理することを意味します。
- fit() —モデルをトレーニングし、重み、バイアス、層の数などを計算します。
    model.compile(loss='binary_crossentropy',
              optimizer='sgd',
              metrics=['accuracy'])

model.fit(X_train, y_train,epochs=4, batch_size=1, verbose=1)
上記では、重みとバイアスのためにニューラルネットワークを解決する反復プロセスについて説明しました。これはエポックで行われます。以下は、実行中の出力です。精度が急速に上昇し、その後平坦になります。
    Epoch 1/4
514/514 [==============================] - 2s 3ms/step - loss: 0.6016 - acc: 0.6790
Epoch 2/4
514/514 [==============================] - 1s 1ms/step - loss: 0.5118 - acc: 0.7588
Epoch 3/4
514/514 [==============================] - 1s 1ms/step - loss: 0.4755 - acc: 0.7782
Epoch 4/4
514/514 [==============================] - 1s 1ms/step - loss: 0.4597 - acc: 0.7802
model.summary() を使用していくつかの情報を印刷できます。
ここでは、言及した各層の重みがあります。
このようになります:
    for layer in model.layers:
    weights = layer.get_weights()
このようになります:
    [array([[ 0.11246287,  0.64353085,  0.00519296, -0.3992814 ,  0.29071185,
         0.3010074 ,  0.21385622,  0.31609035],
       [ 0.6338699 ,  0.5349119 ,  0.11174025,
…
層とその形状の図を描くこともできます。あまり役に立ちませんが、見るのは楽しいです。
    from keras.utils import plot_model
plot_model(model, to_file='/tmp/model.png', show_shapes=True,)
予測の出力の形状は1です。これが私たちの予測です:
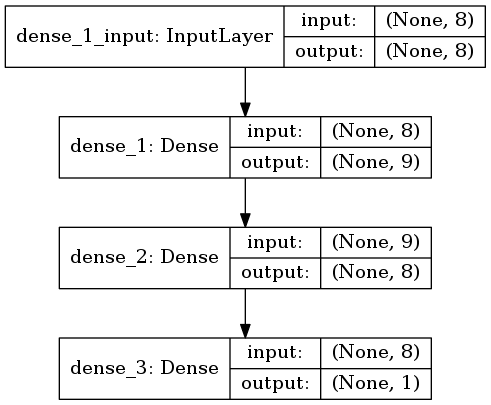
その後、各層の構成情報をlayer.get_configで取得し、モデルの構成をmodel.get_config()で取得できます:
今、テストデータで予測を実行できます。
y_pred = model.predict_classes(X_test)
これにより、スコアまたは精度が印刷されます。
    score = model.evaluate(X_test, y_test,verbose=1)

print(score)
    254/254 [==============================] - 0s 46us/step
[0.5745944582571195, 0.7204724428221936]
したがって、私たちの予測モデルは72%の精度です。
データキャンプでのディスカッションを読むと、他のアナリストが他の技術を試してわずかに良い結果を得ているのがわかります。しかし、過学習の危険性を忘れないでください。
TensorFlowとKerasのガイド
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。