




ポイント: 混同行列は、機械学習モデルを評価するために不可欠であり、精度と再現率の概念を強調します。これらは視覚的に予測パフォーマンスを表し、分類における偽陽性と偽陰性を示します。
- 精度は、正の予測の正確性を測定します。
- 再現率は、モデルがすべての関連するインスタンスをキャプチャする能力を評価します。
あなたは< a href="/resources/blogs/gartner-hype-cycle/">機械学習モデルを構築しました。素晴らしい。入力を与えると出力が得られます。時には出力が正しく、時には間違っています。あなたはモデルがトレーニングテストで約86%の精度を持っていることを知っています。しかし、86%は十分な精度指標ではありません。それでは物語の半分しか明らかになりません。時には、まったく誤った印象を与えることさえあります。精度、再現率、そして混同行列…これらはより安全です。見てみましょう。
混同行列とは?
精度と再現率は混同行列から解釈できるので、そこで始めます。混同行列は、モデルがどれだけ正確に予測したかを表示するために使用されます。
二項分類
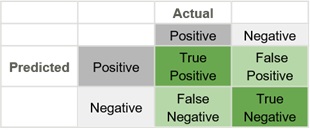
例を見てみましょう:あるモデルが、運転手が信号で左に曲がるか右に曲がるかを予測するために使用されます。これは二項分類です。はいまたはいいえ、または真または偽の区別を行う任意の予測タスクで機能します。混同行列の目的は、モデルがどれだけ…そう、どれだけ混乱しているかを示すことです。これを行うために、2つの概念を導入します:偽陽性と偽陰性です。
- モデルが正(左)と負(右)を予測するとすると、偽陽性は実際の方向が右なのに左と予測することになります。
- 偽陰性は逆の動作をします。モデルが右と予測しますが、実際の結果は左です。
混同行列を使用すると、これらの数値は次のようにチャートに表示できます:
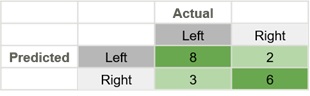
この混同行列では、合計19の予測が行われました。14は正しく、5は間違っています。
- 偽陰性セル、番号3は、モデルが負を予測し、実際は正であったことを意味します。
- 偽陽性セル、番号2は、モデルが正を予測したが、実際は負であったことを意味します。
偽陽性は、この時点で人が選んだ方向にはほとんど意味がありません。しかし、選択に何らかの利害関係があるとすると、たとえば右を選択することが大きな報酬につながり、誤ってそれを選ぶことが確実な死を意味する場合、選択には利害関係が生じ、偽陰性は非常に高いコストがかかる可能性があります。私たちは、モデルが100%確実である場合にのみ、その選択を行うことを望みます。
混乱のコスト/利益
選択のコストと利益を天秤にかけることで、混同行列に意味を与えます。Instagramアルゴリズムは、投稿されるすべての写真にヌードフィルターを適用する必要があるため、ヌード写真を検出するための分類器が作成されます。ヌード写真が投稿され、フィルターを通過してしまうと、Instagramにとって非常に高いコストがかかる可能性があります。したがって、彼らはすべてのヌード写真をフィルタリングするために必要以上に多くの事柄を分類しようとします。失敗のコストが非常に高いためです。
非二項分類
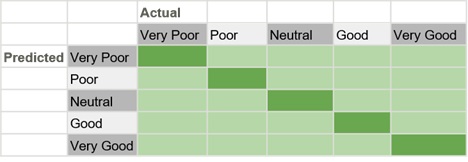
最終的に、混同行列は二項分類器だけに適用されるわけではありません。モデルが必要とする任意のカテゴリ数に使用でき、同じ分析ルールが適用されます。たとえば、民主党全国討論会に対する人々の評価を分類するための行列を作成できます:
- 非常に悪い
- 悪い
- 中立
- 良い
- 非常に良い
モデルが行うすべての予測は、混同行列に配置できます:
混同行列における精度
精度は、真陽性の比率と真陽性と偽陽性の合計の比率です。精度は、混合されたジャンク陽性がどれだけあるかを見ます。悪い陽性(偽陽性)がない場合、モデルは100%の精度を持っていました。偽陽性が混合に増えるほど、その精度は見栄えが悪くなります。モデルの精度を計算するには、混同行列から正と負の数値が必要です。
精度 = TP/(TP + FP)
混同行列における再現率
再現率は別のルートをたどります。モデルが予測した偽陽性の数を見る代わりに、再現率は予測の中に入った偽陰性の数を見ます。
再現率 = TP/(TP + FN)
再現率は、偽陰性が予測されるたびにペナルティを受けます。精度と再現率のペナルティが逆であるため、方程式も逆になります。精度と再現率は、混同行列を評価するための陰と陽の関係です。
再現率と精度:どちらか一方?
前述のように、混同行列を理解する際、時にはモデルがより多くの偽陰性を許可したい場合があります。それにより、精度が高くなります。なぜなら、偽陰性は再現率の方程式をペナルティしないからです。(そこで、彼らは美徳です。)時には、モデルがより多くの偽陽性を許可したい場合があり、それにより再現率が高くなります。なぜなら、偽陽性は考慮されないからです。一般的に、モデルは高い再現率と高い精度の両方を持つことはできません。再現率や精度のポイントを高めることにはコストが伴います。モデルには、精度と再現率が同じである平衡点があるかもしれませんが、モデルが精度を少しでも高めるために調整されると、再現率が低下する可能性があります。
追加リソース
これらのリソースで機械学習に関する情報をさらに得ましょう:
- BMC機械学習&ビッグデータブログ
- 機械学習:ハイプと現実
- 解釈可能性と説明可能性:機械学習のブラックボックス
- TensorFlowとKerasを使用した機械学習、実践ガイド
- この素晴らしいコラボノートでは、混同行列、精度、再現率をコードで示します
精度と再現率の数学的理解のために、このビデオを見てください:

混同行列に関するよりユーモラスな見方:
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。