


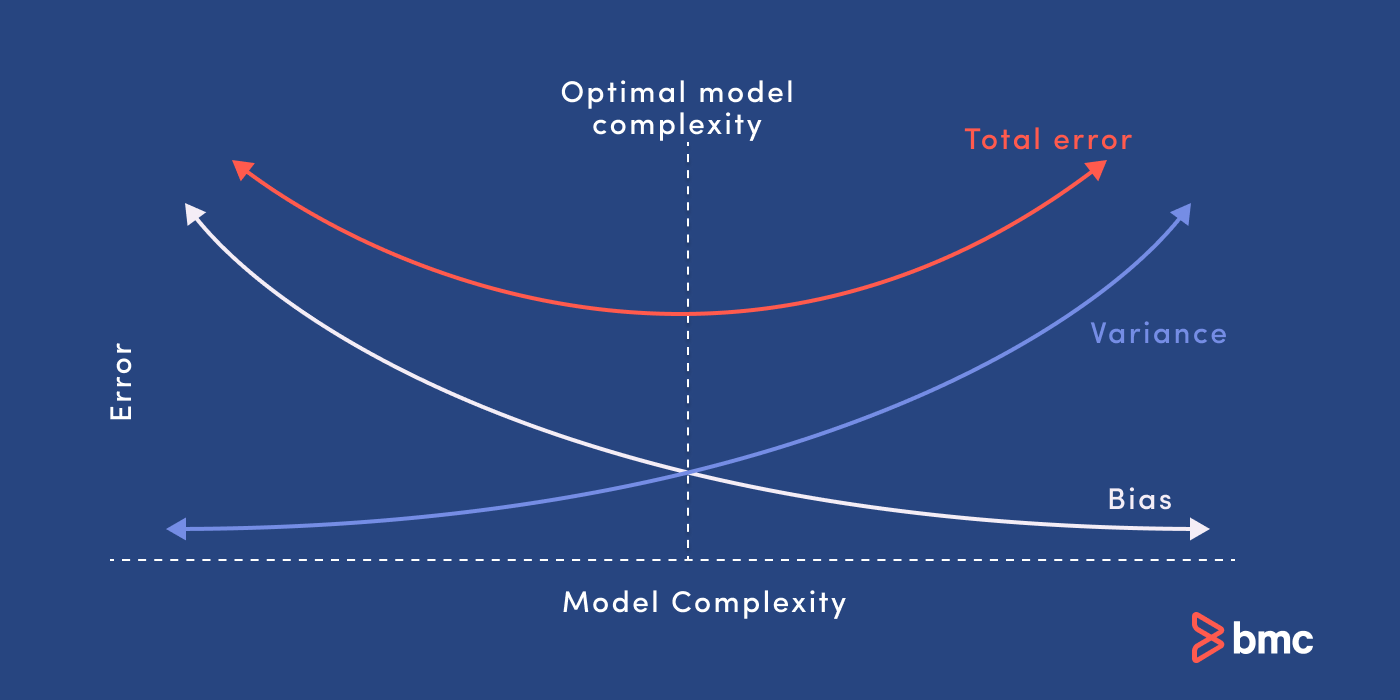


ポイント: バイアスと分散のトレードオフを理解することは、効果的な機械学習モデルを作成するために不可欠です。バイアスは体系的なエラーを引き起こし、分散はデータの変動に対する過剰な感受性から生じます。
- バイアスと分散のバランスを取ることで、アンダーフィッティングとオーバーフィッティングを避けることができます。
- モデルの複雑さやトレーニングデータの量を増やすことで、このトレードオフを管理することができます。
すべてのデータエンジニアは、機械学習(ML)におけるバイアスとバリアンストレードオフについて理解を深める必要があります。 MLは毎日、より多くのアプリケーションで使用されています。音声および画像認識、詐欺検出、チャットボット、生成AIなどは、今やこの技術の一般的な使用例です。MLの使用の増加は、 機械学習アルゴリズム が専門の研究室から情報技術の主流へと広がる複雑さをもたらしています。 機械学習モデルはブラックボックスであってはなりません。データエンジニアおよび 大規模データセットのユーザーは、MLモデルを構築および評価する際に、さまざまなアルゴリズムや学習要件を作成し評価する方法を理解する必要があります。機械学習におけるバイアスとバリアンスは、任意のモデルの全体的な正確性に影響を与えます(これは混同行列から解釈できます)、その出力と結果への信頼、そして機械に学ばせる能力に影響します。 この記事では、機械学習におけるバイアスとバリアンスとは何かを議論します。また、MLアプリケーションの役立つアルゴリズムを開発する際にバイアスとバリアンスのトレードオフにどのように対処するかにも触れる予定です。 (ML初心者ですか? ML vs AIの解説をお読みください。)
バイアスとバリアンス、そしてトレードオフ
バイアスとバリアンスは、予測モデルにおける2つの誤差の源です。バイアスとバリアンストレードオフの正しいバランスを取ることは、効果的な機械学習アルゴリズムにとって基本的です。これらの概念の簡単な説明は次のとおりです:
- バイアス。 バイアスは、複雑な問題を解決するために過度に単純化されたモデルによって引き起こされる誤差を指し、重要な関係を見逃します。
- バリアンス。 バリアンスは、データの変動に対して過度に敏感なアルゴリズムによって引き起こされる誤差であり、実際にはランダム性であるデータのパターンを見つける過度に複雑なモデルを作成します。
- バイアス-バリアンストレードオフ。 過度の単純化と過剰な複雑さによって引き起こされる誤差を最小限に抑えるには、両者の間で正しいバランスまたはトレードオフを見つける必要があります。
機械学習におけるバイアスとは?
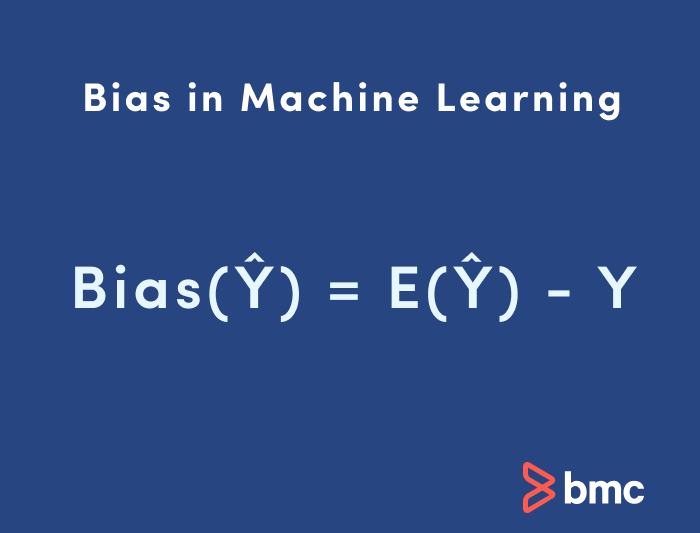
MLにおけるバイアスは、時に「単純すぎる」問題と呼ばれます。バイアスは、MLプロセスにおける誤った仮定によって機械学習モデル自体に発生する系統的な誤差と見なされます。 技術的には、バイアスを平均モデル予測と真実の間の誤差として定義できます。さらに、モデルがトレーニングデータセットにどれだけ適合しているかを説明します:
- 高バイアス。 バイアスが高いモデルは、データセットに密接に適合しません。
- 低バイアス。 低バイアスモデルは、トレーニングデータセットに密接に適合します。
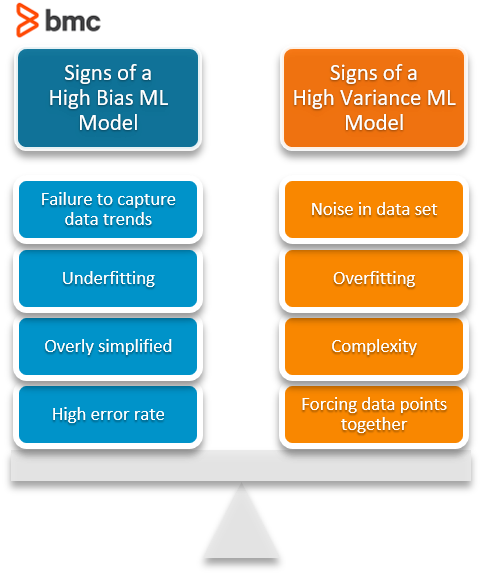
高バイアスモデルの特徴は次のとおりです:
- 適切なデータトレンドをキャプチャできない
- アンダーフィッティングの可能性
- より一般化されている/過度に単純化されている
- 高い誤差率
機械学習におけるバリアンスとは?
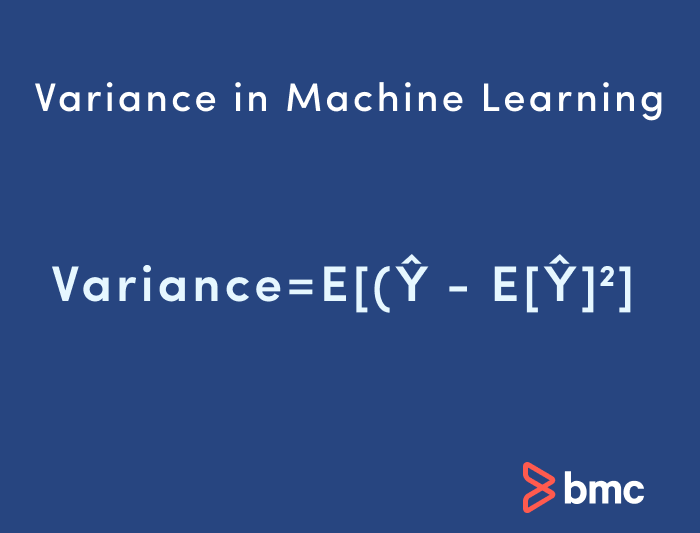
機械学習におけるバリアンスは、時に「過度に敏感な」問題と呼ばれます。MLにおけるバリアンスは、トレーニングデータセットの異なる部分を使用する際のモデルの変化を指します。 簡単に言えば、バリアンスはモデル予測の変動性です。すなわち、与えられたデータセットに応じてML関数がどれだけ調整できるかを示します。バリアンスは、特徴が多すぎる非常に複雑なモデルから生じます。
- 低バリアンス。バイアスが高いモデルは低バリアンスになります。
- 高バリアンス。バリアンスが高いモデルは低バイアスになります。
これらすべては、モデルの柔軟性に寄与します。たとえば、高バイアスのデータセットに適合しないモデルは、低バリアンスの柔軟性のないモデルを作成し、サブオプティマルな機械学習モデルをもたらします。 高バリアンスモデルの特徴には次のものがあります:
- データセットのノイズ
- オーバーフィッティングの可能性
- 複雑なモデル
- すべてのデータポイントをできるだけ近くに置こうとする
AIOpsの開始は簡単です。ITの複雑さを簡単に管理する方法を学びましょう! ›
アンダーフィッティングとオーバーフィッティング
果物の例から、モデルがデータに適合することがいかに重要であるかがわかります。モデルがデータに「適合」する程度は、データセットからの識別または予測を行う際の精度に直接相関します。
- アンダーフィッティング は、モデルがデータの変動やパターンをキャプチャするには単純すぎるときに発生します。機械はトレーニングデータから正しい特徴や関係を学習せず、そのために後続のデータセットでうまく機能しません。赤いリンゴでトレーニングされ、赤いサクランボをリンゴと間違えるかもしれません。
- オーバーフィッティング は、モデルが過度に複雑で、トレーニングデータセットの詳細やランダムな変動を持つときに発生します。機械はこのノイズを真のパターンと誤って見なし、そのため、次のデータセットで実際のパターンを一般化して見ることができなくなります。特定の種類のリンゴの詳細に多くの詳細でトレーニングされているため、すべての特定の詳細を持っていないリンゴを見つけることができないかもしれません。
バイアス-バリアンストレードオフ
バイアスとバリアンスは逆に関連しています。低バイアスかつ低バリアンスのMLモデルを持つことは不可能です。 データエンジニアが特定のデータセットに合わせてMLアルゴリズムを修正すると、低バイアスになりますが、バリアンスは増加します。このようにして、モデルはデータセットに適合しますが、不正確な予測の可能性が高まります。 低バリアンスモデルを高バイアスで作成する場合も同様です。これにより、不正確な予測のリスクは減少しますが、モデルはデータセットに適切に適合しません。 バイアスとバリアンスの間には微妙なバランスがあります。しかし、重要なのは、バリアンスが高いからといって、悪いMLアルゴリズムを示すわけではありません。機械学習アルゴリズムは、ある程度のバリアンスを処理できるべきです。 トレードオフに対処する方法はいくつかあります…
- モデルの複雑さを増加させることで、バイアスとバリアンスを考慮し、全体のバイアスを減少させつつ、許容可能なレベルまでバリアンスを増加させます。これにより、モデルはトレーニングデータセットと整合性を持ちつつ、重大なバリアンスエラーを引き起こすことなく一致させます。
- トレーニングデータセットを増加させることも、このトレードオフのバランスをとるのに役立ちます。これは、オーバーフィッティングモデルに対処する際の優先方法です。さらに、これにより、ユーザーは大規模データセットでのバリアンスエラーを汚染することなく複雑さを増加させることができます。
大規模データセットは、アルゴリズムがデータを簡単に一般化できるようにするためのより多くのデータポイントを提供します。ただし、トレーディングデータセットを増やす際の主な問題は、アンダーフィッティングや低バイアスモデルがトレーニングデータセットにそれほど敏感でないことです。したがって、高バリアンスおよび高バイアスモデルに対処する際には、データの増加が望ましい解決策となります。 この表は、一般的なアルゴリズムと、そのバイアスとバリアンスに関する期待される動作を示しています:
| アルゴリズム | バイアス | バリアンス |
| 線形回帰 | 高バイアス | 低バリアンス |
| 決定木 | 低バイアス | 高バリアンス |
| バギング | 低バイアス | 高バリアンス(決定木より少ない) |
| ランダムフォレスト | 低バイアス | 高バリアンス(決定木およびバギングより少ない) |
バイアスとバリアンスの計算Python例
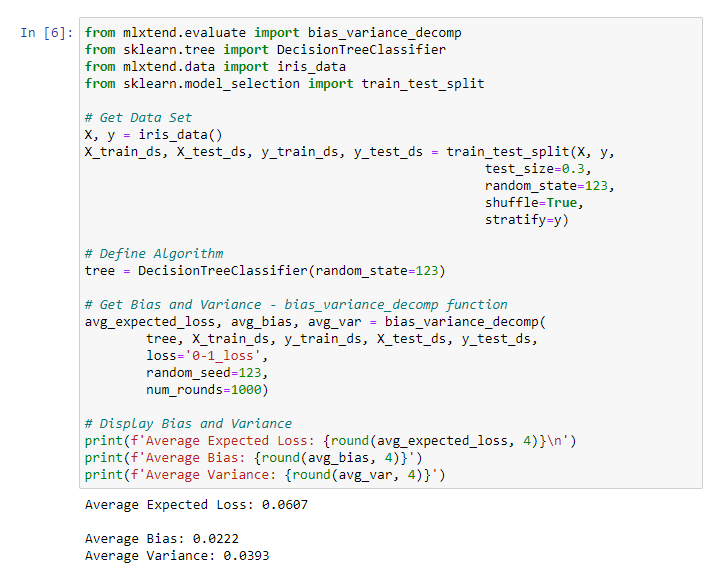
これらの概念を実践に移してみましょう。Pythonを使用してバイアスとバリアンスを計算します。 これを行う最も簡単な方法は、データサイエンスのタスクを対象とした mlxtend (機械学習拡張)というライブラリを使用することです。このライブラリは、 bias_variance_decomp という機能を提供し、バイアスとバリアンスを計算するために使用できます。 Irisデータセットをmlxtendに含め、バイアス-バリアンスのデコンポジションを行うために、決定木とバギングの2つのアルゴリズムを使用します。
決定木の例
    from mlxtend.evaluate import bias_variance_decomp
from sklearn.tree import DecisionTreeClassifier
from mlxtend.data import iris_data
from sklearn.model_selection import train_test_split

# Get Data Set
X, y = iris_data()
X_train_ds, X_test_ds, y_train_ds, y_test_ds = train_test_split(X, y,
                                                    test_size=0.3,
                                                    random_state=123,
                                                    shuffle=True,
                                                    stratify=y)

# Define Algorithm
tree = DecisionTreeClassifier(random_state=123)

# Get Bias and Variance - bias_variance_decomp function
avg_expected_loss, avg_bias, avg_var = bias_variance_decomp(
        tree, X_train_ds, y_train_ds, X_test_ds, y_test_ds,
        loss='0-1_loss',
        random_seed=123,
        num_rounds=1000)

# Display Bias and Variance
print(f'Average Expected Loss: {round(avg_expected_loss, 4)}n')
print(f'Average Bias: {round(avg_bias, 4)}')
print(f'Average Variance: {round(avg_var, 4)}')
結果:
バギングの例
    from mlxtend.evaluate import bias_variance_decomp
from sklearn.tree import DecisionTreeClassifier
from mlxtend.data import iris_data
from sklearn.model_selection import train_test_split
from sklearn.ensemble import BaggingClassifier

# Get Data Set
X, y = iris_data()
X_train_ds, X_test_ds, y_train_ds, y_test_ds = train_test_split(X, y,
                                                    test_size=0.3,
                                                    random_state=123,
                                                    shuffle=True,
                                                    stratify=y)

# Define Algorithm
tree = DecisionTreeClassifier(random_state=123)
bag = BaggingClassifier(base_estimator=tree,
                        n_estimators=100,
                        random_state=123)

# Get Bias and Variance - bias_variance_decomp function
avg_expected_loss, avg_bias, avg_var = bias_variance_decomp(
        bag, X_train_ds, y_train_ds, X_test_ds, y_test_ds,
        loss='0-1_loss',
        random_seed=123,
        num_rounds=1000)

# Display Bias and Variance
print(f'Average Expected Loss: {round(avg_expected_loss, 4)}n')
print(f'Average Bias: {round(avg_bias, 4)}')
print(f'Average Variance: {round(avg_var, 4)}')
結果:
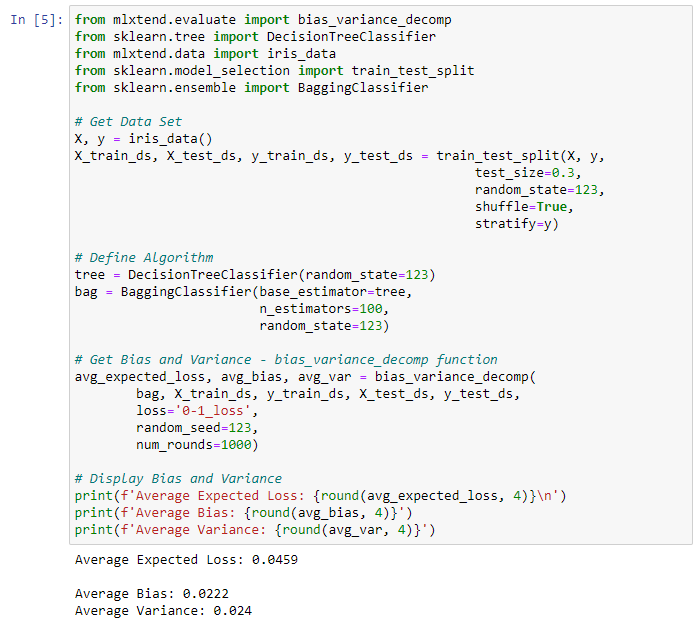
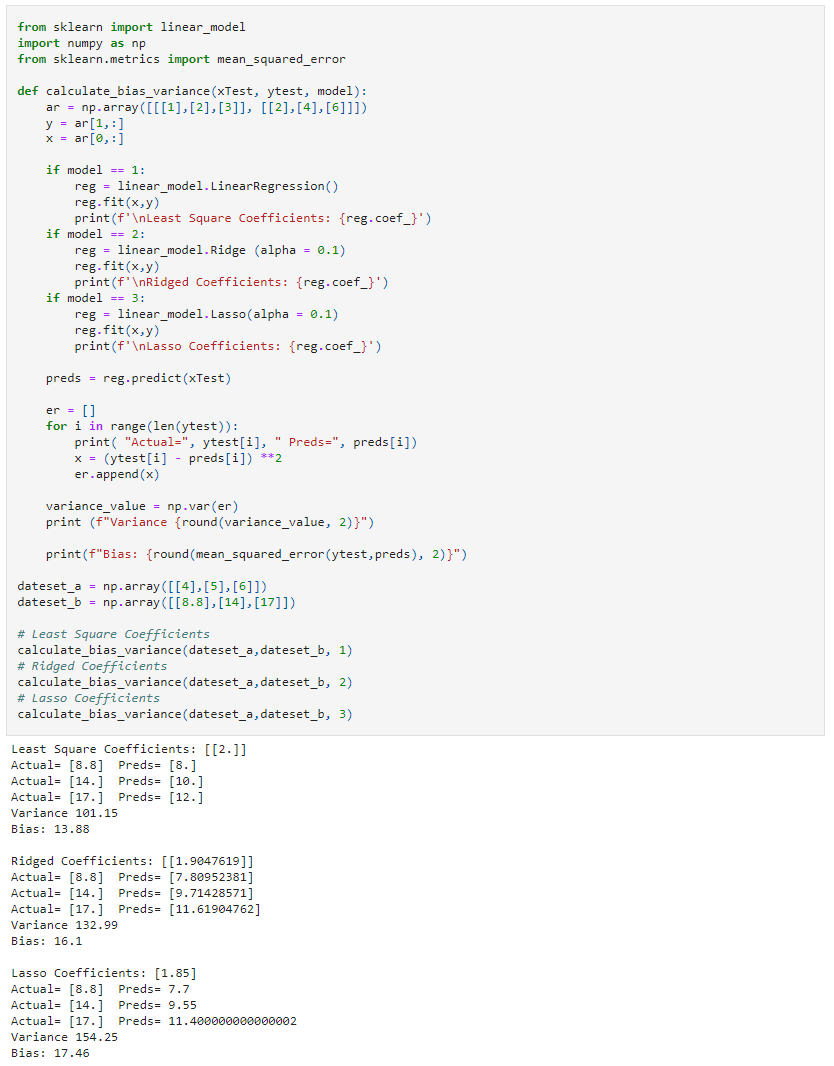
上記の各関数は、平均バイアスとバリアンスの値を計算する前に1,000ラウンド(num_rounds=1000)実行されます。バイアスに影響を与えずにバリアンスを減少させるために、バギング分類器を使用できます。アルゴリズムの複雑さが高いほど、バリアンスは低くなります。 次の例では、最小二乗法、リッジ、ラッソという3つの異なる線形回帰モデルを見ていきます。 sklearn ライブラリを使用します。これらはすべて線形回帰アルゴリズムであるため、主な違いは係数の値になります。 これらの異なるアルゴリズムが、MLプロセス(バイアスとバリアンス)に異なる結果をもたらすことがわかります。
    from sklearn import linear_model
import numpy as np
from sklearn.metrics import mean_squared_error

def calculate_bias_variance(xTest, ytest, model):
    ar = np.array([[[1],[2],[3]], [[2],[4],[6]]])
    y = ar[1,:]
    x = ar[0,:]

    if model == 1:
        reg = linear_model.LinearRegression()
        reg.fit(x,y)
        print(f'nLeast Square Coefficients: {reg.coef_}')
    if model == 2:
        reg = linear_model.Ridge (alpha = 0.1)
        reg.fit(x,y)
        print(f'nRidged Coefficients: {reg.coef_}')
    if model == 3:
        reg = linear_model.Lasso(alpha = 0.1)
        reg.fit(x,y)
        print(f'nLasso Coefficients: {reg.coef_}')

    preds = reg.predict(xTest)

    er = []
    for i in range(len(ytest)):
        print( "Actual=", ytest[i], " Preds=", preds[i])
        x = (ytest[i] - preds[i]) **2
        er.append(x)

    variance_value = np.var(er)
    print (f"Variance {round(variance_value, 2)}")

    print(f"Bias: {round(mean_squared_error(ytest,preds), 2)}")

dateset_a = np.array([[4],[5],[6]])
dateset_b = np.array([[8.8],[14],[17]])

# Least Square Coefficients
calculate_bias_variance(dateset_a,dateset_b, 1)
# Ridged Coefficients
calculate_bias_variance(dateset_a,dateset_b, 2)
# Lasso Coefficients
calculate_bias_variance(dateset_a,dateset_b, 3)
結果:
バイアスとバリアンスを考慮することが重要
バイアスとバリアンスは、良好で正確な機械学習モデルを開発する際に考慮すべき2つの重要な要素です。
- バイアスはMLモデルにおいて一貫した誤差を生じさせ、特定の要件には適さない単純なMLモデルを表します。
- 一方、バリアンスは誤差を生じさせ、存在しないトレンドやデータポイントを見てしまう不正確な予測を引き起こします。
ユーザーは、MLモデルを作成する際にこれらの両方の要素を考慮する必要があります。一般的に、目標はバイアスをできるだけ低く抑えつつ、許容可能なレベルのバリアンスを導入することです。これは、複雑さを増すか、トレーニングデータセットを増やすことによって行うことができます。 このバランスの取れた方法で、受け入れ可能な機械学習モデルを作成できます。
関連する読書
これらの投稿は私自身の見解であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。