




ポイント: 異常検知はデータセットの外れ値を特定するために重要であり、システムの監視と根本原因分析を強化します。機械学習は検出効率を向上させますが、構造化データ、大規模データセット、および熟練したエンジニアが必要です。
- アプリケーションには詐欺検知、侵入検知、および健康監視が含まれます。
- 課題にはデータ要件とエンジニアリング才能の必要性が含まれます。
異常検知は堅牢な分散ソフトウェアシステムにおいて重要な役割を果たします。異常検知は:
- システムの挙動に関するコミュニケーションを強化する
- 根本原因分析を改善する
- ソフトウェアエコシステムへの脅威を減少させる
従来の異常検知は手動です。しかし、機械学習技術は異常検知の成功を改善しています。もちろん、機械学習には初期コスト—データ要件とエンジニアの才能が必要です。
この記事では、以下を見ていきます:
異常検知とは?
異常検知はデータセットの外れ値を見つけるプロセスです。これらのアイテムは、通常は存在しないものです。これらの異常は、異常なネットワークトラフィックを示したり、故障しているセンサーを発見したり、分析の前にクリーンアップするデータを特定することができます。
今日の分散システムの世界では、システムのパフォーマンスを管理および監視することは手間がかかりますが、必要な作業です。数百または数千のアイテムを監視する必要があるため、異常検知はエラーが発生している場所を特定し、根本原因分析を強化し、迅速に技術サポートを呼び寄せるのに役立ちます。異常検知は、外れ値を検出し、責任者に行動を促すことによって、カオスエンジニアリングの監視を助けます。
企業のITでは、異常検知は一般的に以下の目的で使用されます:
- データのクリーンアップ
- 侵入検知
- 詐欺検知
- システムの健康監視
- センサーネットワークにおけるイベント検知
- エコシステムの混乱
異常検知の課題
しかし、上記の一般的な使用例でも、異常検知にはいくつかの欠点があります。会議論文Bram Steenwinckelによる:
「異常検知(AD)システムは、データにしきい値を設定する専門家によって手動で構築されるか、利用可能なデータから機械学習(ML)を通じて自動的に構築されます。」
異常検知システムを手動で構築するのは面倒です。これにはドメイン知識が必要で、さらに難しいのは予見の能力です。
詐欺のように、データが時間と共に変化するエコシステムの場合、これは良いソリューションではありません。人々を排除するために壁を建設することは、彼らが越えたり、下を通ったり、回り道をする方法を見つけるまで機能します。システムが失敗した場合、ビルダーは再度内部に戻り、手動でさらなるセキュリティ手法を追加する必要があります。
カオスエンジニアリングの視点から見ると、手動で異常検知を構築するのは悪いことです。なぜなら、適応できないシステムを作成するからです(または適応するのがコストがかかり、遅れが生じます)。
機械学習による異常検知
したがって、機械学習はエンジニアが以下のようなADシステムを作成する目的に適しています:
- より良く機能する
- 適応的でタイムリーである
- 大規模なデータセットを扱う
これらの利点にもかかわらず、機械学習による異常検知は特定の条件下でのみ機能します。
非構造化データ:異常とは何か?
異常検知に機械学習を適用するには、問題をよく理解する必要があります。特に非構造化データの状況では。
構造化データは、すでに問題空間の理解を示唆します。異常データは特定のルールを破るため、簡単に特定できるかもしれません。センサーが300度ファーレンハイトを読み取ることができない場合、データがセンサーの読み取りが300度ファーレンハイトを示している場合、あなたの異常があります。明確なしきい値が破られています。
初期の異常アルゴリズムにおける詐欺検知は、データが意味を持っていたために機能する可能性がありました。データは構造化されており、人々がすでにデータ収集のための解釈可能な設定を作成していました。彼らのデータは重要性を持っていたため、ランダムツリーを作成し、詐欺を探すことが可能でした。
しかし、ダークデータや非構造化データ、例えばピクセルのシーケンスとしてエンコードされた画像や文字のシーケンスとしてエンコードされた言語は、ほとんど解釈を持たず、古いアルゴリズムを無効にします...データが構造化されるまで。構造は畳み込みニューラルネットワーク(CNN)の最後の層や、あらゆる種類のソートアルゴリズムで見つけることができます。
大規模なデータセットが必要
第二に、大規模なデータセットが必要です。良い機械学習モデルの基礎となる原則は、データセットが必要であることです。法則のように、主張を支持するデータがなければ、その主張は裁判で成立しません。
機械学習はデータセットを必要とします。予測を検証できる場合にのみ推論がなされます。異常検知は、異常が稀であるという仮定から、さらに大規模なデータを必要とします。
豊かさの存在下でのみ希少性が生じる。
必要な才能
第三に、機械学習エンジニアが必要です。明白ですが、時には見落とされがちです。機械学習の才能は商品ではなく、自動車修理工場のように、すべてのエンジニアが同じであるわけではありません。
良い機械学習モデルを構築するには、スキルと技術が必要です。異常検知器を95%の検出から98%の検出に引き上げるためのコストは、数年と数人のML雇用者になる可能性があります。
3つの設定における異常検知
2018年の講義で、オレゴン州立大学のトーマス・ディッタリッヒ博士と彼のチームは、異常検知が3つの異なる設定の下でどのように発生するかを説明しています。これらはすべてデータの状態に依存しています。3つの設定は:
- 監視済み
- クリーン
- 非監視

それぞれの設定を詳細に見てみましょう。
1. 監視済み
トレーニングデータには「名目」または「異常」ラベルが付けられています。
監視済み設定は理想的な設定です。これは、データセットが異常または名目としてすべてのデータポイントにラベルが付けられて整然と準備されている場合です。この場合、すべての異常なポイントは事前に知られています。つまり、異常であるがモデルが学習するために特定されていないデータポイントのセットがあります。
構造化データ用の人気のMLアルゴリズム:
- サポートベクターマシン
- k最近傍法(KNN)
- ベイジアンネットワーク
- 決定木
2. クリーン
クリーン設定では、すべてのデータは「名目」と仮定され、異常なポイントで汚染されています。
クリーン設定は、モデルに提示されるデータがクリーンで完全であるが、すべてのデータが名目データポイントであると仮定されている、理想的ではないケースです。したがって、モデルはこのデータセット内の異常を検出することになります。
3. 非監視
非監視設定では、トレーニングデータにはラベルが付けられておらず、「名目」と「異常」ポイントで構成されています。
最も難しいケースであり、モデル作成者にとってますます増加しているケースは、非監視の場合です。非監視ケースのデータセットには、名目または異常としてラベル付けされていないパーツがあります。期待される結果の基準となる真実はありません。モデルは、モデル作成者に異常であるものと名目であるものを示さなければなりません。
「非監視学習における最も一般的なタスクは、クラスタリング、表現学習、および密度推定です。これらのすべてのケースで、明示的に提供されたラベルを使用せずに、データの固有の構造を学ぶことを望みます。」- デビン・ソニ
非監視設定では、非構造化データに秩序を作るために異なるツールが必要です。非構造化データでは、主な目標はデータからクラスタを作成し、次に属さない少数のグループを見つけることです。実際、すべての異常検知アルゴリズムは、近似密度推定の一形態です。
非構造化データ用の人気のMLアルゴリズムは:
- 自己組織化マップ(SOM)
- K-means
- C-means
- 期待値最大化メタアルゴリズム(EM)
- 適応共鳴理論(ART)
- 一クラスサポートベクターマシン

ディッタリッヒ博士の講義スライドから、非監視設定の場合の異常検知戦略は2つのケースに分類されます:

機械学習が適切でない場合、トップの非ML検出アルゴリズムには以下が含まれます:
- IFOR: アイソレーションフォレスト(Liu, et al., 2008)
- LODA: 軽量オンライン異常検出器(Pevny, 2016)
異常検知のベンチマーキング
エンジニアは、アルゴリズムのパフォーマンスを比較できるようにベンチマークを使用します。異なる種類のモデルは異なるベンチマーキングデータセットを使用します:
- 画像分類にはMNISTとIMAGENETがあります。
- 言語モデルにはPenn TreeBankとWiki Text-2があります。
異常検知では、まだ標準となるデータセットは存在しません。これは、一部はアプリケーションの多様性に起因しています。しかし、ある研究の一部が継続的な存在として浮上しています—Numenta異常ベンチマーク。GitHubリポジトリから:
「NABは、ストリーミングおよびリアルタイムアプリケーションにおける異常検知アルゴリズムを評価するための新しいベンチマークです。50以上のラベル付き実世界および人工タイムシリーズデータファイルと、リアルタイムアプリケーション用に設計された新しいスコアリングメカニズムで構成されています。」
これまで、NABベンチマークで最も良いパフォーマンスを発揮する異常検知アルゴリズムは、リアルタイムデータセットの70%の異常をキャッチしています。
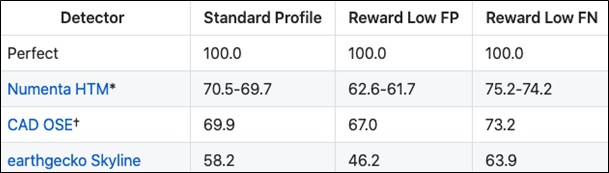
機械学習による異常検知を始める
機械学習による異常検知を始めたい場合は、こちらから始めることをお勧めします:
- Pinterestにおける時系列のためのリアルタイム異常検知システムの構築(ソフトウェアエンジニアのケビン・チェンとブライアン・オーバーストリート)
- Pythonにおける異常検知技術(クリストファー・ホセ)
- scikit-learn機械学習による外れ値および異常検知(ウォーカー・ロウ)
追加リソース
このトピックおよび関連トピックについては、以下のリソースを探求してください:
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも表すものではありません。