




ポイント: Apache SparkとHiveを使用することで、Sparkのインメモリ機能を活用してデータ処理速度が向上します。このガイドには、インストールの前提条件、設定手順、およびSpark上でHiveジョブを実行するための手順が含まれています。
- 前提条件には、HiveとSparkのインストール、環境変数の設定が含まれます。
- 手順は、jarファイルのリンク、Sparkの開始、およびHiveコマンドの実行について説明しています。
ここでは、Apache SparkをHiveとどのように使用するかを説明します。これは、HiveがデータをHadoopに保存するのではなく、Sparkに保存することを意味します。人々がHadoopではなくSparkを使用する理由は、全メモリデータベースであるためです。したがって、Hiveジョブはそこでずっと速く実行されます。さらに、会社が主にSparkを実行している場合、プログラマーが共通のデータベースを使用する方向に進むことができます。また、Sparkでプログラムを書いて、それを使用してHiveデータに接続することも可能です。つまり、逆の方向に進むことです。しかし、Sparkを使用している場合は、すでにHadoopの代わりにRDD(Sparkのインメモリストレージ)を使用するという考えに同意しているため、これはあまり起こりそうな使用ケースではありません。とにかく、ここでは最初のオプションについて説明します。
前提条件とインストール
- Hiveをインストールする必要があります。
- Hadoopのjarsがすでに含まれていないSparkのバージョンを持つために、ソースコードからApache Sparkをインストールします(下で説明します)。
- それに応じてHIVE_HOMEとSPARK_HOMEを設定します。
- Hadoopをインストールします。Yarnリソーススケジューラがそこにあり、jarファイルがあるため、使用しません。しかし、HiveとSparkのクラスターを実行している場合、HDFS(Hadoop分散ファイルシステム)にコピーして作業ノードにjarファイルを配布するためにHadoopを使用できます。
ここでの手順はSpark 2.2.0とHive 2.3.0のものです。下記のディレクトリ名とjarファイル名を、使用しているバージョンに合わせて入れ替えてください。Sparkのjarファイルを探すとき、いくつかのケースでは複数のコピーが存在することがあります。以下に示すようにdistフォルダー内のものを使用してください。)まず、Sparkのソースコードをダウンロードする必要があります。それを次のようにコンパイルします:
./dev/make-distribution.sh --name "hadoop2-without-hive" --tgz "-Pyarn,hadoop-provided,hadoop-2.7,parquet-provided"
次に/usr/share/spark/spark-2.2.0/conf/spark-env.shを更新し、次を追加します:
export SPARK_DIST_CLASSPATH=$(hadoop classpath)
Jarファイルのリンク
Hiveがそれらを見つけられるように、特定のSpark jarファイルへのソフトリンクを作成します:
    ln -s /usr/share/spark/spark-2.2.0/dist/jars/spark-network-common_2.11-2.2.0.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/spark-network-common_2.11-2.2.0.jar
ln -s /usr/share/spark/spark-2.2.0/dist/jars/spark-core_2.11-2.2.0.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/spark-core_2.11-2.2.0.jar
ln -s /usr/share/spark/spark-2.2.0/dist/jars/scala-library-2.11.8.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/scala-library-2.11.8.jar
Sparkのマスターとワーカーを開始:
今、Sparkを開始します。
$SPARK_HOME/sbin/start-all.sh
ログファイルを含むディレクトリを作成します:
mkdir /var/log/spark
$HIVE_HOME/conf/hive-site.xmlを編集します:
    hive.execution.engine
spark


spark.master
spark://(your IP address):7077


spark.eventLog.enabled
true


spark.eventLog.dir
/var/log/spark


spark.executor.memory
2048m


spark.serializer
org.apache.spark.serializer.KryoSerializer
Hiveの実行
以下に示すようにHiveを実行します。クラスターを使用するのではなく、ローカルモードで実行しています。何かがうまくいかなかった場合に備えて、Hiveにエラーをコンソールにログ記録させるように指示しています。また、最新のHive CLIであるbeelineではなく、hiveを使用していることにも注意してください。HiveはユーザーにBeelineを使用させたいと考えていますが、必ずしも必要ではありません。(beelineの使用方法についてはこちらに記載しました。)
hive --hiveconf hive.root.logger=INFO,console
/usr/hadoop/hadoop-2.8.1/etc/hadoop/yarn-site.xmlを編集します。
    yarn.resourcemanager.scheduler.class
org.apache.hadoop.yarn.server.resourcemanager.scheduler.fair.
FairScheduler
データの作成
今、テーブルを作成し、いくつかのデータを挿入します。コマンドを入力した後、実行されるまでに数秒待つ必要があります。これはSparkとYarnを使用しているためです。これは、クラスター全体で実行されるように設計されています。
    create table students (student string, age int);
insert into table students values('Walker', 33);
画面はこのようになります:
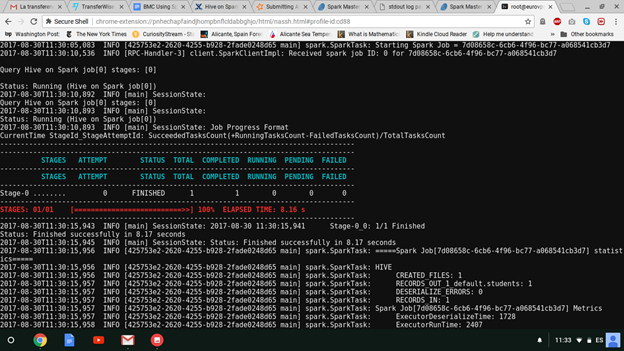
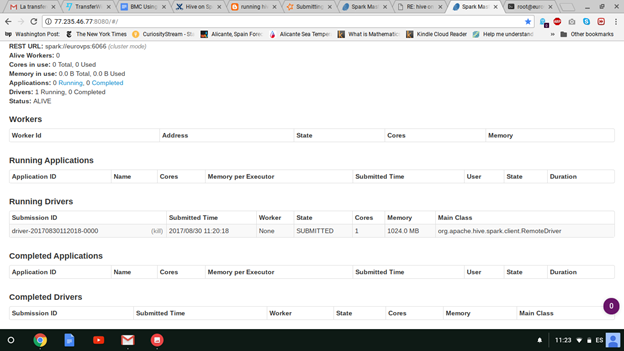
ジョブが開始されるまでに時間がかかるため、8080ポートのSpark URLを開いて実行中のプログラムを見る時間があります。ジョブが完了すると、Sparkはそれらを削除しますが、Spark Job History Serverを実行している場合を除きます。
これで完了です。
Apache Sparkガイド
- Apache Sparkの機械学習パイプライン: 入門
- Apache Sparkを使用したSGD線形回帰の例
- Spark決定木分類器
- ロジスティック回帰、Scala、およびSparkの使用
- Apache SparkとJupyterノートブックの使用方法
- PythonとSparkの機械学習を使用して分類する
- PythonでSpark UDF(ユーザー定義関数)を書く方法
- Python Spark ML K-Meansの例
- サイバーセキュリティに機械学習を適用する方法
- Apache Spark: ストリームの操作
- Apache SparkによるK-meansクラスタリング
- SparkとHiveの使用
- 予防保全のために予測を行うためのApache Sparkの使用方法
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。