




ポイント: Apache Sparkは、DStreamsを使用してストリーミングデータのリアルタイム処理を可能にし、連続した入力を通常のRDDに変換します。このガイドでは、PythonとScalaを通じて株価を読み取る方法を説明し、バッチデータとストリーミングデータの違いを強調します。
- ストリーミングデータは、無限の入力の即時処理を可能にします。
- 例として、株価の取得にYahoo Finance APIを使用します。
前回の二つの投稿では、TwitterからApache SparkにKafka経由でデータストリーミングを読み込む方法を説明しました。ここでは、テキストファイルをストリームとしてSparkに読み込むよりシンプルな例を見ていきます。
Zeppelinでコードを実行すると、以下の画面のようなシンプルな株式ティッカーを作成します。
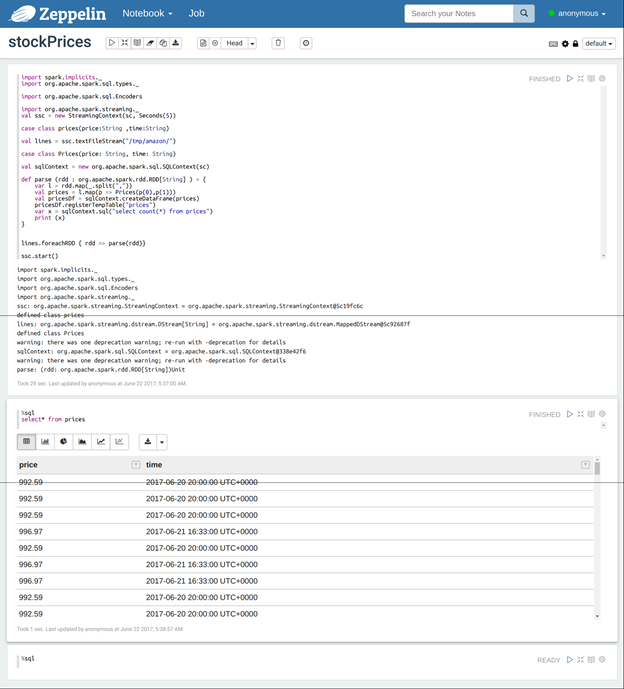
ストリーミングデータを扱うことは、バッチデータを扱うこととはかなり異なります。Spark Streamingは、ストリーミングデータをDStreamsと呼ばれるオブジェクトに読み込みます。これらから定期的に通常のRDDを作成します。
したがって、入力が固定サイズのファイルではなく、Twitterのツイート、ジェットエンジンからの診断情報、NASDAQからの株価などの無限ストリームであるという重要な違いがあります。
この株価の例を使って説明します。Yahoo Finance APIを使用します。次のようにインストールします:
sudo pip install yahoo-finance
次に:
mkdir /tmp/amazon/
このPythonコードをテキストファイルyahoo.pyにコピーし、実行します:
python yahoo.py
これにより、Amazonの株価がダウンロードされ、5秒ごとにファイルに書き込まれます。
    from yahoo_finance import Share
import time
f = open('/tmp/amazon/amzn.csv', 'w')
while True:
amzn=Share("AMZN")
s = amzn.get_price() + "," + amzn.get_trade_datetime() + '\n'
print (s)
f.write (s)
f.flush()
time.sleep(5)
del amzn
以下は、ストリームとしてこのデータを処理するために使用する全体のScalaプログラムです。これは単純な例です。おそらく、Twitterの例のように、まずKafkaにストリーミングデータを書き込むことで処理することになるでしょう。しかし、この単純な例は、ストリーミングデータを扱う方法を理解するのに役立ちます。
Spark Streamingは実際にはテキストファイルを非常によく処理するわけではありません。以下で説明するように、テキストファイルの変更を追跡することができません。そのため、Sparkが変更を認識するために、これらのファイルを新しいフォルダーにコピーする必要があります。これはストリーミングアプリケーションにはあまり実用的ではありません。しかし、これは教示的な例に過ぎません。Kafkaを使用するか、データソケットを読み取る方が一般的です。ただし、このコードは、アプリケーションがログファイルを切り替えるような状況には適しています。WebサーバーやLDAPサーバーのように、そこでは定期的にオープンファイルを閉じて新しいファイルを作成します。
上記のPythonプログラムを開始した後、spark-shellを実行し、以下の全コードをSparkコマンドラインインタプリタに貼り付けます。作業を始めるのに数分かかります。その後、画面を占有し、出力をエコーし始めます。
ここでは、コードをセクションに分けて、重要な部分を説明します。
Scalaコード
ここでの重要なコマンドはnew StreamingContextとssc.textFileStreamです。
最初のものは、SparkContext(spark-shellを使用するときはscと呼ばれます)を取り込み、StreamingContextを作成します。これは、SparkContextと同じアイデアですが、ストリーミングデータ用です。
ssc.textFileStreamは、指定されたフォルダーの中を見て、そのデータをDStreamsに読み込みます。どんな形式にも関係なく、情報のバイトを読み取っています。したがって、まだRDDや他の構造を作成していない状態で情報を取得しています。
    import spark.implicits._
import org.apache.spark.sql.types._
import org.apache.spark.sql.Encoders
import org.apache.spark.streaming._
val ssc = new StreamingContext(sc, Seconds(5))
val lines = ssc.textFileStream("/tmp/amazon/")
Pythonプログラムは、株価と時間をこのカンマ区切りの形式でテキストファイルに書き込みます:
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
次のセクションは、この種のテキストファイルの各行を読み取り、各行をカンマで分割するために使用する、見慣れたコードです。重要な違いは、Sparkがストリーミングデータで作業する際に複数のRDDを作成することです。したがって、parseという関数をパラメータータイプorg.apache.spark.rdd.RDD[String]で作成しましたので、以下に示すようにlines.foreachRDD { rdd => parse(rdd)}で各RDDを処理します。
言い換えれば、ここが重要な違いです。SparkはたくさんのRDDを返し、私たちはdstream.foreachRDDを使用してそれらを処理します。
残りのコードは、case classを作成し、それを使用してsqlContext.createDataFrameでSQLデータフレームに変換します。
    case class Prices(price: String, time: String)
val sqlContext = new org.apache.spark.sql.SQLContext(sc)
def parse (rdd : org.apache.spark.rdd.RDD[String] ) = {
var l = rdd.map(_.split(","))
val prices = l.map(p => Prices(p(0),p(1)))
val pricesDf = sqlContext.createDataFrame(prices)
pricesDf.registerTempTable("prices")
pricesDf.show()
var x = sqlContext.sql("select count(*) from prices")
println (x)
}
作成された各rddに対してparse関数を呼び出します。
lines.print()は、RDDの最初の10行を生の形式でエコーします。
コマンドラインインタプリタでは、ssc.start()を実行するまで何も起こりません。その時点で、プログラムは新しいファイルが/tmp/amazonに追加されるのを継続的に探し、各ファイルを処理します。キーボードからの入力を受け付けなくなり、画面に結果をエコーします。
    lines.foreachRDD { rdd => parse(rdd)}
lines.print()
ssc.start()
このコードを実行すると、開始に少し時間がかかりますので、数秒待ってください。
最初に、プログラムは見つけたデータをエコーします。これは、pricesDf.show()を使用したためです。
+------+-------------------------------+ |price|time| +------+-------------------------------+ |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |996.97|2017-06-21 16:33:...|
ここで事態が奇妙になります。2回目の反復では空のデータフレームが表示されます。なぜですか?
+-------+-------+
|price |time|
+-------+-------+
+-------+-------+
データフレームが空である理由は、Pythonプログラムがまだデータを書き込んでいるにも関わらず、Apache Sparkによって書かれたtextFileStreamのJavaDoc定義を見て理解するのが最も良いでしょう。
public JavaDStream<String> textFileStream(String directory)
新しいファイルを監視し、テキストファイルとして読み取る入力ストリームを作成します(キーはLongWritable、値はText、入力形式はTextInputFormatです)。ファイルは、同じファイルシステム内の別の場所から「移動」することによって監視されたディレクトリに書き込まれなければなりません。名前が.で始まるファイルは無視されます。
言い換えれば、/tmp/amazonフォルダーに新しいファイルを手動でコピーするまで新しいデータは見つかりません。これは不便であり、シェルスクリプトで行うことができます。/tmp/amazon/amzn.csvファイルを/tmp/amazon/aにコピーし、再度spark-shellの出力を見てみてください。新しいデータが取得されているのがわかります。
したがって、Apache Sparkを使用してストリーミングデータを処理する方法の例を示しました。ここから、学んだことを強化するためにTwitterの例に戻って復習することをお勧めします。あるいは、tcpソケットを使用して独自の例を書くことができます。
Apache Sparkガイド
- Apache Sparkの機械学習パイプライン: 入門
- Apache Sparkを使用したSGD線形回帰の例
- Spark決定木分類器
- ScalaとSparkを使用したロジスティック回帰
- Apache SparkでJupyterノートブックを使用する方法
- PythonとSpark機械学習を使用した分類
- PythonでのSpark UDF(ユーザー定義関数)の書き方
- Python Spark ML K-Meansの例
- サイバーセキュリティに機械学習を適用する方法
- Apache Spark: ストリームでの作業
- Apache SparkでのK-meansクラスタリング
- HiveとSparkを使用する
- 予防保守のためにApache Sparkを使用して予測を行う方法
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも表しているわけではありません。