




ポイント: Apache Sparkによるk-meansクラスタリングは、アメリカの危険な州を特定するために犯罪統計を分析します。このチュートリアルでは、データ準備、クラスタリングの実装、ZeppelinノートブックでのSQLクエリを使用した結果の視覚化をカバーします。
- クラスタリング分析のために犯罪データを利用します。
- データ処理とモデル訓練のためにScalaコードを含みます。
ここでは、k-meansクラスタリングの使い方の簡単な例を示します。アメリカの異なる州の犯罪統計を見て、最も危険な州と最も安全な州を示します。データはこちらから取得しました。データはこのようになります。列は州、クラスタ、殺人率、暴力、人口、強姦です。すでにクラスタ列が含まれているので、これを削除します。なぜなら、データポイントを好きなだけのクラスタにクラスタリングできるからです。このデータセットは他の値を使用しました。また、人口は正規化された値であり、実際の人口ではないことに注意してください。これは小さなスケールの数値であり、統計の一般的なアプローチです。データを読み込むために列見出しを削除します。後で戻します。
| crime$cluster | 殺人 | 暴行 | 都市人口 | 強姦 | |
|---|---|---|---|---|---|
| アラバマ | 4 | 13.2 | 236 | 58 | 21.2 |
| アラスカ | 4 | 10 | 263 | 48 | 44.5 |
| アリゾナ | 4 | 8.1 | 294 | 80 | 31 |
| アーカンソー | 3 | 8.8 | 190 | 50 | 19.5 |
| カリフォルニア | 4 | 9 | 276 | 91 | 40.6 |
| コロラド | 3 | 7.9 | 204 | 78 | 38.7 |
以下はScalaコードです。これをZeppelinノートブックに貼り付けます。Zeppelinはグラフをきれいに表示します。(以前書いたApache SparkとのZeppelinの使用についてはこちらを読んでください。)まず、通常のインポートを行います:
    import org.apache.spark.mllib.clustering.{KMeans, KMeansModel}
import org.apache.spark.mllib.linalg.Vectors
import sqlContext.implicits._
import org.apache.spark.sql.types._
次に、Hadoopにコピーしたcrime_data.csvファイルから犯罪データRDDを作成します。
var rdd = sc.textFile("hdfs://localhost:9000/data/crime_data.csv")
さて、機械学習アルゴリズムに送信されるデータは数値である必要があります。したがって、このアルゴリズムは文字列をバイトに変換し、次にダブルに変換します。それから、各バイトグループをループし、合計して、州のテキストフィールドのエンコードされた値となる単一の合計数を作成します。
    def stoDouble (s : String): Double = {
return s.map(_.toByte.doubleValue()).reduceLeft( (x,y) => x + y)
}
当然、その数値をテキストに戻して、どの州を扱っているのかを確認する必要があります。したがって、ケースクラスを作成します。データフレームを作成したいときにそれを行います。データフレームはSQLを使用したいときに作成します。SQLは扱いやすいです。
    case class StateCode(State:String, Code:Double)
var lines = rdd.map(l => l.split(","))
var states = lines.map(l => StateCode(l(0),stoDouble(l(0)))).toDF()
states.show()
states.createOrReplaceTempView("states")
ここでは、入力データファイルの各行をダブルの配列にします。
    def makeDouble (s: String): Array[Double] = {
var str = s.split(",")
var a = stoDouble(str(0))
return Array(a,str(2).toDouble,str(3).toDouble,str(4).
toDouble,str(5).toDouble)
}
var crime = rdd.map(m => makeDouble(m))
次に、密なベクトルというオブジェクトを作成します。Sparkのk-means分類アルゴリズムはその形式を必要とします。それから、trainメソッドを実行して、機械学習アルゴリズムが犯罪率と人口に基づいて州をクラスタにグループ化させます。5つのクラスタを使用するように指示します。10または任意の数を指定してもよかったのです。クラスタの数が多いほど、データがより細分化されます。
    val crimeVector = crime.map(a => Vectors.dense(a(0),a(1),a(2),a(3),a(4)))
val clusters = KMeans.train(crimeVector,5,10)
次に、別のケースクラスを作成して、最終結果が名前の列を持つデータフレームにされるようにします。ここでは、すべての日付と密なベクトルオブジェクト、さらにk-meansアルゴリズムに基づいてSparkが行う予測を持っています。ここで注意すべき点は、Sparkが密なベクトルをSQL列にすることに問題がないことです。トレーニングセットからのクラスタ値が予測を作成するために使用されます。それを犯罪ケースクラスにも追加します。
    case class Crime (Code:Double, Murder:Double, Assault:Double, UrbanPop:Double,Rape:Double, PredictionVector:org.apache.spark.mllib.linalg.Vector, Prediction:Double)
val crimeClass = crimeVector.map(a => Crime(a(0), a(1), a(2), a(3), a(4), a ,clusters.predict(a))).toDF()
crimeClass.show()
crimeClass.createOrReplaceTempView("crimes")
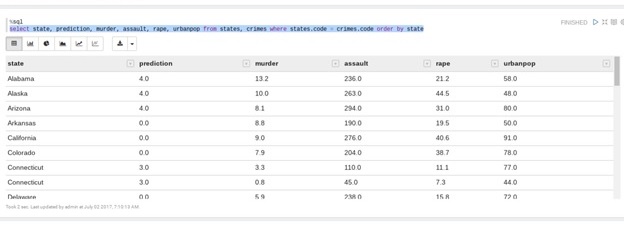
最後に、州と予測の2つのテーブルを結合する必要があります。なぜなら、州名を表示したいからであり、変換した数値ではなくて。%sql行に注意してください。Zeppelinノートブックでは、SQLを使用したいことを意味します。crimeClass.createOrReplaceTempView("crimes")で、SQLでクエリを実行できる一時ビューを作成しました。%sqlを使用すると、Zeppelinは自動的に異なるグラフを作成するオプションを提供します。
    %sql
select state, prediction, murder, assault, rape, urbanpop from states, crimes where states.code = crimes.code order by state
ここで、オプションをテーブルとして出力します。円グラフ、棒グラフ、その他を作成することもできました。ご覧のとおり、コロラドのように、アラバマを避けるべきです。
Apache Sparkガイド
- Apache Sparkの機械学習パイプライン:入門
- Apache SparkによるSGD線形回帰の例
- Spark決定木分類器
- ScalaとSparkを用いたロジスティック回帰の使用
- Apache SparkでのJupyterノートブックの使用方法
- PythonとSpark機械学習を用いた分類
- PythonでのSpark UDF(ユーザー定義関数)の書き方
- Python Spark ML K-Meansの例
- サイバーセキュリティへの機械学習の適用方法
- Apache Spark:ストリームとの作業
- K-meansクラスタリングとApache Spark
- HiveとのSparkの使用
- 予防保守のための予測を行うためのApache Sparkの使用方法
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を表すものではありません。