




ポイント: Apache Sparkで確率的勾配降下(SGD)を使用した線形回帰は、効率的な予測モデルを可能にします。このチュートリアルは、Scalaでモデルを実装するための包括的なガイドを提供し、データ処理、トレーニング、エラー計算をカバーします。
SGDは特定の分析課題に合わせて調整されています。
平均二乗誤差(MSE)はモデルの精度を評価するために利用されます。
Apache Sparkの機械学習パイプラインについて詳しく学びましょう。
この記事では、Apache Sparkを使用した線形回帰の方法を説明します。線形回帰についての基本的な知識があることを前提としています。もしそれがない場合は、統計学における最も簡単な概念の1つであるため、学ぶ必要があります。また、ほとんどの機械学習モデルはこの基本的なアイデアの拡張です。理解しやすく、使用も簡単なため、Google SheetsやMicrosoft Excelで実行できます。ただし、それらのツールでは1つの入力変数に制限されています。ここでの例は約12個の変数を持っています。目的は、予測モデルを作成するための式を開発することです。高校で学んだモデルは、bが直線がy軸を交差する点であることを示しています。
y = mx + b
例えば、売上と広告費が関連していると仮定できます。したがって、次のように記述できます:
    y = mx + b
= sales = some function of (advertising expenses ) + constant_value (b)
= (number of ads purchased (m))* (average age cost of ad ( x)) + b.
この場合、bの値は0です。広告を購入しないことは支出がないことを意味します。この問題を解決するための古典的な方法は、データを真ん中で最も近く分割する線を見つけることです。
y = mx + b
そのためには、データポイントからの平均距離が最小の線を見つけます。
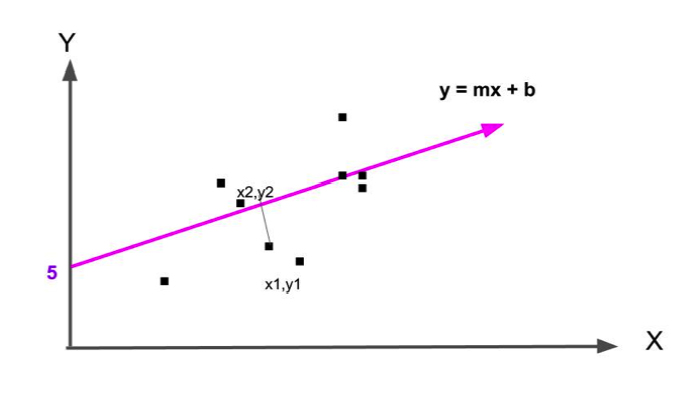
Apache Sparkでその線を見つける最も簡単な方法は、次のようにします:
org.apache.spark.mllib.regression.LinearRegressionMode.
しかし、より洗練されたアプローチは次のとおりです:
org.apache.spark.mllib.regression.LinearRegressionWithSGD
ここで、確率的勾配降下を意味します。この文書の範囲を超える理由から、SGDは特定の分析の問題に対して他のものよりも適しています。どのアルゴリズムが最も適しているかは、どの推定が最も良いか、アルゴリズムの効率、アルゴリズムが過剰適合(偏見のある仮定によって歪んだ推定につながる)する傾向、外れ値に対する感度(他のデータポイントから遠く離れたデータポイントがあると推定が混乱すること)など、さまざまな要因に基づいています。どのモデルを使用すべきかを知る唯一の方法は、予測値と観測値の間の差が最も小さいモデルを見つけることです。これがデータサイエンティストの仕事です - 彼らはさまざまなモデルを試します。
Apache SparkとScalaを使用した線形回帰のコーディング方法
このデータをダウンロードします:https://raw.githubusercontent.com/cloudera/spark/master/mllib/data/ridge-data/lpsa.dataこのデータが何であるかは重要ではありません。列の見出しやこのデータが何を意味しているのかを知ることには興味がありません。私たちはただ線形回帰を行う方法を示したいだけで、相関するデータが必要です。多くのデータが全く相関しないため、線形回帰や統計が適合しません。例えば、ガソリン価格とガソリン販売は、価格に関係なく人々がガソリンを購入するため、ほとんど相関がありません。最初に全体のコードを示し、その後行ごとに説明します。
    import org.apache.spark.mllib.linalg.Vectors
import org.apache.spark.mllib.regression.LabeledPoint
import org.apache.spark.mllib.feature.Normalizer
import org.apache.spark.mllib.regression.LinearRegressionWithSGD
val data = sc.textFile("/home/walker/lpsa.dat")
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
val numIterations = 100
val stepSize = 0.00000001
val model = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
val valuesAndPreds = parsedData.map { point =>
val prediction = model.predict(point.features)
(point.label, prediction)
val MSE = valuesAndPreds.map{ case(v, p) => math.pow((v - p), 2) }.mean()
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val d = y.size - 1
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
}.cache()
val numIterations = 100 val stepSize = 0.00000001
val model = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
val valuesAndPreds = parsedData.map { point =>
val prediction = model.predict(point.features)
(point.label, prediction)
}
-0.4307829,-1.63735562648104 -2.00621178480549 -1.86242597251066 -1.02470580167082 -0.522940888712441 -0.863171185425945 -1.04215728919298 -0.864466507337306
それにより、RDD[String]としてデータが作成されます。
val data = sc.textFile("/home/walker/lpsa.dat")
文字列は反復可能なオブジェクトであるため、スペースで分割するために2回ループします。データに最初の2つの要素がカンマで区切られているので、最初のものを取り除く必要があるため、2回行います。
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
次に、これらの文字列をすべてDoubleに変換します。機械学習は数値を必要とし、この特定のアルゴリズムはDoubleのベクトルを必要とします。
val y = x.map{ (a => a.toDouble)}
LabeledPointは線形回帰アルゴリズムに必要なオブジェクトです。この形式である必要があります
(labels, features)
特徴はベクトルです。ここでは、空白の値を処理しない密なベクトルを使用しますが、私たちにはそれがありません。
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val d = y.size - 1
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
}.cache()
キャッシュという言葉を使用する理由に注意してください。なぜなら、Sparkは分散システムだからです。この計算を行うには、各ノードからデータを取得する必要があります。キャッシュは、collectと同様に、ノード全体のすべての要素を集めます。
テストデータを使用したトレーニング
この例では、トレーニングセットを<強>テストデータとしても使用します。これは、両方が実際のデータの真のサンプルを表す場合、概念的にはほぼ同じであるため、イラストレーションの目的には問題ありません。実際には、トレーニングデータ(lpsa.datファイルのような)でトレーニングします。その後、新しいデータに基づいて予測を行います。このデータはテストデータと呼ばれますが、より良い名前はライブデータであるべきです。2つのパラメータがあります:numIterations とstepSize、およびLabeledPointがあります。これらが何を意味するかを理解するには、確率的勾配降下のロジックと数学を理解する必要がありますが、ここでは複雑なため説明しません。基本的には、アルゴリズムが推定を調整し続ける回数を意味し、誤差が可能な限りゼロに近づくポイントに集中します。これを収束と呼びます。
val numIterations = 100
val stepSize = 0.00000001
val model = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
モデルをテストする
では、モデルがどれだけうまく機能しているかを確認するために、LabelPointをループして、各々にpredict()メソッドを実行し、新しいRDD(double, double)を作成します。これはラベル(yまたは独立変数、つまり観測された結果y)と予測(SGDアルゴリズムによって決定された回帰式に基づく推定)です。
val valuesAndPreds = parsedData.map { point =>
val prediction = model.predict(point.features)
(point.label, prediction)
}
エラーを計算する
エラーが0であれば、完璧なモデルを持っていることを意味します。以下に示すように、モデルはラベルが高くなるまで値を予測するのが得意ではありません。全体のモデルに対するエラーは:
    println("training Mean Squared Error = " + MSE)
training Mean Squared Error = 7.451030996001437
MSEは平均((予測値 - 実際の値)** 2(平方))の違いを意味します。予測が実際の値とほぼ等しい場合、MSEは0に近くなります。
    valuesAndPreds.foreach((result) => println(s"predicted label: ${result._1}, actual label: ${result._2}"))
predicted label: -0.4307829, actual label: -6.538896995115336E-8
...
predicted label: 1.446919, actual label: 1.7344923653317994E-7
...
predicted label: 2.6567569, actual label: 3.4906394367410936E-7
predicted label: 1.8484548, actual label: 2.592863859023973E-7
....
predicted label: 2.2975726, actual label: 3.16412860478681E-7
predicted label: 2.7180005, actual label: 3.4164515319254127E-7
predicted label: 2.7942279, actual label: 3.448229999917885E-7
predicted label: 2.8063861, actual label: 3.5506022919177794E-7
predicted label: 2.8124102, actual label: 3.64517218758205E-7
predicted label: 2.8419982, actual label: 3.508992428582512E-7
...
predicted label: 4.029806, actual label: 5.019849314865162E-7
predicted label: 4.1295508, actual label: 5.211902354094908E-7
predicted label: 4.3851468, actual label: 5.732554699437345E-7
predicted label: 4.6844434, actual label: 6.026343831319147E-7
predicted label: 5.477509, actual label: 7.208914981741786E-7
Apache Sparkガイド
- Apache Sparkの機械学習パイプライン:入門
- SGD線形回帰の例とApache Spark
- Spark決定木分類器
- ScalaとSparkを使用したロジスティック回帰
- Apache SparkでJupyterノートブックを使用する方法
- PythonとSparkの機械学習を使用して分類を行う
- PythonでSparkのUDF(ユーザー定義関数)を書く方法
- Python Spark ML K平均の例
- 機械学習をサイバーセキュリティに適用する方法
- Apache Spark:ストリームの操作
- Apache SparkによるK平均クラスタリング
- HiveとSparkを使用する
- 予防保守のための予測を行うためのApache Sparkの使用方法
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。