




ポイント: データはApache SparkとK-Meansアルゴリズムを使用して異なるグループにクラスタリングでき、チュートリアルでデモされています。コード例が含まれており、シルエットスコアや二乗誤差の合計などの指標を通じてクラスタリングの効果を評価します。
- クラスタは重心とハイパープレーンを使用してデータポイントに基づいて形成されます。
- 評価指標にはシルエットスコアと二乗誤差の合計が含まれます。
この記事では、Apache SparkとSpark ML K-Meansアルゴリズムを使用して、データを「クラスタ」と呼ばれる異なるグループに分ける方法を示します。このアプローチは、共通の特性に基づいて分けたいあらゆる種類のデータに対応します。このデータは、心臓病のある患者とない患者を示しています。このデータをロジスティック回帰を使用して既に見ています。分類は、どの患者が心臓病を持っているかを教えてくれるわけではありません(それは前回の投稿でロジスティック回帰が行ったことです)が、健康の指標が入力データであるため、一方の患者が病気で他方がそうでないことを論理的に推測できます。
Spark ML K-Meansアルゴリズムの理解
分類は、n次元空間の中でこのデータを最も近くに分離する座標を見つけることで機能します。これを3D空間の平面として考えてください: 一方の側には一つのクラスタに属するデータポイントがあり、もう一方には別の側にあります。この例では、12のデータ特徴(データポイント)があり、下に示される座標を持つ平面があります。それは平面そのものではなく、3次元以上の次元があるため、ハイパープレーンと呼ぶことができます。(それでも、この例を説明するための平面の精神的なイメージは十分に近いです。)以下では、データを二つのクラスタに分けており、なぜ二つの座標セットがあるのかを説明しています。これらが各クラスタの重心、または中央点です。より多くのクラスタに分けようとすると、データが十分に離れていないため、精度が低下します。
    [5.68235294e+01 5.68627451e-01 3.25490196e+00 1.35803922e+02
 3.00078431e+02 1.47058824e-01 1.18627451e+00 1.45225490e+02
 4.01960784e-01 1.09705882e+00 1.59803922e+00 8.23529412e-01]
[5.29821429e+01 7.44047619e-01 3.12500000e+00 1.28636905e+02
 2.19047619e+02 1.48809524e-01 9.22619048e-01 1.52380952e+02
 2.85714286e-01 1.02142857e+00 1.57738095e+00 5.77380952e-01]
以下のコードは、Zeppelinノートブックとして保存されたコードです。(このガイドの関連投稿では、データフィールドとSparkデータフレームの読み込み方法について説明しています。)データは同じですが、患者IDの列を追加しています。
    %spark.pyspark

def isSick(x):
    if x in (3,7):
        return 0
    else:
        return 1


import pandas as pd
from pyspark.sql.types import StructType, StructField, NumericType


cols = ('age',
      'sex',
       'chest pain',
       'resting blood pressure',
       'serum cholestoral',
       'fasting blood sugar',
       'resting electrocardiographic results',
       'maximum heart rate achieved',
       'exercise induced angina',
       'ST depression induced by exercise relative to rest',
      'the slope of the peak exercise ST segment',
      'number of major vessels ',
       'thal',
       'last')


data = pd.read_csv('/home/ubuntu/Downloads/heart.csv', delimiter=' ', names=cols)

data['isSick'] = data['thal'].apply(isSick)

rowCount = data['age'].count()
ids = np.arange(1,rowCount+1,1)
data['id'] = ids


df = spark.createDataFrame(data)


from pyspark.ml.feature import VectorAssembler

features =   ('age',
      'sex',
       'chest pain',
       'resting blood pressure',
       'serum cholestoral',
       'fasting blood sugar',
       'resting electrocardiographic results',
       'maximum heart rate achieved',
       'exercise induced angina',
       'ST depression induced by exercise relative to rest',
      'the slope of the peak exercise ST segment',
      'number of major vessels ')


assembler = VectorAssembler(inputCols=features,outputCol="features")

dataset=assembler.transform(df)
dataset.select("features").show(truncate=False)
以下のコードは、Spark MLのドキュメントから直接取得したもので、いくつかの修正が加えられています。アルゴリズムを使用する方法は一つだけです。いくつかの項目に注意してください:
- KMeans().setK(2).setSeed(1)—数字の2は、データを分けるクラスタの数です。この値ClusteringEvaluator()が0.5を下回ると、明確な分割ではないことがわかります。最適なクラスタ数を確認する別の方法は、エルボー曲線をプロットすることです。
- predictions = model.transform(dataset)—これにより、データフレームに予測列が追加され、どの患者がどのカテゴリに該当するかを示すことができます。
残りのコードは自明です。コードは各分割のクラスタ中心と二乗誤差の合計を印刷します。それはどのように機能するかの手がかりです: 各データポイントがクラスタの中心の推測からの距離を計算し、推測を調整し、最小値に達するまで繰り返します。この中央点からの各ポイントの距離は二乗されるため、距離は常に正です。目標は可能な限り最小の数を持つことです—すべてのデータポイント間の最短距離。
    %spark.pyspark

from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.clustering import KMeans

# Trains a k-means model.
kmeans = KMeans().setK(2).setSeed(1)
model = kmeans.fit(dataset)

# Make predictions
predictions = model.transform(dataset)

# Evaluate clustering by computing Silhouette score
evaluator = ClusteringEvaluator()

silhouette = evaluator.evaluate(predictions)
print("Silhouette with squared euclidean distance = " + str(silhouette))


# Evaluate clustering.
cost = model.computeCost(dataset)
print("Within Set Sum of Squared Errors = " + str(cost))

# Shows the result.
print("Cluster Centers: ")
ctr=[]
centers = model.clusterCenters()
for center in centers:
    ctr.append(center)
    print(center)
以下のアルゴリズムは二乗ユークリッド距離を示しています。
- この数が負の場合、データは全く分離できません。
- 1に近い値は最大の分離を示します。
- ゼロに近い値は、データがほとんど分離できないことを意味します。
この例では、0.57は悪くありません。
    Silhouette with squared euclidean distance = 0.5702065126840549
Within Set Sum of Squared Errors = 548301.9823949672
Cluster Centers:
[5.68235294e+01 5.68627451e-01 3.25490196e+00 1.35803922e+02
 3.00078431e+02 1.47058824e-01 1.18627451e+00 1.45225490e+02
 4.01960784e-01 1.09705882e+00 1.59803922e+00 8.23529412e-01]
[5.29821429e+01 7.44047619e-01 3.12500000e+00 1.28636905e+02
 2.19047619e+02 1.48809524e-01 9.22619048e-01 1.52380952e+02
 2.85714286e-01 1.02142857e+00 1.57738095e+00 5.77380952e-01]
視覚化を容易にするために、SparkデータフレームをPandasデータフレームに変換し、Zeppelin関数z.showを使用してテーブルをリストします。
    %spark.pyspark
pandasDF=predictions.toPandas()
centers = pd.DataFrame(ctr,columns=features)
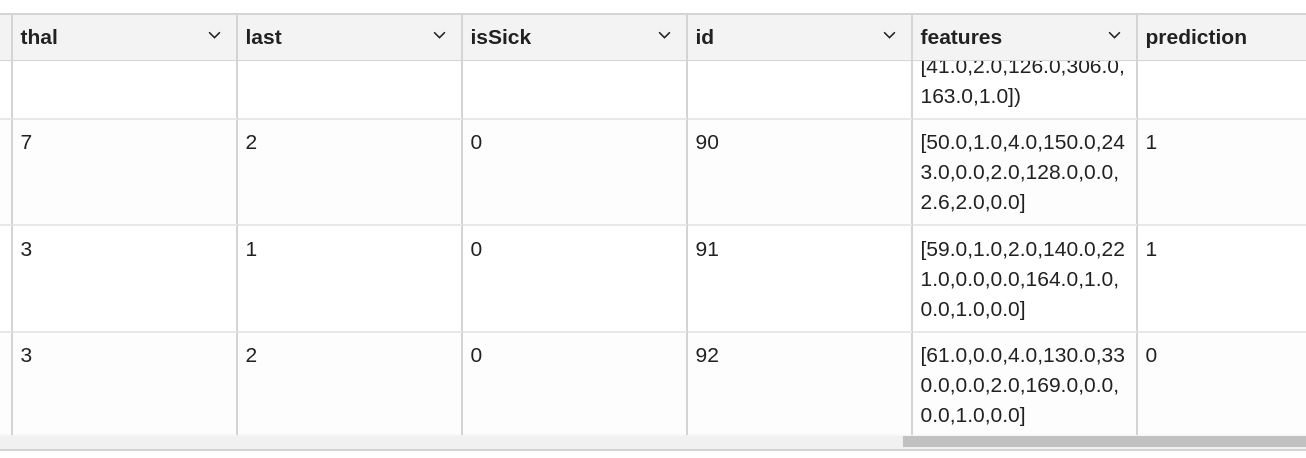
このデータをグラフ化することはできません。なぜなら、3Dグラフは3つの変数しかプロットできないからです。したがって、心臓病患者がどのように分離されているかを示すことはできませんが、z.display()を使用して表形式のレポートにまとめ、予測列を観察して、患者を一方または他方のカテゴリに配置します:
    %spark.pyspark
z.show(pandasDF)
見ての通り、患者90と91はクラスタ1に、患者92はクラスタ0にいます。
Apache Sparkガイド
- Apache Sparkの機械学習パイプライン: 入門
- Apache SparkによるSGD線形回帰の例
- Spark決定木分類器
- ScalaとSparkを使用したロジスティック回帰
- Apache SparkでのJupyterノートブックの使用方法
- PythonとSparkの機械学習を使用して分類を行う
- PythonでSpark UDF(ユーザー定義関数)を書く方法
- Python Spark ML K-Meansの例
- サイバーセキュリティに機械学習を適用する方法
- Apache Spark: ストリームの操作
- Apache SparkによるK-meansクラスタリング
- HiveとのSparkの使用
- 予防保守のための予測を行うためにApache Sparkを使用する方法
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。