




ポイント: このチュートリアルでは、Pandasデータフレームのグループ化、連結、およびマージの方法を説明し、SQL操作との類似点を描写します。重要な関数には、連結のためのと、特定の列によるデータフレームの結合のためのmerge()があります。
- 連結は外部結合に似ています。
- 内部結合は2つのデータフレームの交差を特定します。
このチュートリアルでは、Pandasデータフレームをグループ化、連結、マージする方法を示します。(Pandasが初めてですか? 私たちのPandas入門または辞書からPandasデータフレームを作成するから始めてください。)
これらの操作は、行および列のデータベースにおけるSQL操作に非常に似ています。結局のところ、Pandasは行と列のメモリ内データ構造です。SQLプログラマーであれば、これらすべてにすでに慣れているでしょう。ここでの唯一の複雑さは、行に加えて列でも結合できることです。
Pandasは、連結関数concat()、すなわちconcatを使用します。しかし、これを内部結合(交差)および外部結合(和集合)として考えると、理解しやすくなります。以下でそのように説明します。
連結(外部結合)
連結を外部結合のように考えてください。結果は同じです。
データフレームAとBがあり、それぞれのインデックスと列に共通の要素があるとしましょう。
外部結合
マージ
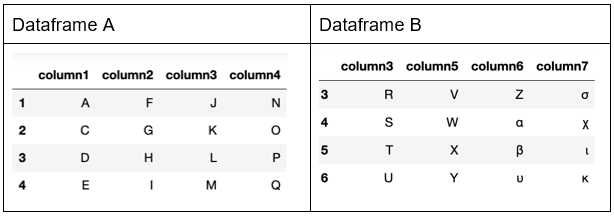
さて、連結します。これは追加ではありません。(それに対してappend()関数があります。)このconcat()操作は、aおよびbの両方のスーパセットを作成しますが、共通の行を結合します。これも内部結合ではないため、共通のインデックスがない行もすべてリストされます。
欠損値NaNに注意してください。これは、Dataframe Aのインデックスに対してDataframe Bに対応するデータフレームインデックスがない場合です。
たとえば、インデックス3は両方のデータフレームに存在します。したがって、Pandasは最初のデータフレームから4列、2番目のデータフレームから4列を新しく構築されたデータフレームにコピーします。同様に、インデックス5はDataframe Bには存在しますが、Dataframe Aには存在しないため、列1、2、3は欠損(NaN)としてマークされます。
結果は:
追加
    a = pd.DataFrame({'column1': ['A', 'C', 'D', 'E'],

'column2': ['F', 'G', 'H', 'I'],

'column3': ['J', 'K', 'L', 'M'],

'column4': ['N', 'O', 'P', 'Q']},

index=[1,2,3,4])

b = pd.DataFrame({'column3': ['R', 'S', 'T', 'U'],

'column5': ['V', 'W', 'X', 'Y'],

'column6': ['Z', 'α', 'β', 'υ'],

'column7': ['σ', 'χ', 'ι', 'κ']},

index=[3,4,5,6])

result = pd.concat([a, b], axis=1)
結果は:
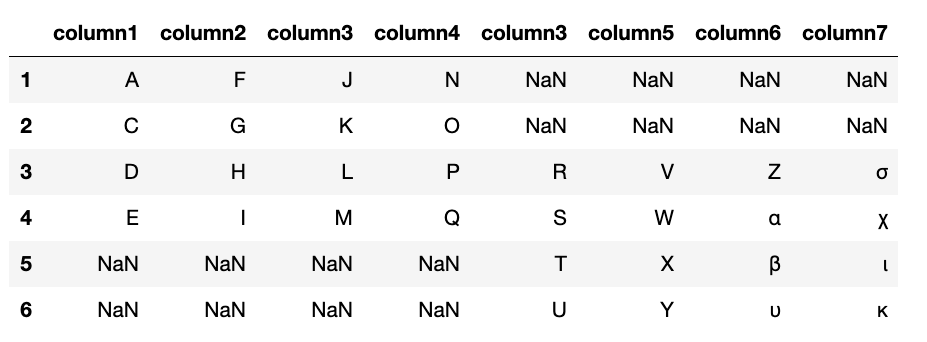
ここでは外部結合を行います。これは、集合の観点から言えば、2つの集合の和集合を意味します。したがって、すべての行が追加されます。ここでの外部結合は、共通のインデックスの交差を作成しません。しかし、すべての行に存在しない列がある場合、その値はNaNとして表示されます。それは、すべての列がすべての行に存在するわけではないためです。したがって、すべての列をリストする必要がありますが、一部の列は空としてマークする必要があります。
result = pd.concat([a, b], join='outer')

0軸(行)に沿った内部結合
インデックスまたは列による内部結合を行うことができます。内部結合は、2つの集合の交差を見つけます。
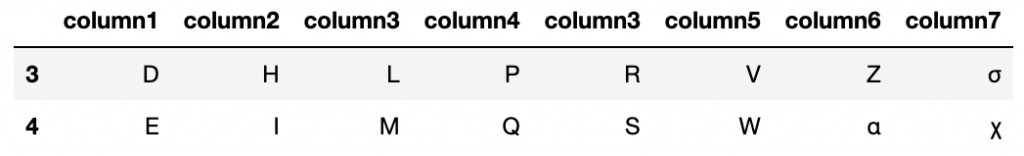
0軸(行)に沿って結合しましょう。インデックス3と4のみが両方のデータフレームに存在します。したがって、内部結合はこれら2つの行のすべての列を取得します。
result = pd.concat([a, b], axis=1,join='inner')
1軸(列)に沿った内部結合
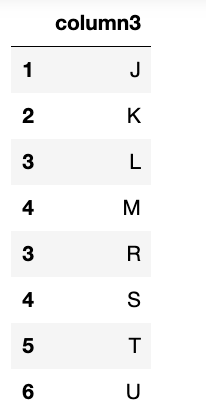
Column3は両方のデータフレームに共通する唯一の列です。したがって、Aのすべての行をBの行と連結し、共通の列のみを選択します。すなわち、列軸に沿った内部結合です。
result = pd.concat([a, b], axis=0,join='inner')
マージは内部結合のようなもので、どの列を基準にマージするかを指定します。
ここで、最初の列名(すなわち、辞書のキー値)を共通名「key」にします。そして、それに基づいてマージします。
    a = pd.DataFrame({'key': ['A', 'C', 'D', 'E'],

'column2': ['F', 'G', 'H', 'I'],

'column3': ['J', 'K', 'L', 'M'],

'column4': ['N', 'O', 'P', 'Q']},

index=[1,2,3,4])

b = pd.DataFrame({'key': ['C', 'D', 'T', 'U'],

'column5': ['V', 'W', 'X', 'Y'],

'column6': ['Z', 'α', 'β', 'υ'],

'column7': ['σ', 'χ', 'ι', 'κ']},

index=[3,4,5,6])

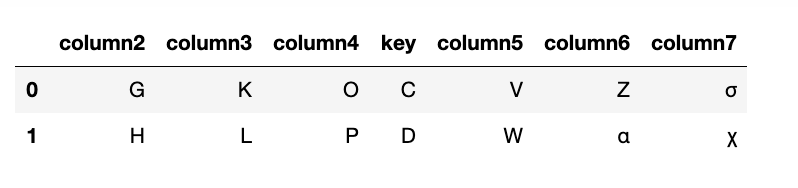
result=pd.merge(a, b, on='key')
結果のデータフレームは、配列key=[]から共通のキー値を持つものです。CとDのみが両方のデータフレームに共通していることがわかります。
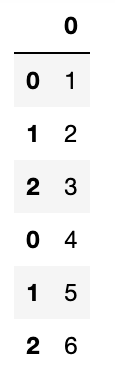
これは単に1つのデータフレームを別のものに追加します。ここにSeriesがあります。これは、1つの列だけのデータフレームです。結果は、Dataframe Aのすべての行がDataframe Bに追加されてDataframe Cが作成されます。
    import pandas as pd

a=pd.DataFrame([1,2,3])

b=pd.DataFrame([4,5,6])

c=a.append(b)

c
グループ化
ここにSQLプログラマーにとって馴染み深い別の操作があります。
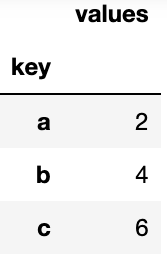
グループ化操作は単一のデータフレームに対して行います。キーという名前の列から値をグループ化し、それらを合計します。
    a=pd.DataFrame({"key": ["a", "b", "c","a", "b", "c"] ,

"values": [1,2,3,1,2,3]})

b=a.groupby("key").sum()

b
関連する読書
Pandasガイド
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。