




ポイント: このガイドでは、TensorFlowを使用してラスベガスストリップデータセットからホテル顧客の評価を予測するためのニューラルネットワークを作成する方法を示します。必要な前提条件、データ準備、モデルのトレーニングステップを含みます。
- 前提条件にはTensorFlowのインストールとPythonの知識が含まれます。
- チュートリアルでは、トレーニングと予測プロセスのためにTripAdvisorデータを使用します。
人々がTensorFlowを使用してニューラルネットワークを学ぼうとする際、通常は手書きデータベースから始めます。これは、数千人から得た手書きサンプルに基づいて、誰が描いた数字を予測するモデルを構築します。特徴とラベルの用語で言うと、グレースケール画像のピクセルの組み合わせ(白、黒、灰色)が描かれた数字(0、1、..、8、9)を決定します。
ここでは他のデータを使用します。
前提条件
このTensorFlowニューラルネットワークチュートリアルを読む前に、まずこれらの3つのブログ投稿を学習する必要があります:
ニューラルネットワークとは? ニューラルネットワークの紹介 パートI
次にTensorFlowをインストールする必要があります。Ubuntuでの最も簡単な方法は、これらの手順に従って、virtualenvを使用することです。
次に、Python Pandas、numpy、scikit-learn、およびSciPyパッケージをインストールします。
Trip Advisorのラスベガスストリップホテルデータセット
TensorFlowの使用を学んでいるプログラマーは、通常、アイリスデータベースから始めます。それは、どのタイプのアイリスの花が描かれているかを示すピクセルの組み合わせです。しかし、ここではアイリスデータセットを使用する代わりに何か独自のことをしたいと思います。したがって、ラスベガスストリップデータセットを使用します。このデータセットは、論文「Moro, S., Rita, P., & Coelho, J. (2017). データマイニングを通じてホテルへの顧客のフィードバックを解析:ラスベガスストリップの事例。観光管理の視点、23、41-52。」に引用されています。これを使用してニューラルネットワークを構築できるか見てみましょう。
著者は、Rプログラミング言語を使用してモデルを作成し、サポートベクターマトリックス(SVM)をアルゴリズムとして使用しました。これは非線形回帰問題の一種です。これは、通常のLR問題を解決するためのアプローチを使用し、最も低い点で平均二乗誤差(MSE)を減少させる線を見つけて予測モデルを構築します。しかし、SVMは複数の非線形入力を扱うことで複雑さを増し、n次元空間内の平面を見つけ、XY直交平面上の線ではありません。
ここでは、同じデータを使用しますが、SVMの代わりにニューラルネットワークを使用します。これを3つのブログ投稿で紹介します:
- データを数値形式に変換します。
- ニューラルネットワークを訓練します。
- 予測を行います。
このチュートリアルのデータとコードはこちらにあります。
データ
データをGoogle Sheets形式で見るにはこちらをクリックしてください。データは一画面に収まらないほど広がっているため、以下に2つの画面印刷で示します。上記の論文を読むと、データの詳細を得ることができますが、基本的にはラスベガスストリップに沿った21軒のホテルのTripAdvisorデータです。目標は、個々の顧客がどのホテルにどのようなスコアを付ける可能性があるかを予測するモデルを構築することです。スコアは1から5で、入力は以下のスプレッドシートに記載された20の変数です。
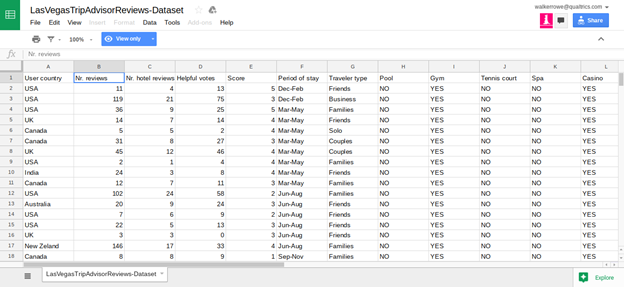
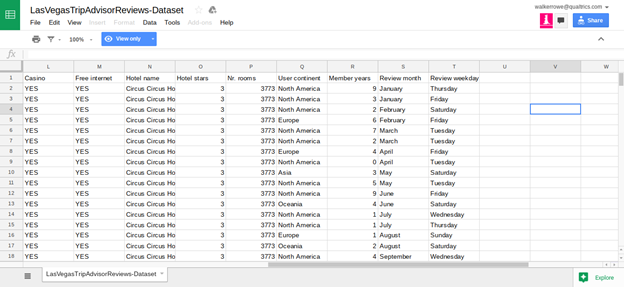
著者は、ホテルにカジノ、プール、星の数、無料のインターネットがあるかどうかといった特定のデータは、Tripadvisorでのホテル客からのスコアにあまり影響を与えないと述べています。むしろ、スコアを最も重く予測する要因は、レビュアーが書いたレビューの数と、そのレビュアーがレビューを書いている期間です。スコアに影響を与える他の要因は、週の曜日と年の月です。
値を整数に変換
以下のコードをこのiPythonノートブックからダウンロードできます。
まず、マシンラーニングは数値の配列を入力として使用するため、すべての値を整数に変換する必要があります。3つのアプローチを採用します:
- 数値がすでに整数の場合、そのままにします。
- 数値がYESまたはNOの場合は、1または0に変更します。
- 要素が文字列の場合、各文字を整数に変換するためにordinal string functionを使用します。その後、これらの整数を合計します。
    import pandas as pd

def yesNo(x):
    if x=="YES":
        return 1
    else:
        return 0

def toOrd(str):
    x=0
    for l in str:
        x += ord(l)
    return int(x)

cols = ['User country', 'Nr. reviews','Nr. hotel reviews','Helpful votes',
        'Score','Period of stay','Traveler type','Pool','Gym','Tennis court',
        'Spa','Casino','Free internet','Hotel name','Hotel stars','Nr. rooms',
        'User continent','Member years','Review month','Review weekday']

df = pd.read_csv('/home/walker/TripAdvisor.csv',sep=',',header=0)
ここでは、すべての文字列を整数に変換します。後でどの整数がどの文字列の値に等しいかを見ることができるように、文字列-整数の組み合わせをいくつかのデータ構造に保存する必要があります。
私たちのデータが今どのように見えるかはこちらです。
私たちはすでに解決したい問題を説明しました。それは、他の人がどのようにしてTripAdvisorでラスベガスのホテルを評価するかを予測することです。次に、これを行うためのニューラルネットワークを構築するコードを書きます。次に、私たちのTensorFlowニューラルネットワークを使用して予測を行うことができます。
ニューラルネットワークを構築するための前提条件
- Python 3
- Python 3にTensorflowをインストールする必要があります。つまり、pip3 install –upgrade tensorflowです。
- このデータをダウンロードします。これは、Trip Advisorデータを整数に変換したもので、このプログラムを使用しています。これには、これらの列見出しがあります。これらのアイテムはすべて特徴です。スコアはラベルです。
    User country,Nr. reviews,Nr. hotel reviews,Helpful votes,Score,Period of stay,
Traveler type,Pool,Gym,Tennis court,Spa,Casino,Free internet,Hotel name,
Hotel stars,Nr. rooms,User continent,Member years,Review month,Review weekday
以下にコードを示します。これはこちらからコピーできます。各セクションを説明します。
以下に、各列名を配列に入れます。列は21あります。FIELD_DEFAULTSは21の整数として与えられます。これらは整数であることをTensorFlowに示すために整数を使用します。
    import tensorflow as tf

feature_names = ['Usercountry', 'Nrreviews','Nrhotelreviews','Helpfulvotes','Score','Periodofstay',
                 'Travelertype','Pool','Gym','Tenniscourt','Spa','Casino','Freeinternet','Hotelname',
                 'Hotelstars','Nrrooms','Usercontinent','Memberyears','Reviewmonth','Reviewweekday']
FIELD_DEFAULTS = [[0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0], [0]]
次に、.csvファイルとしてデータを読み取ります。Tensorflowは、1行ずつ読み取るためのtf.decode_csv()メソッドを提供します。データセットの各行に対してparse_lineを呼び出すために、データセットのmap()メソッドを使用します。これにより、通常のPythonデータセットではなく、テンソルで動作するように設計されたTensorFlowデータセットが作成されます。Tensorが何であるかわからない場合は、これを確認できます。
このルーチンは、特徴を辞書として、ラベルをラベルとして返します。Score(parsed_line[4])を特徴から削除することに注意してください。スコアは特徴ではなく、ラベルです。 dict(zip())メソッドは、辞書にキー名を入れます。
    def parse_line(line):
   parsed_line = tf.decode_csv(line, FIELD_DEFAULTS)
   label = parsed_line[4]
   del parsed_line[4]
   features = parsed_line
   d = dict(zip(feature_names, features))
   print ("dictionary", d, " label = ", label)
   return d, label
Tensorflowは、.csvファイルをTensorFLowデータセットに読み込むためのtf.data.TextLineDataset()メソッドを提供します。tf.estimator.DNNClassifier.train()では、何らかの関数を呼び出す必要があります。この場合はcsv_input_fn()です。これにより、特徴とラベルのデータセットが返されます。ニューラルネットワークを作成する際に使用されるため、dataset.shuffle()を使用します。
    def csv_input_fn(csv_path, batch_size):
   dataset = tf.data.TextLineDataset(csv_path)
   dataset = dataset.map(parse_line)
   dataset = dataset.shuffle(1000).repeat().batch(batch_size)
   return dataset
各列のためにテンソルを作成する必要があります。カテゴリカルデータ(例:0と1)と数値(例:レビュー数)の両方があります。
カテゴリカルデータは、たとえば、47のカテゴリがあることを意味します。別の言葉で言うと、同じデータは47の異なる国からの人々から得られます。ユニークな要素をカウントするために、たとえばdf['User continent'].groupby(df['User continent']).count()を使用できます。
tf.feature_column.indicator_column(tf.feature_column.categorical_column_with_identity("Usercountry",47))
数値データは、たとえば、次のようにエンコードします:
Nrreviews = tf.feature_column.numeric_column("Nrreviews")
ここにその全セクションがあります。最後の行で、feature_columnsにテンソルの配列を作成しています。
    Usercountry = tf.feature_column.indicator_column(tf.feature_column.categorical_
column_with_identity("Usercountry",47))

Nrreviews = tf.feature_column.numeric_column("Nrreviews")

Nrhotelreviews = tf.feature_column.numeric_column("Nrhotelreviews")

Helpfulvotes = tf.feature_column.numeric_column("Helpfulvotes")

Periodofstay = tf.feature_column.numeric_column("Periodofstay")

Travelertype =
tf.feature_column.indicator_column(tf.feature_column.categorical_column_with_identity("Travelertype",5))

Pool =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Pool",2))

Gym =
tf.feature_column.indicator_column(tf.feature
_column.categorical_column_with_identity("Gym",2))

Tenniscourt =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Tenniscourt",2))

Spa =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Spa",2))

Casino =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Casino",2))

Freeinternet =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Freeinternet",2))

Hotelname =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Hotelname",24))

Hotelstars =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Hotelstars",5))

Nrrooms =
tf.feature_column.numeric_column("Nrrooms")

Usercontinent =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Usercontinent",6))

Memberyears = tf.feature_column.numeric_column("Memberyears")

Reviewmonth =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Reviewmonth",12))

Reviewweekday =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Reviewweekday",7))
feature_columns = [Usercountry, Nrreviews,Nrhotelreviews,Helpfulvotes,Periodofstay,
Travelertype,Pool,Gym,Tenniscourt,Spa,Casino,Freeinternet,Hotelname,Hotelstars,Nrrooms,
Usercontinent,Memberyears,Reviewweekday]
ここにtf.estimator.DNNClassifierがあります。DNNは深層ニューラルネットワークを意味します。特徴列とモデルを保存するディレクトリを指定します。また、ホテルのスコアは1から5までの範囲であるため、クラスは5であることを指定します。隠れユニットには[10, 10]を選択します。これは、ニューラルネットワークの最初の層に10ノードがあり、次の層にも10ノードがあることを意味します。この数値をどのように選ぶかについては、たとえばこのStackOverflowの記事を読むことで確認できます。この数値が正しいかどうかはまだわかりません。次の投稿で予測を行うときに見てみましょう。
    classifier=tf.estimator.DNNClassifier(
   feature_columns=feature_columns,
   hidden_units=[10, 10],
   n_classes=5,
   model_dir="/tmp")

batch_size = 100
最後に、train()メソッドを呼び出し、csv_input_fnへのインプレース(ラムダ)呼び出しを与え、csvファイルを読み取るパスを指定します。
    classifier.train(
steps=1000,
input_fn=lambda : csv_input_fn("/home/walker/tripAdvisorFL.csv", batch_size))
別のブログ投稿では、このモデルから予測を行う方法を示します。これは、顧客がその特性に基づいてホテルをどのように評価するかを推定することを意味します。その後、ホテルはこの顧客を幸せにするためにどれだけの努力を費やすか、あるいは全く費やさないかを決定できます。
TensorFlowとKerasによるMLガイド
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を表すものではありません。