




ポイント: 機械学習を適用することで、特にk-meansクラスタリングのような手法を通じて、ネットワークトラフィック分析が改善され、ルーターのログにおける外れ値を特定することでサイバーセキュリティを強化します。
- 機械学習はネットワークトラフィックデータのノイズをフィルタリングします。
- K-meansクラスタリングは、トラフィックデータをより効果的に分析するためにグループ化します。
この記事では、サイバーセキュリティに機械学習を適用する方法を示します。いくつかのユースケースがありますが、この記事ではルーターのログを分析することに焦点を当てます。
サイバーセキュリティに機械学習を使用する理由
ネットワークトラフィックの時系列チャートを見ているアナリストが、見ているものから結論を導き出すのはほぼ不可能です。なぜでしょうか? 人は三次元以上を視覚化できません。そして、あまりにも多くの誤警報がアナリストに見ているものの一部を無視させてしまいます—ノイズが多すぎます。
しかし、機械学習によって、たとえば、あなたのシステムからデータを盗み、そのデータを指揮制御センターに送信している犯罪ハッカーを排除することが可能になります。これは侵入検知システムが行うべきことですが、ハッカーは従来のサイバーセキュリティシステムによる検出を回避するためにあらゆる種類の技術を使用します。たとえば、彼らは盗まれたデータを小さな断片に分け、それぞれを異なるIPアドレスに送信し、ハイジャックされた自宅のコンピュータユーザーを利用して、それらの断片をハッカーの指揮制御センターに送信することができます。
[helix-video]
機械学習は、数十または数百のデータポイントを1つまたは2つのメトリックに集約するのに役立ちます。次に、それらの周りにチャートとアラートを構築できます。今、これらのアラートは大幅に価値が高くなっています。
この例では、ネットワークトラフィックを見るための1つのアプローチを示します。Verizonが提供するBroタイプのルーターからのルーターのログを使用します。各レコードを7つのクラスタの1つにグループ化し、そのクラスタ内のトラフィックを小さいエントリ数で見ていきます。それが、定義上、私たちの外れ値です。
K-meansクラスタリング
私たちはk-meanクラスタリングアルゴリズムを使用します。これは、任意の数の軸に沿ってデータを分離します。(詳細については、Apache Sparkによるk-meansクラスタリングおよびPython Spark ML K-Meansの例を参照してください。)
データサイエンティストは、データポイント間にハイパープレーンを通すと述べるでしょう。これを可視化できないので、3D空間を考え、その中にデータポイントのセットに沿って紙の一片を通すことを考えてください。1つのグループのポイントはその紙の一方の側に、もう一方のグループのポイントは他方の側にあります。
これは教師なしモデルです。なぜなら、ラベルはなく、ただ特徴だけがあるからです。したがって、モデルをトレーニングする必要はありません。予測するものがないからです。代わりに、私たちは観察しています。
コードの説明
コードはこちらで入手でき、データはここです。これは、以前はBroと呼ばれていたネットワーク分析ツールZeekからのデータです。
シンシナティ大学は、このデータの列についてこの説明を提供しています。
- ts—時刻; タイムスタンプ
- uid—文字列; 接続のユニークID
- orig_h—アドレス; 発信エンドポイントのIPアドレス(別名ORIG)
- orig_p—ポート; 発信エンドポイントのTCP/UDPポートまたはICMPコード
- resp_h—アドレス; 応答エンドポイントのIPアドレス(別名RESP)
- resp_p—ポート; 応答エンドポイントのTCP/UDPポートまたはICMPコード
- proto—transport_proto接続のトランスポート層プロトコル
- service—文字列; 動的に検出されたアプリケーションプロトコル(あれば)
- duration—間隔; 最後のパケットが見られた時刻から最初のパケットが見られた時刻まで
- orig_bytes—カウント; 発信者のペイロードバイト、TCPの場合はシーケンス番号から
- resp_bytes—カウント; 応答者のペイロードバイト、TCPの場合はシーケンス番号から
- conn_state—文字列; 接続状態(conn.log:conn_stateテーブルを参照)
- local_orig—bool; 接続がローカルから発信された場合はT; 遠隔地からの場合はF。Site::local_netsが空の場合は常にunset
- missed_bytes—カウント; コンテンツギャップ内の欠落バイト数
- history—文字列; 接続状態の履歴(conn.log:historyテーブルを参照)
- orig_pkts—カウント; ORIGパケットの数
- orig_ip_bytes—カウント; ORIG IPバイトの数(IP total_lengthヘッダーフィールドを介して)
- resp_pkts—カウント; RESPパケットの数
- resp_ip_bytes—カウント; RESP IPバイトの数(IP total_lengthヘッダーフィールドを介して)
- tunnel_parents—セット; トンネル接続があれば、カプセル化された親の接続UID
- orig_cc—文字列; ORIG GeoIP国コード
- resp_cc—文字列; RESP GeoIP国コード
まず、csvファイルをSparkデータフレームにロードします。
    from pyspark.sql.types import StructType, StructField, FloatType, BooleanType
from pyspark.sql.types import DoubleType, IntegerType, StringType
import pyspark
from pyspark.ml.linalg import Vectors
from pyspark.ml.feature import VectorAssembler
from pyspark.sql.functions import lit
from pyspark.sql.functions import udf, concat

from pyspark import SQLContext

conf = pyspark.SparkConf()

sc = pyspark.SparkContext.getOrCreate(conf=conf)
sqlcontext = SQLContext(sc)

schema = StructType([
    StructField("ts", StringType(),True),
    StructField("uid", StringType(),True),
    StructField("origh", StringType(),True),
    StructField("origp", StringType(),True),
    StructField("resph", StringType(),True),
    StructField("respp", StringType(),True),
    StructField("proto", StringType(),True),
    StructField("service" , StringType(),True),
    StructField("duration", FloatType(),True),
    StructField("origbytes", StringType(),True),
    StructField("respbytes", StringType(),True),
    StructField("connstate", StringType(),True),
    StructField("localorig", StringType(),True),
    StructField("missedbytes", StringType(),True),
    StructField("history", StringType(),True),
    StructField("origpkts", IntegerType(),True),
    StructField("origipbytes", IntegerType(),True),
    StructField("resppkts", IntegerType(),True),
    StructField("respipbytes", IntegerType(),True),
    StructField("tunnelparents", StringType(),True)
              ])


df = sqlcontext.read.csv(path="/home/ubuntu/Documents/forensics/bigger.log", sep="\t", schema=schema)
df2 = df.fillna(0)
次に、UDF(ユーザー定義関数)を登録します。 この関数に送信されるすべてのフィールドを整数に変換するために使用します。なぜなら、機械学習は主に数字でのみ機能するからです。
    colsInt = udf(lambda z: toInt(z), IntegerType())

sqlcontext.udf.register("colsInt", colsInt)

def toInt(s):
    if not s:
        return 0
    if isinstance(s, str) == True:
        st = [str(ord(i)) for i in s]
        return(int(''.join(st)))
    else:
        return s
次に、モデルに供給するカラムとして選択した追加のカラムを作成します。これらのうちの各カラムに対して、colsInt() UDFを呼び出して、それらを数字に変換します。
あなたは、追跡したい仮説に応じてカラムの選択を変えることができます。たとえば、以下ではポートとトラフィック、さらにプロトコルを見ています。
- ログの中に追加したり削除したりできる他のメトリックがあるかもしれません。
- ハッカーが真の宛先を隠す能力があるため、モデルには宛先IPアドレスを含めない方が良いでしょう。
- UDPプロトコルは、sftp(TCPを使用する)を使用して送信するプロトコルであるため、削除するかもしれません。
- あるいは、深夜のイベントを特定するために、現地のタイムゾーンでの時刻を含めることができます。
すべては、あなたが集中したい活動の種類によります。
各.withColumn()ステートメントは新しいデータフレームを作成します。これは、Sparkデータフレームが不変であるためです。
    a = df2.withColumn( 'iorigp',colsInt('origp'))
c = a.withColumn( 'irespp',colsInt('respp'))
d = c.withColumn( 'iproto',colsInt('proto'))
e = d.withColumn('iorigh',colsInt('origh'))
f = e.withColumn( 'iorigbytes',colsInt( 'origbytes'))
g = f.withColumn( 'irespbytes',colsInt('respbytes'))
h = g.withColumn(  'iorigpkts',colsInt( 'origpkts'))
i = h.withColumn( 'iorigipbytes',colsInt('origipbytes'))

columns =  ['iorigp','irespp','iproto', 'iorigbytes','irespbytes','iorigpkts','iorigipbytes']
次のステップは、私たちのデータフレームにfeaturesというカラムを追加します。これは、私たちが選択したカラムのタプルです。K-meansアルゴリズムは、特徴カラムが存在することを期待します。
    vecAssembler = VectorAssembler(inputCols=columns, outputCol="features")
router = vecAssembler.transform(i)
ここでは、K-meansアルゴリズムを使用します。Apache Sparkの良い点は、その機械学習アルゴリズムが使いやすいことです。他のフレームワークのように再処理や再形成を必要とせず、Sparkデータフレームで機能するので、はるかに大きなデータセットで作業できます。(PandasはSparkデータフレームのようにスケールしません。)
    from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator


kmeans = KMeans().setK(7).setSeed(1)
model = kmeans.fit(router)

predictions = model.transform(router)

p = predictions.groupby('prediction').count()
q = p.toPandas()
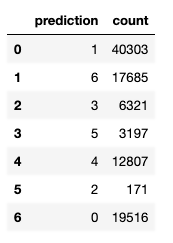
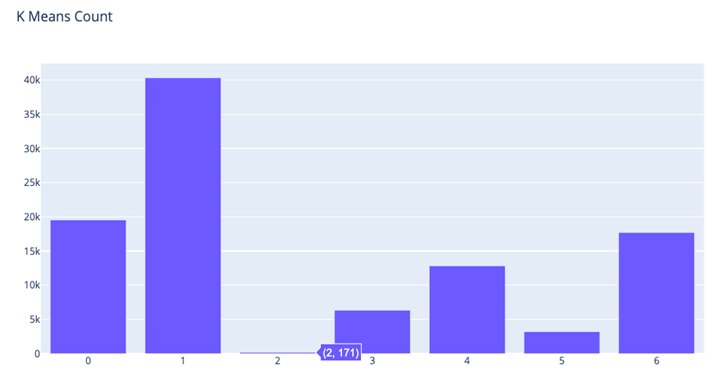
観察を7つのクラスタにグループ化しました。 クラスタ0には40,303のルーター記録がありますが、クラスタ2には171しかありません。明らかに、それらは外れ値であり、ここにサイバーセキュリティの分析に焦点を当てます。
データがどのようにクラスタリングされているかをさらに示すために、それを棒グラフとしてプロットできます。
    from plotly.offline import plot

import pandas as pd


import plotly.graph_objects as go
fig = go.Figure(
    data=[go.Bar(x=q['prediction'],y=q['count'])],
    layout_title_text="K Means Count"
)
fig.show()
PlotlyはJavaScriptを使用してポップアップを作成し、カーソルを置いた場所でより多くの情報を提供します。私たちはそれを点(prediction=2,count=121)に配置しました。
したがって、クラスタ2のこれらのレコードだけの新しいデータフレームを作成しましょう。(実際にはデータフレームの行インデックスは5なので、この2つの概念を混同しないでください。)
suspect = predictions.filter("prediction == 2")
ここでは、出力をPandasに変換します。単にJupyterノートブックがデータフレームよりもそのデータをより明確に表示するからです。データフレームでは、広い列が切り捨てられる傾向があり、読みづらくなります。
x = suspect.select('ts','uid','origh','resph').toPandas()
同じIPアドレスが何度も表示されているのが見られます。これはおそらくさらなる分析の良い場所です。それがどの機械であるか、誰と接続しているのかを確認してください。
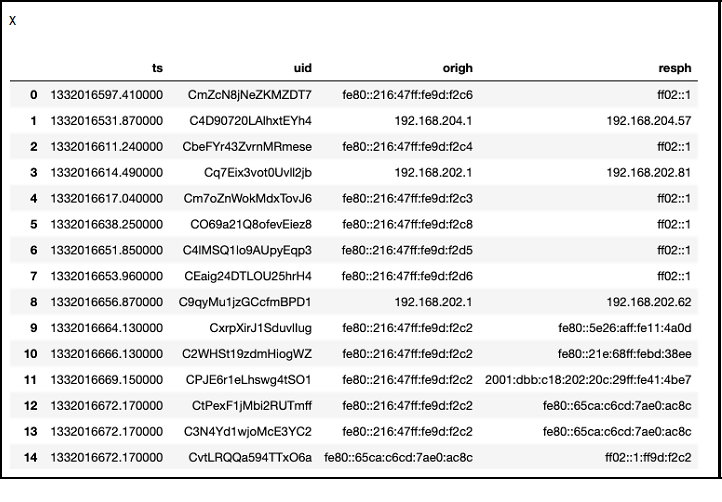
したがって、あなたのアナリストは、アプリケーション、ファイアウォールなどのログを調べて、それらのIPアドレスで何が起こっているかを見ることができます。(いくつかはIPv6形式であることに注意してください。)
Apache Spark ガイド
- Apache Sparkの機械学習パイプライン: はじめに
- Apache SparkによるSGD線形回帰の例
- Spark決定木分類器
- ScalaとSparkを用いたロジスティック回帰の使用
- Apache SparkでJupyterノートブックを使用する方法
- PythonとSpark機械学習を使用して分類を行う
- PythonでSpark UDF(ユーザー定義関数)を書く方法
- Python Spark ML K-Meansの例
- 機械学習をサイバーセキュリティに適用する方法
- Apache Spark: ストリームとの作業
- Apache SparkによるK-meansクラスタリング
- HiveとSparkを使用
- 予防保守のための予測を行うためにApache Sparkを使用する方法
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。