




ポイント: Kubernetes サービスは、アプリケーションを公開し、クラスター内の負荷分散を管理するために不可欠であり、動的なポッド IP の変化にもかかわらず安定したエンドポイントを提供します。さまざまなサービスタイプ(ClusterIP、NodePort、LoadBalancer、ExternalName)をサポートしています。
- サービスは、ポッド管理の柔軟性を持たせるために、セレクターの有無にかかわらず作成できます。
- サービス発見を簡素化し、別のメカニズムの必要性を排除します。
Kubernetes サービスは、Kubernetes クラスター内の pods の論理的コレクションです。K8s サービスは、ポッド間で 負荷分散 を行い、ポッドのセットにデプロイされたアプリケーションを公開するための抽象的な方法として定義できます。さらに、Kubernetes に組み込まれたサービスメカニズムを使用することで、別のサービス発見メカニズムを実装する必要がなくなります。
この記事では、Kubernetes サービスの構造とその利用方法について説明します。
Kubernetes サービスとは?
Kubernetes サービスは、ポッドのセットにデプロイされたアプリケーションを単一のエンドポイントを使用して簡単に公開できます。サービスは、REST オブジェクトと、次のことを定義する抽象化の両方です:
- ポッドのセット
- それらにアクセスするためのポリシー
Kubernetes デプロイメント内のポッドは定期的に作成および削除され、IP アドレスが常に変化します。これにより、デプロイされたアプリケーションが発見可能性の問題を引き起こし、アプリケーションフロントエンドがどのポッドに接続するかを特定するのが難しくなります。
ここで、Kubernetes サービスの強みが発揮されます: サービスはポッドの IP アドレスと DNS 名の変化を追跡し、エンドユーザーに対して単一の IP または DNS として公開します。
Kubernetes サービスは、セレクターを使用してポッドのセットをターゲットにします:
- ネイティブ Kubernetes アプリケーション(Kubernetes API を使用して サービス発見を行う)では、サービス内のポッドに変更があるたびにエンドポイント API が更新されます。
- 非ネイティブアプリケーションは、Kubernetes が提供する仮想 IP ベースのブリッジまたはロードバランサー実装方法を使用してバックエンドポッドにトラフィックを誘導できます。
Kubernetes サービスの属性
サービスの一般的な属性は次のとおりです:
- サービスには IP アドレス(「クラスタ IP」)が割り当てられ、サービスプロキシが使用します。
- サービスは、受信ポートを任意の targetPort にマッピングできます(デフォルトでは、targetPort はポートフィールドと同じ値に設定され、文字列として定義できます)。
- 各名前に割り当てられたポート番号は、各バックエンドポッドで異なる場合があります(たとえば、バックエンドソフトウェアの次のバージョンでポッドが公開するポート番号を変更してもクライアントが壊れることはありません)。
- サービスは、プロトコルに対して TCP(デフォルト)、UDP、および SCTP をサポートします。
- サービスは、セレクターの有無にかかわらず定義できます。
- サービスは、さまざまなポート定義をサポートします
さて、サービスがどのように機能するかを見てみましょう。
Kubernetes サービスの定義
上記のように、セレクターの有無にかかわらず Kubernetes サービスを定義できます。両方を実行してみましょう!
セレクターを持つサービスの定義
次の例では、セレクターラベル「app=webserver-nginx」でポッド内のポート 8080 をターゲットにしながら、サービス内のポート 80 を公開するシンプルなサービスを定義しました。
    apiVersion: v1
kind: Service
metadata:
  name: nginx-service
spec:
  selector:
    app: webserver-nginx
  ports:
    - protocol: TCP
      port: 80
      targetPort: 8080
Kubernetes は、自動的に IP アドレス(「クラスター IP」)を割り当て、これをサービスプロキシがトラフィックをルーティングするために使用します。セレクターのコントローラーは、定義されたラベルに一致するポッドを常に監視します。
一部のアプリケーションでは、サービスを介して複数のポートを公開する必要があります。Kubernetes は、ユーザーが単一のサービスオブジェクトで複数のポートを定義できるマルチポートサービスを使用してこれを支援します。マルチポートサービスを定義する場合、主な要件は、公開される各ポートに名前を付けて、あいまいさを排除することです。これらのポート名は:
- 英数字文字とダッシュ記号のみを含む必要があります
- 英数字文字で始まり、英数字文字で終わる必要があります。
この例では、ポート 80 と 443 の両方を公開し、ポート 8080 と 8090 をターゲットにして、セレクター「app=webserver-nginx-multiport」を使用して HTTP および HTTPS トラフィックを基盤となるポッドにルーティングします。
    apiVersion: v1
kind: Service
metadata:
  name: nginx-service
spec:
  selector:
    app: webserver-nginx-multiport
  ports:
    - name: http
      protocol: TCP
      port: 80
      targetPort: 8080
    - name: https
      protocol: TCP
      port: 443
      targetPort: 8090
セレクターなしのサービスの定義
セレクターなしのサービスを定義する際は、エンドポイントオブジェクトを追加して、サービスを対応する IP アドレスおよびポートに手動でマッピングする必要があります。理由は、Kubernetes がサービスをどのポッドに接続するかを知らないため、セレクターによるようにエンドポイントオブジェクトが自動的に作成されないからです。サービス:
    apiVersion: v1
kind: Service
metadata:
  name: nginx-service
  ports:
    - protocol: TCP
      port: 80
      targetPort: 8080
エンドポイント:
    apiVersion: v1
kind: Endpoints
metadata:
  name: nginx-service
subsets:
  - addresses:
      - ip: 192.10.0.1
    ports:
      - port: 8080
サービスとエンドポイントを定義する際の主要な考慮事項は、サービスの名前とエンドポイントが完全に一致する必要があることです。
セレクターなしのサービスのいくつかのユースケースには、次のようなものがあります:
- 別のネームスペースまたは別のクラスターの別のサービスへの接続
- 外部サービスとの通信、データ移行、テストサービス、デプロイメントなど。
Kubernetes サービスの作成
Kubernetes サービスの基本構造がわかったので、サービスを作成する方法をよりよく理解するために実践的な例を使ってみましょう。まず、4 つのレプリカを持つ小さな apache ウェブサーバーのデプロイメントを作成します。
apache-deployment.yaml
    apiVersion: apps/v1
kind: Deployment
metadata:
  name: apache-deployment
  labels:
    app: webserver
spec:
  replicas: 4
  selector:
    matchLabels:
      app: webserver
  template:
    metadata:
      labels:
        app: webserver
    spec:
      containers:
      - name: apache
        image: bitnami/apache:latest
        ports:
        - containerPort: 80
デプロイメントを作成します。
kubectl apply -f apache-deployment.yaml
結果:

デプロイメントの状態を確認します。
kubectl get deployment apache-deployment
結果:
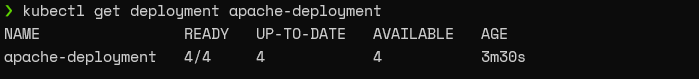
アプリケーションを apache サーバーにデプロイしました。
次に、デプロイされたアプリケーションにアクセスするためのサービスを作成します。これを行うには、次の 2 つの方法があります:
- サービスの YAML マニフェストを作成する
- "kubectl expose" コマンドを使用する
expose コマンドを使用すると、ユーザーはコマンドラインから直接サービスを作成できます。
次のコマンドを使用して、"apache-deployment" を ClusterIP サービスタイプで公開できます。サービスをポート 8080 にポイントします。"bitnami/apache" イメージはポート 8080 を HTTP ポートとして使用します。
kubectl expose deployment apache-deployment --name=apache-http-service --type=ClusterIP --port=8080 --target-port=8080
結果:
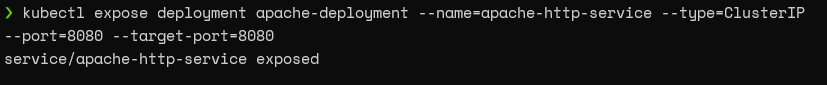
サービスが正しく作成されているかどうかを確認します。
kubectl get service apache-http-service
結果:
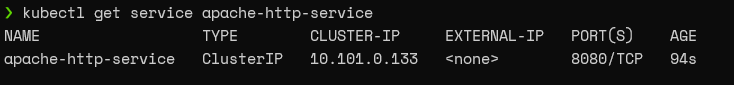
作成したサービスにトラフィックを転送する必要があるので、"kubectl port-forward" コマンドを使用できます。ホストポート 8090 からサービスポート 8080 にトラフィックを誘導します。
kubectl port-forward service/apache-http-service 8090:8080
結果:
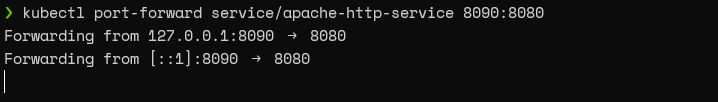
"http://localhost:8090" に移動すると、以下のような Nginx ランディングページにリダイレクトされます。
上記のシナリオのために YAML ファイルを使用してサービスを定義することもできます。セレクターを "app=webserver." と設定しました。
    apiVersion: v1
kind: Service
metadata:
  name: apache-http-service
spec:
  selector:
    app: webserver
  ports:
    - protocol: TCP
      port: 8080
      targetPort: 8080
Kubernetes サービスの種類
Kubernetes サービスには 4 つの種類があります:
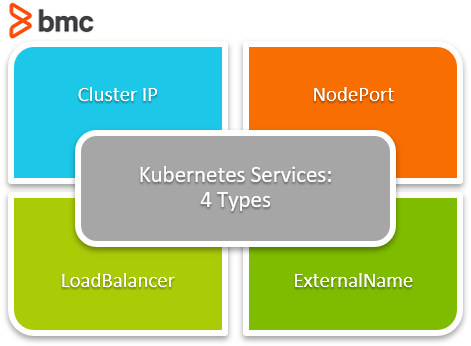
これは、クラスターの内部 IP でサービスを公開するデフォルトのタイプです。これらのサービスはクラスター内でのみアクセス可能です。したがって、ユーザーはポートフォワーディングまたはプロキシを実装して、ClusterIP を広範囲なトラフィックのインバウンドに公開する必要があります。
NodePort サービスは、各ノードの IP で静的ポートでサービスを公開します。ClusterIP サービスは自動的に作成され、トラフィックをノードポートサービスにルーティングします。ユーザーは外部から : でサービスと通信できます。
これは、クラスターを広範囲なインターネットに公開するための推奨ソリューションです。LoadBalancer タイプのサービスは、ロードバランサーを作成し(ロードバランサーの種類はクラウドプロバイダーによって異なります)、サービスを外部に公開します。
また、ClusterIP と NodePort サービスが自動的に作成され、トラフィックが適切にルーティングされます。
このタイプのサービスは、externalName フィールドの内容にマッピングされます(例:app.test.com)。これを行うことで、CNAME レコードに対する値を返します。
サービスプロキシの実装
kube-proxy プロセスは、ExternalName タイプを除くすべてのサービスタイプの仮想 IP の形式を実装します。サービスのプロキシを使用すると、ユーザーは DNS 解決の問題を軽減できます。
たとえば、DNS レコードが期限切れの場合、以前の DNS ルックアップが期限切れのレコードでまだキャッシュされている場合があり、解決の問題につながることがあります。同様に、DNS レコードが適切に伝播されない場合も、解決の問題が発生する可能性があります。
kube-proxy がトラフィックをルーティングするために使用できる 3 つの方法は次のとおりです:
- プロキシモード: userspace
- プロキシモード: iptables
- プロキシモード: ipvs
プロキシモード: userspace
このモードでは、kube-proxy は Kubernetes マスターを監視し、サービスまたはエンドポイントが作成または削除されるたびに、ローカルノード上のランダムポートを割り当てたり解放したりします。
この「プロキシポート」へのすべての接続は、サービスと必要なエンドポイントにプロキシされます。
プロキシモード: iptables
このモードも、サービスとエンドポイントについて Kubernetes マスターを監視します。ただし、サービスの ClusterIp とポートにトラフィックをキャプチャするために iptable ルールをインストールし、トラフィックをリダイレクトします。
さらに、デフォルトの動作はランダムなバックエンド(ポッド)を選択することですが、エンドポイントオブジェクトに対する iptable ルールもインストールして、バックエンドポッドを選択します。
このモードでは、kube-proxy はサービスとエンドポイントを監視し、適切な ipvs(IP バーチャルサーバー)ルールを作成するために Netlink インターフェースを呼び出します。このモードは、すべてのサービスとエンドポイントを最新の状態に保つために定期的に ipvs ルールを同期します。
Kubernetes サービスの発見
サービスを発見するために、DNS または環境変数の 2 つの方法を使用できます。
これはサービス発見のための推奨方法です。ここでは、Kubernetes API を監視し、新しいサービスごとに DNS レコードを作成する Kubernetes クラスターに DNS サーバーが追加されます。DNS が有効になると、クラスター全体のすべてのポッドはサービスの名前解決を行うことができます。
環境変数
この方法では、kubelet がアクティブなサービスごとにポッドに環境変数を追加します。この方法を使用する場合、希望するサービスは、そのサービスを使用するポッドを作成する前に作成する必要があります。そうしないと、ポッドは希望するサービスに必要な環境変数を取得できません。
負荷分散と単一サービス IP が必要ない場合、ユーザーはクラスタ IP フィールド(.spec.clusterIP)に対して明示的に「none」を指定してヘッドレスサービスを作成できます。これらのヘッドレスサービスには関連付けられた Cluster IP がなく、プラットフォームによって負荷分散やプロキシが提供されません。Kube-proxy もこれらのサービスを無視します。
これらのサービスの DNS 構成は、サービスで定義されたセレクターに依存します。
- セレクターを持つヘッドレスサービス。エンドポイントコントローラーは、API 内にエンドポイントレコードを作成し、DNS レコードを変更して必要なポッドを指す A レコードを返します。
- セレクターを持たないヘッドレスサービス。エンドポイントコントローラーは、セレクターが構成されていない場合、エンドポイントレコードを作成しません。
K8s サービスのまとめ
これで、Kubernetes サービスの基本をすべてカバーしました。サービス、さまざまなタイプ、サービス発見、サービスプロキシの使用について知識を得ました。サービスは、ポッド、外部サービス、ユーザー間の通信を促進する手段を提供する Kubernetes の不可欠な部分です。
Kubernetes ガイド
- Kubernetes (K8s) とは?Kubernetes 基礎チュートリアル
- クラスターの効率性を向上させるための Kubernetes ベスト プラクティス
- ベスト プラクティス: Kubernetes 用にアプリケーションを設計する方法
- Kubernetes Pods: 入門
- Kubernetes ReplicaSets: 簡単な紹介
- Kubernetes デプロイメントの完全解説
- Kubernetes DaemonSets の使用と管理
- Kubernetes サービスの仕組み
- Kubernetes Port、TargetPort、および NodePort の使用
- Kubernetes における ConfigMap の作成と使用
- Kubernetes Secrets の紹介
- Kubernetes ネットワーキングの基本
- Kubernetes Ingress の解説
- Kubernetes Helm Charts の紹介
- Kubernetes オペレーター パターンとは?
- Kubernetes における StatefulSet としての PostgreSQL のデプロイ
- Kubernetes カスタムリソース定義 (CRDs) の解説
- クラウドネイティブアプリケーションのための 3 つの Kubernetes パターン
- Kubernetes コンピュートリソースの解説
- DevOps パイプラインのための Kubernetes セキュリティ
- Kubernetes と Spinnaker を使用した継続的デリバリー
- Kubernetes マルチクラスター: 利用方法とその理由
- Kubernetes モニタリング: 包括的ガイド
- Kubernetes vs Docker: 簡単な比較
- Kubernetes vs Docker Swarm: コンテナオーケストレーションツールの比較
- Kubernetes vs OpenShift: 何が違うのか?
- Kubernetes 認定: 取得方法とその理由
これらの投稿は私自身のものであり、必ずしも BMC の位置、戦略、または意見を表すものではありません。