




ポイント: Apache Sparkの機械学習パイプラインは、データ変換、モデル適合、評価のプロセスを統一されたワークフロー内で合理化し、コードの明瞭性と再現性を向上させます。このチュートリアルは、ステージ化されたSpark MLコードを効率的な機械学習実行のために構造化されたパイプライン形式に変換する方法をガイドします。
- パイプラインオブジェクトは、重要な操作を統合します:変換、適合、評価。
- 自動実行順序を通じてコードのメンテナンス性を向上させます。
Apache Sparkの機械学習パイプラインは、org.apache.spark.ml.Pipelineを使用して、変換、評価、適合操作を単一の実行可能なワークフローにチェーンするオブジェクトです。データフレーム上の各データ変換ステップを個別に実行する代わりに、すべてのステージを一度定義し、パイプラインオブジェクトにそれらを順に実行させることで、MLコードをよりクリーンで再現可能にし、プロダクションに移行する際の容易さを高めます。
このチュートリアルでは、既存のステージ化されたSpark MLコードをパイプライン形式に変換することで、Apache Sparkの機械学習パイプラインの概念を示します。既存のコードは二つのブログ記事で説明されています:第一部と第二部。これらを最初に読むことをお勧めします。ここで使用するデータを生成するために必要です。(あるいは、maintenance_data.csvをテストデータとトレーニングデータの両方として使用して先に進むこともできます。)
Sparkパイプラインオブジェクトはorg.apache.spark.ml.{Pipeline, PipelineModel}です。
Apache Sparkの機械学習パイプラインとは何ですか?
一般的に、機械学習パイプラインは、コードを書くプロセス、プロダクションへのリリース、データの抽出、トレーニングモデルの作成、およびアルゴリズムの調整のエンドツーエンドプロセスを説明します。Apache Sparkでは、パイプラインは、変換、評価、適合ステップを一つのオブジェクトにまとめたものです:org.apache.spark.ml.Pipeline。これらのステップを合わせてワークフローと呼びます。
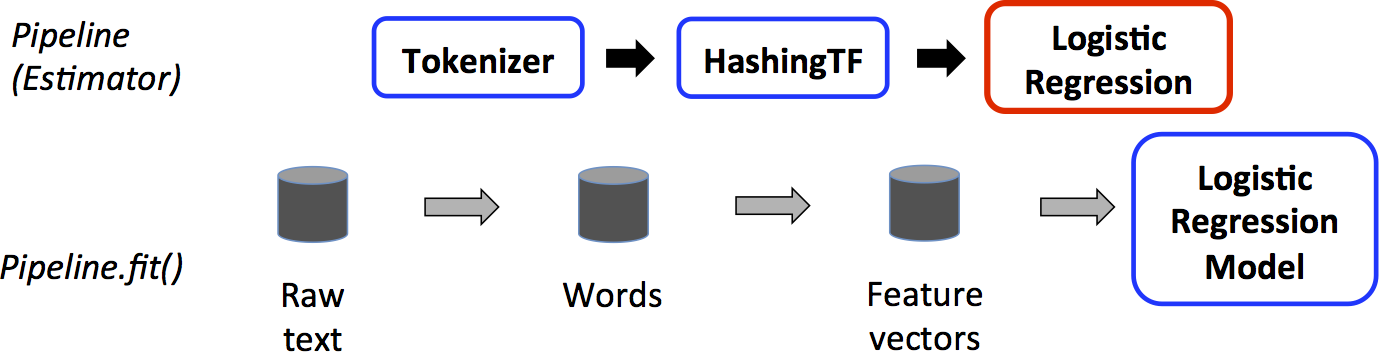
Apache Sparkのドキュメントは、これをグラフィックで示しています:生のデータフレームから始まり、任意の変換ステップ—MLアルゴリズム自体と共に—がパイプラインオブジェクトに供給され、指定された順序で実行されます。
Sparkパイプラインオブジェクトはどのように機能しますか?
Apache Sparkパイプラインオブジェクトは、データフレームに対して3種類の操作を実行します:
- 変換—データフレームを修正し、特徴量またはラベル列を追加します
- 適合—データフレームをMLアルゴリズムに供給し、結果を計算してトレーニング済みモデルを作成します
- 評価—モデルのパフォーマンスを評価します
上のグラフィックでは、データフレームはHadoopまたは他のソースからデータを読み取ることで作成されます。次に、transform()およびfit()操作が実行され、特徴量およびラベル列を追加します—ロジスティック回帰MLアルゴリズムに必要な形式です。これらの個別のステップは、パイプラインオブジェクトに供給されます。
Sparkのドキュメントの例は、これを明確に示しています:
これらの3つのステップはすべて、パイプラインオブジェクトによって処理されます。val pipeline = new Pipeline().setStages(Array(tokenizer, hashingTF, lr)).
    val tokenizer = new Tokenizer()
  .setInputCol("text")
  .setOutputCol("words")
val hashingTF = new HashingTF()
  .setNumFeatures(1000)
  .setInputCol(tokenizer.getOutputCol)
  .setOutputCol("features")
val lr = new LogisticRegression()
  .setMaxIter(10)
  .setRegParam(0.001)
val pipeline = new Pipeline()
  .setStages(Array(tokenizer, hashingTF, lr))
ステージ化されたSpark MLコードをパイプラインに変換するにはどうすればよいですか?
作業例を示すために、以下のコードは、上記のブログ記事からプログラムを再記述します—元々は二つの別々のプログラム(モデルの作成/予測の実行)を、一つの統合プログラムに変換します。
注意: 以下のコード例はSpark 1.x/2.x向けに記述されています。com.databricks.spark.csvやSQLContextなどのAPIは後のSparkバージョンで置き換えられていますが、パイプラインの概念と構造はバージョンを超えて有効です。
まず、必要なインポートを含めます:
    import org.apache.spark.sql.SQLContext
import org.apache.spark.SparkConf
import org.apache.spark.SparkContext
import com.databricks.spark.csv
import org.apache.spark.ml.classification.LogisticRegression
import org.apache.spark.mllib.linalg.{Vector, Vectors}
import org.apache.spark.ml.evaluation.BinaryClassificationEvaluator
import org.apache.spark.ml.feature.{VectorAssembler, StringIndexer}
import org.apache.spark.ml.classification.LogisticRegressionModel
import org.apache.spark.ml.{Pipeline, PipelineModel}
import org.apache.spark.sql.Row
古いアプローチ:ステージ化された操作
    val df2 = assembler.transform(df)

val df3 = labelIndexer.fit(df2).transform(df2)

val model = new LogisticRegression().fit(df3)
新しいアプローチ:Pipeline.setStages()
transform()操作を個別に実行する代わりに、VectorAssembler()、StringIndexer()、LogisticRegression()を新しいPipeline().setStages(Array(assembler, labelIndexer, lr))に供給します。その後、元のデータフレームでpipeline.fit()を実行します。パイプラインは、.setStages()で定義された順序で各変換を実行します。
    var file = "hdfs://localhost:9000/maintenance/maintenance_data.csv";

val sqlContext = new SQLContext(sc)

val df = sqlContext.read.format("com.databricks.spark.csv").option("header", "true").option("inferSchema", "true").option("delimiter",";").load(file)

val featureCols =  Array("lifetime", "pressureInd", "moistureInd", "temperatureInd")

val assembler = new VectorAssembler().setInputCols(featureCols).setOutputCol("features")

val labelIndexer = new StringIndexer().setInputCol("broken").setOutputCol("label")

val lr = new LogisticRegression()

val pipeline = new Pipeline().setStages(Array(assembler, labelIndexer, lr))

val model = pipeline.fit(df)
適合したSpark PipelineModelで予測を行うにはどうすればよいですか?
Apache Sparkパイプラインが適合したら、予測を行うのは簡単です。適合したPipelineModelはすでにすべての変換を保存しています。テストデータを読み込み(ブログ記事の第一部で作成された)、それに対してtransform()を実行します。次に、ロジスティック回帰の予測値が0(すなわち1に等しい)を超える機械をフィルタリングして、保守が必要な機械を特定します。
    var predictFile = "hdfs://localhost:9000/maintenance/2018.05.30.09.46.55.csv"

val testdf = sqlContext.read.format("com.databricks.spark.csv").option("header", "true").option("inferSchema", "true").option("delimiter",";").load(file)

val predictions =  model.transform(testdf)

predictions.select("team", "provider", "prediction").filter($"prediction" > 0).collect().foreach { case Row(team: String,provider: String, prediction: Double) =>
    println(s"($team, $provider, $prediction) --> team=$team, provider=$provider, prediction=$prediction")
  }
結果は次のようになります:
    (TeamA, Provider4, 1.0) --> team=TeamA, provider=Provider4, prediction=1.0
(TeamC, Provider2, 1.0) --> team=TeamC, provider=Provider2, prediction=1.0
(TeamC, Provider4, 1.0) --> team=TeamC, provider=Provider4, prediction=1.0
(TeamB, Provider1, 1.0) --> team=TeamB, provider=Provider1, prediction=1.0
(TeamC, Provider2, 1.0) --> team=TeamC, provider=Provider2, prediction=1.0
(TeamB, Provider2, 1.0) --> team=TeamB, provider=Provider2, prediction=1.0
(TeamA, Provider2, 1.0) --> team=TeamA, provider=Provider2, prediction=1.0
Apache Sparkの機械学習パイプラインに関するよくある質問
Spark MLパイプラインと手動でステージ化された操作を実行することの違いは何ですか?
ステージ型アプローチは、各変換と適合ステップの間でデータフレームを手動で渡すことを要求し、順序のエラーのリスクを高め、コードのメンテナンスを困難にします。Apache Spark MLパイプラインは、すべてのステップ—特徴エンジニアリングやモデル適合を含む—を単一のパイプラインオブジェクトにカプセル化し、自動的に.setStages()で定義された順序で実行します。
Apache Sparkパイプラインにおけるtransform()とfit()の違いは何ですか?
Apache Spark MLパイプラインでは、transform()は特徴ベクトルやラベルのような列を追加することでデータフレームを修正します。fit()はデータフレームをMLアルゴリズムに供給し、トレーニング済みモデルを返します。両方はパイプラインオブジェクトのステージとして定義でき、pipeline.fit()を介して一緒に実行されます。
Apache SparkにおけるPipeline.setStages()は何をしますか?
Pipeline.setStages()は、パイプラインが実行する変換器と推定器の順序を定義します。パイプラインオブジェクトは、指定された順序で配列内の各ステージを実行し、各ステージの出力データフレームを次の入力として渡します。
適合したSpark PipelineModelを新しいデータに対する予測に再利用できますか?
はい。pipeline.fit()を介してトレーニングされた後、結果のPipelineModelはすべての適合した変換器とトレーニング済み推定器を保存します。新しいデータフレームに対してmodel.transform(testdf)を呼び出すと、すべてのパイプラインステージが自動的に適用されます—変換ステップを再定義または再実行する必要はありません。
Spark PipelineオブジェクトをScalaで使用するために必要なインポートは何ですか?
最低限、Apache Spark Pipelineオブジェクトを使用するには、import org.apache.spark.ml.{Pipeline, PipelineModel}が必要です。使用する変換器と推定器によっては、org.apache.spark.mlパッケージからVectorAssembler、StringIndexer、LogisticRegressionなどの追加のインポートも必要になります。
この投稿に表現されている見解や意見は著者のものであり、BMCの公式な立場を必ずしも反映するものではありません。
Apache Sparkガイド
- Apache Sparkの機械学習パイプライン:入門
- Apache SparkによるSGD線形回帰の例
- Spark決定木分類器
- ScalaとSparkを使用したロジスティック回帰
- Apache SparkとJupyterノートブックの使用方法
- PythonとSpark機械学習を使用した分類
- PythonでのSpark UDF(ユーザー定義関数)の作成方法
- Python Spark ML K-Meansの例
- サイバーセキュリティに機械学習を適用する方法
- Apache Spark:ストリームの操作
- Apache SparkによるK-meansクラスタリング
- HiveとのSparkの使用
- 予防保守のためにApache Sparkを使用して予測を行う方法
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。