




ポイント: ElasticSearch マシンラーニングは、教師なし学習による時系列分析のアドオンであり、事前のモデル学習なしで異常を検出します。固定の統計しきい値を使用するのではなく、データパターンを特定することにより、アプリケーションパフォーマンスモニタリングやサイバーセキュリティを改善します。
- ElasticSearch ML はスタンドアロンまたは Elastic Cloud 経由でインストールできます。
- 時系列データの効果的な異常検出のために、さまざまなアルゴリズムを使用しています。
ここでは ElasticSearch マシンラーニングについて説明します。ML は ElasticSearch のアドオンで、スタンドアロンのインストールとして購入するか、月額の Elastic Cloud サブスクリプションの一部として支払うことができます。
ElasticSearch マシンラーニング
マシンラーニングという用語は広い定義を持っています。さまざまなモデルの具体的な話を避けるための一般的な用語です。
具体的には、ElasticSearch ML が行うことは 教師なし学習の時系列分析です。つまり、異なる技術を使用して回帰分析を行う際のように、モデルを訓練することなく、データセットから結論を引き出します(すなわち、教師あり学習)。これには ニューラルネットワーク、最小二乗法、または サポートベクターマシンが含まれます。
これがどう役立つか
教師なし学習の時系列分析の価値を見るためには、サイバーセキュリティやアプリケーションパフォーマンスモニタリングへの典型的なアプローチを考えてみてください。つまり、データが通常(ガウス)分布に従うと仮定し、外れ値をフラグ付けする際に重要と見なされるしきい値を選択することです。
これは馴染みのあるベルカーブアプローチです。たとえ誰かがそのように考えなくても、彼らが行っていることはそれです。この曲線は、高校数学の学生が知っておくべき用語で説明されます: 平均、分散、および 標準偏差。しかし、それはマシンラーニングではありません。
推測よりも優れていない
通常、アプリケーションモニタリングやサイバーセキュリティを行う人は、曲線のどちらかの端にあるイベントにフラグを付けます。そこでは、そのようなイベントの確率が低くなります。これは通常、σ(シグマ)のいくつか倍数として言及されます。ここで、シグマは標準偏差の倍数であり、そこにイベントが存在する確率は非常に低いです。
このアプローチを軽蔑して推測と呼ぶこともできます。
しきい値アプローチには欠陥があり、偽陽性を引き起こします。それは、アナリストが本当に統計的に重要でないイベントを追跡するために時間を費やすことにつながります。
たとえば、サイバーセキュリティの場合、誰かが特定の IP アドレスにデータを以前よりも多く送信しているからといって、そのイベントが範囲外であるとは限りません。彼らはイベントの周期的な性質を考慮し、過去のイベントを考慮して現在のイベントを見なければなりません。これは毎月のことであり、正常である可能性があります。巧妙なアルゴリズムは、たとえば最小二乗法を適用し、エラー(観測されたものと期待されるものの違い)を最小化し、データの移動するサブセットに対して行うことができます。これが ElasticSearch のやり方です。そして、彼らは最小二乗法だけでなく、いくつかのアルゴリズムを適用します。
ElasticSearch を使用してマシンラーニングを行う方法
ここではツールの使用方法を示します。別のブログ記事では、その背後にある論理とアルゴリズムを説明します。しかし、ツールはすべてを理解する必要がないようにすることを目的としています。それでも、あなたはそれが何を言っているのかを信頼できるようにするために、理解しておくべきです。
我々は、ElasticSearch による このビデオを参照し、単一のステップにスローして理解を簡単にするつもりです。
データには、Kaggle からダウンロードできるニューヨーク市のタクシーキャブデータセットを使用します。ここから入手できます。このデータは、数年間にわたる NYC タクシーのピックアップおよびドロップオフの時間と場所を提供します。我々は、交通量が減少または増加する異常な状況、たとえばタクシーのストライキや雪嵐がいつ起こるかを見たいと思います。
このデータを Kibana ML 画面に読み込む際にはいくつかの制限があります。ES ML の機能です。1 回に最大 100 MB のデータしか読み込めません。このタクシーキャブデータはそれよりもはるかに大きいです。テストとトレインのデータセットが含まれています。教師なし学習でモデルを訓練していないので、そのうちの 1 つを選ぶことにします。そして、100 MB に制限する必要があるので、200 MB のデータファイルをこのように分割し、90MB のデータセットの 1 つを選びます。
    unzip train.zip
split -b 90000000 train.csv
また、ElasticSearch はこのようにデータを読み込むとフリーズしがちですが、大きなクラスターがある場合を除きます。それでもデータは読み込まれます。したがって、読み込みが完了したように見える場合、つまり、画面が更新されなくなったら、ただクリックしてインデックス管理に移動し、新しいインデックスに記録されている数を確認します。各 90MB のデータに対して約 100,000 であるはずです。
データを機械学習画面にアップロード
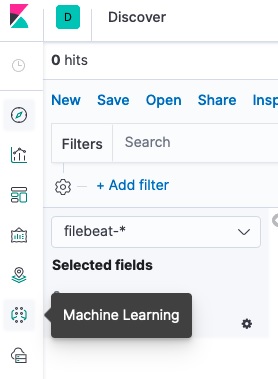
Kibana を開き、機械学習アイコンをクリックします。このアイコンは、トライアル版や有料ライセンスがなくても表示されます。しかし、欠けているのは 異常検出、ジョブ作成、およびその他の画面です。したがって、ElasticSearch はトライアルにサインアップする手順を案内してくれます。
異常検出
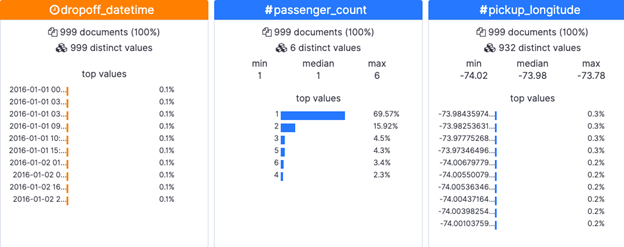
データビジュライザーからファイルをインポートを選択し、train.csv から分割したファイルの 1 つをインポートします。別の方法でデータを読み込んだ場合は、インデックスパターンを選択オプションを使用できます。
ElasticSearch は最初の 1,000 行を表示し、次にいくつかの迅速なレコードカウントを行います。


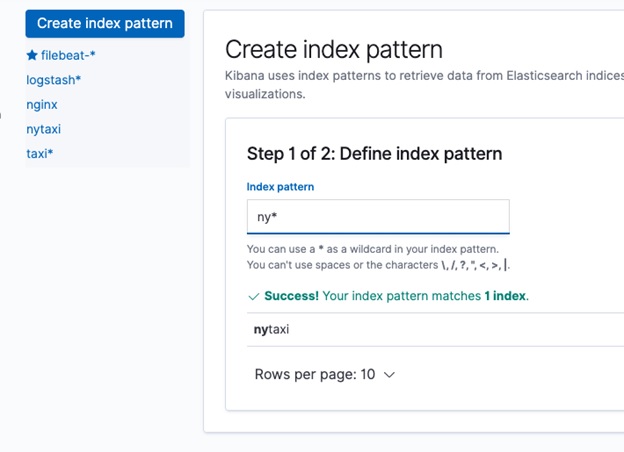
次に、画面の下部でインポートをクリックします。インデックスパターン名の名前を付けます。例えばny*のように。
さて、興味深い部分に移ります。我々は ElasticSearch にこの時系列データを見てほしいのです。シングル メトリックオプションを選択してください。

次に、ジョブを作成する必要があります。ElasticSearch はバックグラウンドで集約クエリを実行します。我々はそれに対して乗客数の合計を時間ごとに指示します。(ドロップダウンボックスが機能しない場合は、フィールド名をコピーして貼り付けてください。)
この集約を使用して、通常の範囲を超えた乗客数の減少や急増を観察します。
ボタンをクリックしてデータの完全な範囲を使用を選択します。そうすれば、手動で指定した日付範囲ではなく、利用可能なすべてのデータが選択されます。バケットオプションを 10m に変更できます。
次に、画面はこのように埋まります:
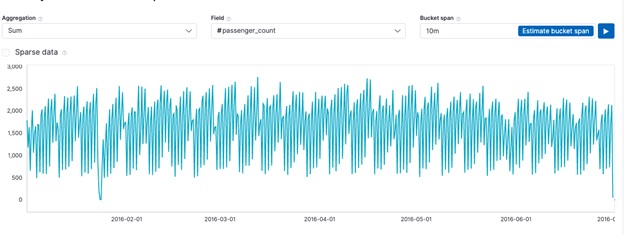
次に、ジョブを作成をクリックします。アルゴリズムの実行が開始され、論理が完了するたびに縦の色付き線で画面が更新されます。
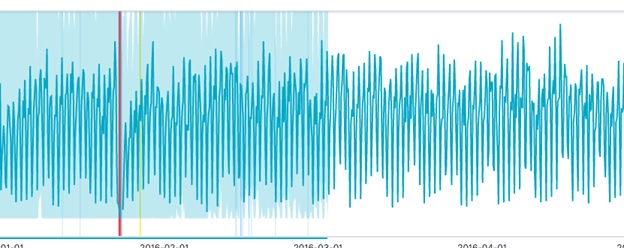
異常検出結果を表示
完了したら結果を表示をクリックします。
我々は別の投稿で、正確にどの計算が行われたかを説明します。結局、あなたはその結論の出し方について何らかの理解を持たずに ML モデルを信頼すべきではありません。
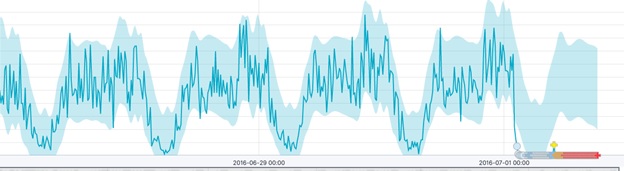
しかし、これを次のように考えることができます。タクシーの乗車は、週の曜日や週末、ラッシュアワーの有無によって上下します。販売データを扱っている場合、これはトレンドまたは季節性と呼ばれるでしょう。したがって、ガウス(通常)分布をそれに対して使用すると、それは間違っているでしょう。平均と分散は、高いポイントと低いポイントを含む全体のセットに対して行われます。したがって、改善されたアルゴリズムは、データのサブセットに対して複数の通常の曲線(および他の頻度分布)を作成し、この上下パターンを排除します。
これにより、以下の結果が得られます。淡い青い領域は移動する確率分布関数です。赤い領域は異常があることが見える場所で、プロットが曲線の外側に出ているポイントです。また、データが枯渇しているポイントでもあります。これは、異常スコアを計算して外れ値としてフラグ付けされています。次の投稿でこのポイントについて説明します。
ElasticSearch ガイド
- ElasticSearch 初心者向けチュートリアル: ElasticSearch 基礎
- ElasticSearch の Apache Hive の使用
- ElasticSearch の Apache Spark との使用
- Curl ElasticSearch コマンド チートシート
- Spark ElasticSearch Hadoop の更新と Upsert の例と説明
- Python を使用して Apache Spark データを ElasticSearch に書き込む方法
- ElasticSearch 検索構文とブールおよび集約検索
- ElasticSearch ネストされたクエリ: 埋め込みドキュメントの検索方法
- ElasticSearch ジョイン: Has_Child, Has_parent クエリ
- Elastic バージョン 7 クラスターの設定方法
- nginx および ElasticSearch 用に Filebeat を構成する方法
- Beats と Logstash を使用して ElasticSearch にログを送信する
- Logstash を使用して CSV ファイルを ElasticSearch に読み込む方法
- ElasticSearch の集約の説明
- ELK スタックとは何ですか?
- Logstash 101: データ処理パイプラインでの Logstash の使用
- Kibana を使用して ElasticSearch で Lucene および Kibana クエリ言語を実行する
- ElasticSearch マシンラーニング
- Elastic Enterprise Search のインストール方法
- GitHub と Elastic Enterprise Search の使用方法
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を表すものではありません。