




ポイント: Logstashを使用してCSVデータをElasticSearchに読み込むための手順が提供されています。特にネットワークトラフィックデータ向けです。このプロセスには、CSVファイルのダウンロード、Logstashの設定、およびKibanaでのインデックスパターンの作成が含まれます。
- KaggleからCSVファイルをダウンロードして解凍します。
- Logstashを構成してCSVを読み込み、ElasticSearchに出力します。
- データ分析用にKibanaでインデックスパターンを作成します。
ここでは、Logstashを使用してCSVデータをElasticSearchに読み込む方法を示します。我々が使用するファイルはネットワークトラフィックです。ヘッダーはないので、追加します。
データをダウンロードして解凍する
Kaggleからこのファイルeecs498.zipをダウンロードしてください。その後、解凍します。結果として得られるファイルはconn250K.csvで、256,670件のレコードがあります。次に、ファイルのパーミッションを変更します。パーミッションが設定されていないためです。
chmod 777 conn250K.csv
次に、このlogstashファイルcsv.configを作成し、パスとサーバー名を環境に合わせて変更します。
    input {
  file {
    path => "/home/ubuntu/Documents/esearch/conn250K.csv"
    start_position => "beginning"
  }
}

filter {
      csv {
        columns => [ "record_id", "duration", "src_bytes", "dest_bytes" ]
     }
    }

output {
  elasticsearch {
  hosts => ["parisx:9200"]
  index => "network"
  }

 }
その後、その設定ファイル名を指定してlogstashを起動します。
sudo bin/logstash -f config/csv.conf
ロードが実行中の間、いくつかのドキュメントをリストできます:
curl XGET http://parisx:9200/network/_search?pretty
結果は:
    "_index" : "network",
        "_type" : "_doc",
        "_id" : "dmx9emwB7Q7sfK_2g0Zo",
        "_score" : 1.0,
        "_source" : {
          "record_id" : "72552",
          "duration" : "0",
          "src_bytes" : "297",
          "host" : "paris",
          "message" : "72552,0,297,9317",
          "@version" : "1",
          "@timestamp" : "2019-08-10T07:45:41.642Z",
          "dest_bytes" : "9317",
          "path" : "/home/ubuntu/Documents/esearch/conn250K.csv"
        }
データのロードが完了したとき(ドキュメント数が256,670のとき)に従うためにこのクエリを実行できます。
curl XGET http://parisx:9200/_cat/indices?v
Kibanaでインデックスパターンを作成
Kibanaを開きます。
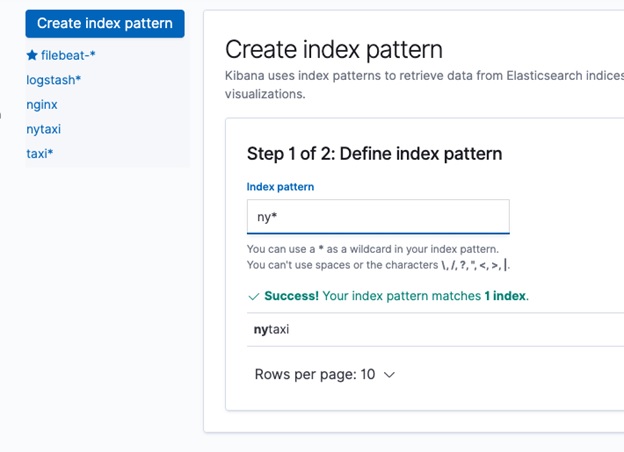
インデックスパターンを作成します。@timestampをキーとして使用しないでください。これは、データをLogstashに読み込んだときの時間を指すだけです。残念ながら、Kaggleが提供するデータには日付が含まれていません。これはネットワークデータとしては奇妙です。しかし、後の時系列分析にはrecord_idを使用できます。
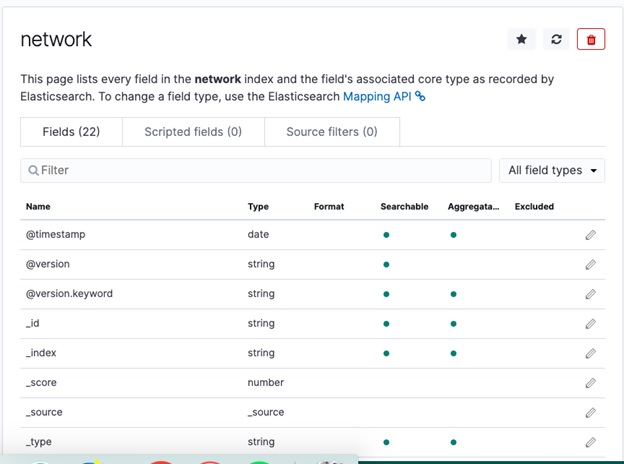
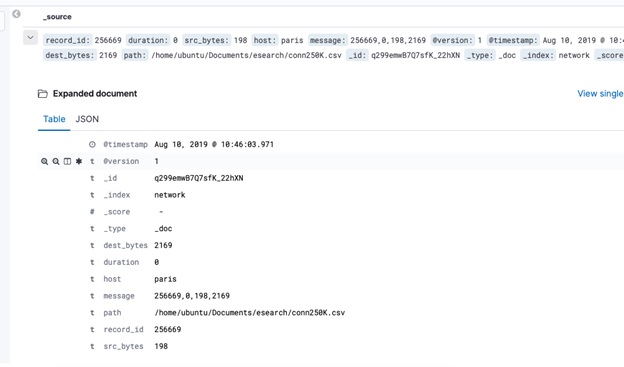
今、発見タブに移動し、いくつかのドキュメントをリストします:
次のブログ投稿では、ElasticSearch機械学習を使用してこのネットワークトラフィックの異常検出を行う方法を示します。
ElasticSearchガイド
- 初心者向けElasticSearchチュートリアル:ElasticSearchの基本
- ElasticSearchでApache Hiveを使用する
- Apache SparkでElasticSearchを使用する
- Curl ElasticSearchコマンドチートシート
- Spark ElasticSearch Hadoopの更新とUpsertの例と説明
- Pythonを使用してApache SparkデータをElasticSearchに書き込む方法
- ElasticSearch検索構文とブールおよび集約検索
- ElasticSearchネストクエリ:埋め込まれたドキュメントを検索する方法
- ElasticSearch結合:Has_Child、Has_parentクエリ
- Elasticバージョン7クラスタのセットアップ方法
- nginxおよびElasticSearch用にFilebeatを構成する方法
- BeatsとLogstashを使用してElasticSearchにログを送信する
- Logstashを使用してCSVファイルをElasticSearchに読み込む方法
- ElasticSearchの集約について説明
- ELKスタックとは何ですか?
- Logstash 101:データ処理パイプラインでのLogstashの使用
- Kibanaを使用してElasticSearchでクエリを実行する方法:LuceneおよびKibanaクエリ言語
- ElasticSearch機械学習
- Elastic Enterprise Searchをインストールする方法
- GitHubでElastic Enterprise Searchを使用する方法
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。