




ポイント: ElasticSearchはアプリケーションログやその他のJSONドキュメントを保存するのに最適なnoSQL JSONデータベースです。このガイドでは、バージョン6.xおよび7.xのクラスタ設定、Kibanaの使用、JSONとSQLデータベースの違いなどの重要なトピックをカバーします。
- ログ解析のためのLogstashとFilebeatの使用を説明します。
- ElasticSearchインデックスとネストされたドキュメントに関する詳細。
ElasticSearch(ES)は、アプリケーション、ネットワークデバイス、オペレーティングシステムなどからのログを保存するためのnoSQL JSON(Not Only SQL JavaScript Object Notation)データベースです。主な用途はログの保存ですが、あらゆる種類のJSONドキュメントの保存にも適しています。そのため、MongoDBの代わりに使用することもできます。しかし、MongoDBはJavaScriptに対するネイティブサポートを持っており、これはこちらで説明したように便利です。ESには、管理機能のために使用できるCuratorを除いて、REPL(read-eval-print loop)コマンドラインインターフェイスはありません。
このガイドに含まれるもの
このガイドでは、最も重要なElasticSearchのトピックをカバーします。
これには以下が含まれます:
- バージョン6.xおよび7.xの両方の指示を含むElasticSearchクラスタのセットアップ方法。
- Kibana(つまり、ESダッシュボード)の使用方法
- ルーセントクエリ言語
- JSONデータベースがOracleのような従来のSQLデータベースとどのように異なるか
- ESでApache PIGを使用
- ESでApache SparkおよびApache Spark機械学習を使用
- ElasticSearchインデックス
- FilebeatとLogstashを使用して、ウェブサーバー、ルーター、およびカスタムアプリケーションログを解析する方法。
- ドキュメント内にドキュメントをネストする
- システム管理
- クラスタの追加とドキュメントの再インデックス
JSONドキュメントとnoSQL
まず、JSONデータベースが何であるかを理解する必要があります。従来、データベースはレコードを列のあるテーブルに保存します。これをリレーショナルデータベース(RDBMS)と呼びます。最も広く知られている例は、1970年代にIBMが書いた論文から発明されたOracleです。この製品はLarry Ellisonを非常に裕福にし、多くの年にわたって独占を与えました。(MySQLのようなオープンソースの代替品もあります。しかし、独占企業は何をするのでしょう? 競争を買収します。OracleはMySQLを買収しました。)
RDBMSに保存されたデータは、結合操作で組み合わされ、ほとんどの場合、データは正規化されます。例えば、在庫システムを考えてみましょう。商品と在庫の移動(販売、在庫、損失など)のテーブルがあります。したがって、これらはおそらく次のように2つの別々のテーブルに保存されます:
LogStash
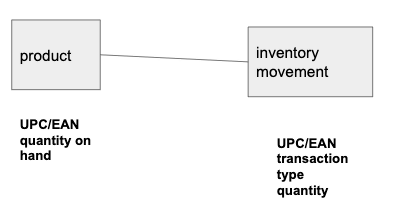
結合する共通の要素はUPC/EAN番号(ユニバーサル商品コードおよびヨーロッパの商品番号)です。これらは食料品店でスキャンされるバーコードです。商品は在庫数を保持します。在庫移動テーブルは、販売、受領、損失、その他のトランザクションを保持します。
JSONデータベースは結合操作をサポートしていませんが、その操作は強制することもできます。なぜなら、2つのテーブルを結合することは高価な操作であり、1つのテーブルのすべてのレコードをスキャンして、別のテーブルの一致するレコードを見つける必要があるからです。当然、この操作はインデックスを使用することで高速化できます。
結合の代わりに、JSONデータベースはドキュメントを互いに埋め込むことを奨励します。以下に示すように、トランザクションが製品ドキュメント内に埋め込まれています。
    {
"product": "led lightbulbs 10w 6 pack",
"EAN": 978020137962,
"transactions": [{
"trans": "sale",
"quantity": -100
},
{
"trans": "receive",
"quantity": 6100
}
],
"stock": 8000
}
ログをそのネイティブ形式でElasticSearchにダンプすることはあまり意味がありません。なぜなら、標準的な方法でクエリを実行できないからです。
例えば、ウェブサーバーを運営していて、ログをElasticSearchに直接ダンプした場合、個々のフィールドに解析されていないため、読みやすくありません。ElasticSearchが行うことは(LogstashまたはFilebeatまたはその両方を使用して)、各行をJSON形式に解析することです。例えば、nginxウェブサーバーログは以下のようになります:
    191.100.8.229 - - [14/May/2019:06:46:08 +0000] "GET / HTTP/1.1" 200 3100 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36"

103.206.128.70 - - [14/May/2019:07:20:27 +0000] "GET / HTTP/1.1" 200 3100 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/52.0.2743.116 Safari/537.36"
それをElasticSearchツールのLogstash、Grok、Filebeatを使用してJSONに変換します。
Curlインターフェース
JSONデータベースを使用する場合、そのAPI(アプリケーションプログラミングインターフェース)を知っておくことが重要です。APIを使用することで、任意のプログラミング言語で話しかけることができます。また、SDK(ソフトウェア開発キット)もあるため、特定のプログラミング言語で話しかけることができます。違いは、APIはHTTPおよびHTTPSを介して動作し、オープンでないポートを介してシステムに直接接続する必要がないことです。さらに、APIはGET、PUT、POST、およびDELETEの操作に制限されています。
例えば、インデックスを以下のようにリストできます:
    curl -XGET http://172.31.46.15:9200/_cat/indices?v


health status index                            uuid                   pri rep docs.count docs.deleted store.size pri.store.size
green  open   .kibana_task_manager             k00ncRwwTJKTA41OF7QTfg   1   1          2            0     62.4kb         31.2kb
green  open   .monitoring-kibana-6-2019.05.14  eaNOm7yXT8m62DEqv1Zkow   1   1        251            0    420.7kb        210.3kb
green  open   .kibana_2                        cTq9L_2zT0yfDhmChb0njQ   1   1        616           77    716.6kb        358.3kb
green  open   .monitoring-es-6-2019.05.15      ZgNBg16SS4qDkzuMctzchg   1   1
そして、次のようにESに書き込むことができます:
    curl -XPUT --header 'Content-Type: application/json' http://localhost:9200/samples/_doc/1 -d '{
   "school" : "Harvard"
}'
そして、それを次のようにクエリできます:
    curl -XGET --header 'Content-Type: application/json' http://localhost:9200/samples/_search -d '{
      "query" : {
        "match" : { "school": "Harvard" }
    }
}'
すべての操作をKibanaのグラフィカルインターフェースでも行うことができます。
注意:最後の例について、純粋主義者は論理的でないと言うでしょう。なぜなら、GET操作はボディ(つまり-d)パラメータを取らないからです。しかし、ElasticSearchはそう言います。RFC仕様はWeb操作についてそう言っているのです。
それでは、ElasticSearchの旅に出かけましょう。素晴らしい冒険が待っています。
ElasticSearchガイド
- ElasticSearchの初心者向けチュートリアル:ElasticSearchの基本
- ElasticSearchでApache Hiveを使用する
- ElasticSearchをApache Sparkと一緒に使用する
- Curl ElasticSearchコマンドチートシート
- Spark ElasticSearch Hadoopの更新とUpsertの例と説明
- Pythonを使用してApache SparkデータをElasticSearchに書き込む方法
- ElasticSearch検索構文とブールおよび集約検索
- ElasticSearchネストクエリ:埋め込みドキュメントを検索する方法
- ElasticSearch結合:Has_Child、Has_parentクエリ
- Elasticバージョン7クラスタのセットアップ方法
- nginxとElasticSearch用のFilebeatを構成する方法
- BeatsとLogstashを使用してログをElasticSearchに送信する
- Logstashを使用してCSVファイルをElasticSearchに読み込む方法
- ElasticSearch集約の説明
- ELKスタックとは?
- Logstash 101:データ処理パイプラインでLogstashを使用する
- Kibanaを使用してElasticSearchでLuceneとKibanaクエリ言語を実行する
- ElasticSearch機械学習
- Elastic Enterprise Searchのインストール方法
- GitHubでElastic Enterprise Searchを使用する方法
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。