




ポイント: 一般的な ElasticSearch curl コマンドは、インデックス作成、クエリ、ドキュメントの更新などのデータ管理タスクを簡素化します。これらのコマンドにより、ユーザーは ElasticSearch RESTful API と効率的に対話できます。
- ElasticSearch は動的フィールドマッピングをサポートし、柔軟なデータ探索を可能にします。
- コマンドには、インデックスの作成、削除、リスト、および URL パラメータまたは JSON を使用したドキュメントのクエリが含まれます。
ここでは、最も一般的な ElasticSearch curl コマンドのいくつかを示します。ElasticSearch は時に複雑です。そこで、ここではそれを簡単にします。
背景情報
「curl」とは何ですか?
cURL の略語、現在は curl と頻繁に書かれるのはクライアント URL の意味です。これは、データをウェブサーバー、API、および他のネットワークデバイスに転送するためのコマンドラインツールです。開発者は、これがウェブ開発プロジェクト、オートメーションおよびスクリプトタスク、および IT システム管理において必要不可欠なツールだと感じています。
ElasticSearch curl コマンドの使用
大規模なデータのインデックス作成とクエリには、curl ElasticSearch は強力な分散検索および分析エンジンです。curl を使用して ElasticSearch RESTful API に直接アクセスし、インデックスを作成したり、ドキュメントを検索したり、データを更新したり、クラスターコンピューティングを管理したりできます。ここに curl ElasticSearch コマンドのチートシートがあります:
curl を使用した ElasticSearch インデックス コマンド
ElasticSearch インデックスとは、一連のサインであり、一連のドキュメントを識別し参照するものです。これらはフィールドのコレクションであり、すべてデータを保持しています。固定スキーマとは異なり、ElasticSearch が弾力的である理由は、事前に物事をマッピングする必要がないからです。これにより、フィールドを定義することなくデータを探索できます。フィールドを動的に自動検出およびマッピングします。
ElasticSearch でインデックスを作成
以下の ElasticSearch コマンドは、デフォルト設定で index_name という名前のインデックスを作成します。
curl -X PUT 'http://localhost:9200/index_name'
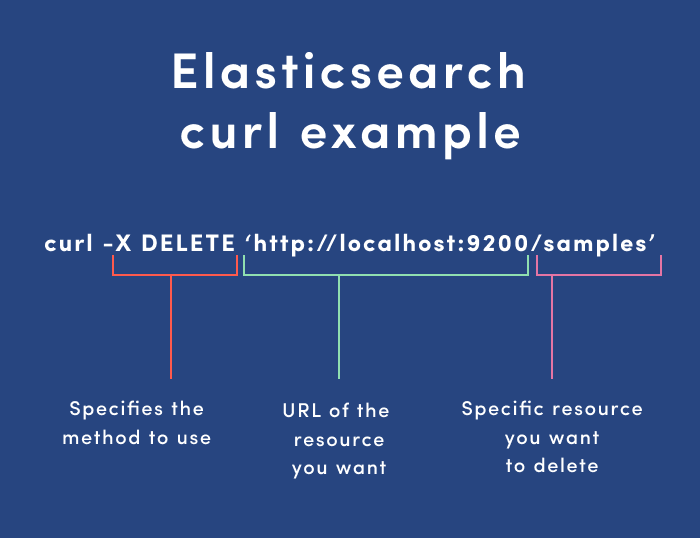
ElasticSearch インデックスを削除
ElasticSearch インデックスを削除するには(この場合、samples という名前の)、以下の curl コマンドを使用します:
curl -X DELETE 'http://localhost:9200/samples'
すべてのインデックスをリスト
ElasticSearch のすべてのインデックスをリストするには、次のようにします:
curl -X GET 'http://localhost:9200/_cat/indices?v'
インデックス内のすべてのドキュメントをリスト
以下は、インデックスからすべてのドキュメントを返すための curl ElasticSearch クエリです:
curl -X GET 'http://localhost:9200/sample/_search'
インデックス マッピングをリスト
すべての ElasticSearch フィールドはインデックスです。したがって、この ElasticSearch curl コマンドは、インデックス内のすべてのフィールドとその型をリストします。
curl -X GET http://localhost:9200/samples
ElasticSearch インデックスをバックアップ
    curl -XPOST --header 'Content-Type: application/json' http://localhost:9200/_reindex -d '{
"source": {
"index": "samples"
},
"dest": {
"index": "samples_backup"
}
}'
curl を使用して ElasticSearch をクエリする方法
curl を使用して ElasticSearch をクエリする場合、URL パラメータを使用するか、クエリを含む JSON 本文で HTTP GET リクエストを送信できます。ここでは、両方のアプローチの例を示します:
URL パラメータを使用した ElasticSearch curl クエリ
以下は、基本的なクエリや操作に便利な ElasticSearch curl コマンドの簡単な例です。ここでは、Lucene クエリ形式を使用して q=school:Harvard と書きます。
curl -X GET http://localhost:9200/samples/_search?q=school:Harvard
JSON を使用したクエリ(ElasticSearch Query DSL)
URL でパラメータを使用してクエリすることもできます。しかし、次の例のように、JSON を使用して curl を使用して ElasticSearch をクエリすることもできます。複雑なクエリを持つ場合、URL パラメータの巨大な文字列よりも、JSON の方が読みやすく、デバッグしやすいです。
    curl -XGET --header 'Content-Type: application/json' http://localhost:9200/samples/_search -d '{
"query" : {
"match" : { "school": "Harvard" }
}
}'
特定のフィールドのみを返す ElasticSearch クエリ
curl を使用して ElasticSearch をクエリする際に特定のフィールドのみを返すには、それらを _source 配列に入れます:
    GET filebeat-7.6.2-2020.05.05-000001/_search
{
"_source": ["suricata.eve.timestamp","source.geo.region_name","event.created"],
"query": {
"match" : { "source.geo.country_iso_code": "GR" }
}
}
日付による ElasticSearch クエリ
フィールドの型が「date」の場合、次のように日付数学を使用できます:
    GET filebeat-7.6.2-2020.05.05-000001/_search
{
"query": {
"range" : {
"event.created": {
"gte" : "now-7d/d"
}
}
}
}
curl を使用した ElasticSearch コマンド
データを追加
以下の curl コマンドは、ElasticSearch ドキュメントにデータを追加します:
    curl -XPUT --header 'Content-Type: application/json' http://localhost:9200/samples/_doc/1 -d '{
"school" : "Harvard"
}'
ドキュメントを更新
既存の ElasticSearch ドキュメントにフィールドを追加する方法は次のとおりです。まず、新しいドキュメントを作成し、その後更新します。
    curl -XPUT --header 'Content-Type: application/json' http://localhost:9200/samples/_doc/2 -d '
{
"school": "Clemson"
}'
curl -XPOST --header 'Content-Type: application/json' http://localhost:9200/samples/_doc/2/_update -d '{
"doc" : {
"students": 50000}
}'
他の便利な ElasticSearch curl コマンドの例
JSON 形式でデータをバルクロード
ここでは、ElasticSearch クラスターに JSON 形式でデータをバルクロードする方法を示します:
    export pwd="elastic:"
curl --user $pwd -H 'Content-Type: application/x-ndjson' -XPOST 'https://58571402f5464923883e7be42a037917.eu-central-1.aws.cloud.es.io:9243/0/_bulk?pretty' --data-binary @
ElasticSearch クラスターのヘルスを表示
以下の curl xget ElasticSearch コマンドは、JSON 形式を使用して ElasticSearch クラスターのヘルスをチェックします:
curl --user $pwd -H 'Content-Type: application/json' -XGET https://58571402f5464923883e7be42a037917.eu-central-1.aws.cloud.es.io:9243/_cluster/health?pretty
集約およびバケット集約
nginx ウェブサーバーの場合、この ElasticSearch 集約コマンドはユーザーの都市によるウェブヒット数を生成します:
    curl -XGET --user $pwd --header 'Content-Type: application/json' https://58571402f5464923883e7be42a037917.eu-central-1.aws.cloud.es.io:9243/logstash/_search?pretty -d '{
"aggs": {
"cityName": {
"terms": {
"field": "geoip.city_name.keyword",
"size": 50
}
}
}
}
'
これは、nginx ウェブサーバーログ内の都市ごとの製品応答コード数に拡張されます:
    curl -XGET --user $pwd --header 'Content-Type: application/json' https://58571402f5464923883e7be42a037917.eu-central-1.aws.cloud.es.io:9243/logstash/_search?pretty -d '{
"aggs": {
"city": {
"terms": {
"field": "geoip.city_name.keyword"
},
"aggs": {
"responses": {
"terms": {
"field": "response"
}
}
}
},
"responses": {
"terms": {
"field": "response"
}
}
}
}'
基本認証を使用した ElasticSearch
ElasticSearch でセキュリティをオンにしている場合、以下のようにすべての curl コマンドにユーザー名とパスワードを提供する必要があります:
curl -X GET 'http://localhost:9200/_cat/indices?v' -u elastic:(password)
Pretty print ElasticSearch
検索のすべてに ?pretty=true を追加して、JSON をきれいに印刷します。このように:
curl -X GET 'http://localhost:9200/(index)/_search'?pretty=true
ElasticSearch ガイド
- 初心者向け ElasticSearch チュートリアル: ElasticSearch の基本
- Apache Hive を ElasticSearch と一緒に使用する
- Apache Spark と ElasticSearch を使用する
- Curl ElasticSearch コマンド チートシート
- Spark ElasticSearch Hadoop の更新と Upsert の例と説明
- Python を使用して Apache Spark データを ElasticSearch に書き込む方法
- ElasticSearch 検索構文とブールおよび集約検索
- ElasticSearch ネストされたクエリ: 埋め込まれたドキュメントを検索する方法
- ElasticSearch ジョイン: Has_Child、Has_parent クエリ
- Elastic バージョン 7 クラスターの設定方法
- nginx と ElasticSearch 用の Filebeat を構成する方法
- Beats と Logstash を使用して ElasticSearch にログを送信する
- Logstash を使用して CSV ファイルを ElasticSearch にロードする方法
- ElasticSearch の集約の説明
- ELK スタックとは何ですか?
- Logstash 101: データ処理パイプラインでの Logstash の使用
- Kibana を使用して ElasticSearch で Lucene および Kibana クエリ言語を使用してクエリを実行する
- ElasticSearch 機械学習
- Elastic Enterprise Search をインストールする方法
- GitHub と Elastic Enterprise Search を使用する方法
これらの投稿は私自身のものであり、必ずしも BMC の立場、戦略、または意見を代表するものではありません。