




ポイント: データ正規化は、フォーマットを標準化し、エラーを排除し、レコード全体で情報を整理することによってデータの質を向上させます。このプロセスは、データ分析、効率性、意思決定を改善します。
- 正規化は重複を排除し、より良いパフォーマンスのためにデータを合理化します。
- より迅速なクエリと改善されたリードセグメンテーションを促進します。
- 利点には、ストレージスペースの増加と最適化されたデータ管理が含まれます。
大規模データの時代に生きていることは秘密ではありません。ほぼすべてのビジネス、特に大規模な企業は、成長のためにデータを収集、保存、分析します。ほとんどの日常業務では、データの管理が標準であり、以下のようなツールを使用しています:
どの会社で働いていても、データ正規化という用語に出くわしたことがあるでしょう。保存された情報を扱い、利用するためのベストプラクティスであるデータ正規化は、企業全体の成功を向上させるプロセスです。データ正規化について知っておくべきことと、データを効果的に改善するためのいくつかのヒントを以下に示します。
データ正規化とは何ですか?
データ正規化は、一般的にはクリーンデータの開発と見なされます。しかし、さらに深く掘り下げると、データ正規化の意味または目的は二重です:
- データ正規化は、すべてのレコードとフィールドで似たように見えるようデータを整理することです。
- エントリータイプの結束性を高め、クレンジング、リード生成、セグメンテーション、高品質なデータを促進します。
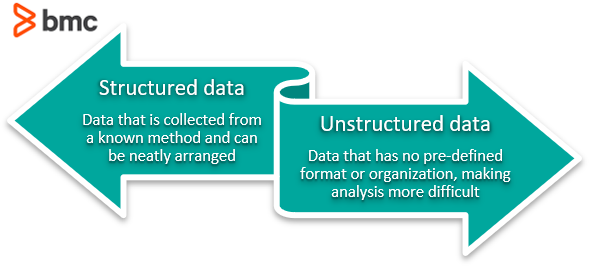
簡単に言えば、このプロセスには、非構造化データと冗長性(重複)を排除し、論理的データストレージを確保することが含まれます。データ正規化が正しく行われると、標準化された情報エントリーが得られます。たとえば、このプロセスは、URL、連絡先名、住所、電話番号、さらにはコードがどのように記録されるかに適用されます。これらの標準化された情報フィールドは、グループ化され、迅速に読み取ることができます。
誰がデータ正規化を必要とするのか?
成功し、成長したいすべてのビジネスは、定期的にデータ正規化を実施する必要があります。これは、情報分析を複雑で困難にするエラーを取り除くためにできる最も重要なことの一つです。こうしたエラーは、システム情報を変更、追加、または削除する際にしばしば発生します。データ入力エラーが取り除かれると、組織は使用可能で有益なデータで満たされた良好な機能を持つシステムが残ります。正規化により、組織はデータを最大限に活用し、より効率的なレベルでデータ収集に投資できます。データを見て企業の運営方法を改善することが、特にクロスチェックを行う際に、より簡単な作業になります。ソフトウェア・アズ・ア・サービスアプリケーションからデータを定期的に統合し、クエリを実行する人々や、ソーシャルメディア、デジタルサイトなど、さまざまなソースからデータを収集する人々にとって、データ正規化は貴重なプロセスとなり、時間、スペース、お金を節約します。
データの力を活用する準備はできましたか?BMCによるDataOpsがあなたの分析をどのように変革できるかを見てみましょう。
データ正規化の仕組み
ここで注意すべきは、特定のデータのタイプによって、正規化の見え方が異なることです。最も基本的なものとして、正規化は企業全体のすべてのデータに標準形式を作成することです:
- ミス・エミリーはMs.エミリーと書かれます
- 8023097864は802-309-7864と書かれます
- 24 Canillas RDは24 Canillas Roadと書かれます
- GoogleBizはGoogle Biz, Inc.と書かれます
- VPマーケティングはマーケティング担当副社長と書かれます
基本的なフォーマットを超えて、専門家はデータ正規化を実行するための5つの一般的なルールまたは「正規形」があることに同意しています。各ルールは、複雑さのレベルに応じてエンティティタイプを数カテゴリに分類することに焦点を当てています。正規化のガイドラインと見なされており、形式からの変化が必要な場合もあります。複雑さのために、この記事では最初の三つの最も一般的な形式がトップレベルで議論され、すべてのデータが表形式で考慮されます。
1. 第一正規形 (1NF)
データ正規化の最も基本的な形式は1NFであり、グループ内に繰り返しエントリーがないことを保証します。1NFと見なされるためには、各エントリーは各セルに対して1つの単一の値を持ち、各レコードは一意でなければなりません。たとえば、あなたは人の名前、住所、性別を記録し、クッキーを購入したかどうかを記録しています。
2. 第二正規形 (2NF)
繰り返しエントリーがないことを保証するために、2NFルールに従うためには、データはまずすべての1NF要件に適用される必要があります。それに続いて、データは1つのプライマリーキーしか持ってはいけません。データを分離して1つのプライマリーキーしか持たないようにするために、複数の行に配置できるすべてのデータのサブセットは別のテーブルに配置する必要があります。そして、新しい外部キーラベルを通じて関係を作成できます。たとえば、あなたは人の名前、住所、性別を記録し、クッキーを購入したかどうか、さらにはクッキーの種類を記録しています。クッキーの種類は、各人の名前に対応する外部キーを持つ別のテーブルに配置されます。
3. 第三正規形 (3NF)
データがこのルールに従うためには、最初にすべての2NF要件に準拠している必要があります。それに続いて、テーブル内のデータはプライマリーキーにのみ依存する必要があります。プライマリーキーが変更されると、影響を受けるすべてのデータは新しいテーブルに入れられなければなりません。たとえば、あなたは人の名前、住所、性別を記録しているが、人物の名前を変更することがあります。これを行うと、性別も変更される可能性があります。これを避けるために、3NFでは性別が外部キーと新しいテーブルに与えられます。正規形をよりよく理解し始めると、ルールが明確になり、データをテーブルやレベルに分けることが容易になります。これらのテーブルは、組織内の誰でも情報を収集し、正確なデータを収集することを保証するために簡単にします。
データ正規化の利点
上記に述べたように、データ正規化の最も重要な部分は、成長につながるより良い分析ですが、このプロセスには他にもいくつかの素晴らしい利点があります:
より多くのスペース
情報でいっぱいのデータベースでは、組織化と重複の排除が、必要なギガバイトやテラバイトのスペースを解放します。システムが不要なものでいっぱいになると、処理性能が低下します。デジタルメモリをクリーンアップした後、システムはより速く実行され、より迅速に読み込むことができ、データ分析がより効率的なペースで行われることを意味します。
質問応答の迅速化
迅速なプロセスの話をすると、正規化が簡単な作業になると、データを追加の修正なしに整理できます。これにより、会社内のさまざまなチームが、適切に保存されていない混乱したデータを翻訳しようとする時間を節約できます。
より良いセグメンテーション
ビジネスを成長させるための最良の方法の一つは、リードのセグメンテーションを確実にすることです。データ正規化により、グループはタイトル、業界などに基づいて迅速にカテゴリに分割できます。特定のリードにとって価値のあるものに基づいてリストを作成するプロセスは、もはや頭痛を引き起こすことはありません。
データ正規化は選択肢ではない
データがすべてのタイプのビジネスにとってますます価値が高まるにつれて、大量の質におけるその組織方法は見過ごすことができません。メールの配信を確保することから、ダイアルのミスを防ぎ、重複の心配なくグループの分析を改善することまで、データ正規化が正しく実行されると、全体的なビジネス機能が改善されることは明らかです。データを混乱させたままにしておくと、ウェブサイトが読み込まれなかったり、メモがVPに届かなかったりすることで重要な成長機会を逃すことを想像してみてください。それは成功や成長とは言えません。データを正規化することを選ぶことは、今日の組織にとって最も重要なことの一つです。
追加リソース
このトピックについて詳しくは、以下のリソースを探索してください:
これらの投稿は私自身の意見であり、BMCの立場、戦略、または意見を必ずしも表すものではありません。