




ポイント: 機械学習パイプラインの作成には、scikit-learnのようなフレームワークを使用してモデル化のためのデータを準備するステップが含まれます。これには、データ抽出、変換、正規化が含まれ、最適なパフォーマンスが得られます。
- 機械学習パイプラインは、データの準備とモデリングプロセスを合理化します。
- TripAdvisorデータを使用した例では、データ変換および正規化手法が示されています。
この記事では、機械学習パイプラインの作成方法を示します。この例では、scikit-learn機械学習フレームワークを使用します(私たちのscikit-learnガイドを参照するか、右側のメニューでトピックをブラウズしてください)。ただし、パイプラインの概念はほとんどの機械学習フレームワークに存在します。続けて行くために、データはこちらで利用可能で、コードはこちらです。
機械学習パイプラインとは何ですか?
一般的に、機械学習パイプラインはあなたのMLプロセスを説明またはモデル化します: コードを書く、プロダクションにリリースする、データ抽出を行う、トレーニングモデルを作成する、アルゴリズムを調整する。MLパイプラインは、チームがMLプラットフォームで作業する際に継続的なプロセスであるべきです。機械学習プログラムでは、MLモデルにデータを供給する前にデータを準備するための一連のステップが含まれます。それらのステップには以下が含まれることがあります:
- データを読み取り、Pandasデータフレームに変換する
- いくつかの列を削除または追加する
- 列に対していくつかの計算を実行する
- データを正規化する
これを1ステップずつ実行するためにPipelineオブジェクトを使用できます。例を見てみましょう。
サンプルデータを使用したMLパイプラインの例
私たちは以前、Trip Advisorからこのデータを見てきました以前。ご覧のように、データはテキストと数値の組み合わせです。機械学習モデルでは、すべての入力は数字でなければなりません(いくつかの例外を除く)。したがって、データを数値に変換するステップ1としてパイプラインを使用します。また、データを正規化するステップ2としてパイプラインを使用します。これは、各データポイントxに対して新しい値z = x - (平均) / (標準偏差)を計算することを意味します。これにより、大きな数値が小さくなり、MLモデルは入力が正規化されると最も良く機能します。
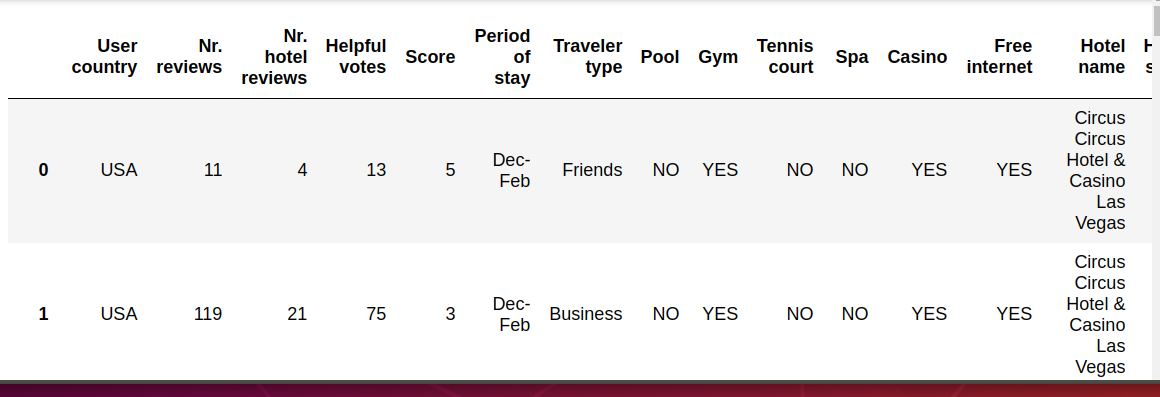
まず、Pandasを使用してデータをインポートします。次に、数値に変換する非数値列の配列を作成します。
    import pandas as pd
import numpy as np
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

df = pd.read_csv('/home/ubuntu/Documents/TripAdvisor.csv',sep=',',header=0)

cols = ['User country',  'Period of stay', 'Traveler type', 'Pool', 'Gym',
       'Tennis court', 'Spa', 'Casino', 'Free internet', 'Hotel name',
       'User continent',
       'Review month', 'Review weekday','Hotel stars']
これをPandasのfactorize()関数を使用して行います。これはテキストを受け取り、それをカテゴリカル値に変換します。つまり、それをユニークな数字に変換します。パイプラインメソッドは次のように機能します: 実行したい順序で関数をスタックします。これらはトランスフォーマーと呼ばれます。以下では、カスタムトランスフォーマーを作成し、scikit-learnに組み込まれているものを使用します。形式は次の通りです: Pipelineコンストラクターに('説明的な名前', 関数)のタプルを渡します。最初の関数のinit()メソッドに引数を渡すことができますいくつかの引数。各メソッドはfit()およびtransform()関数を実装する必要があります。ただし、最後の関数はfit()のみを実装します。
    pipeline = Pipeline([
    ('someName', someFunction(some args)),
    ('next Name', nextFuntion())
])

data = pipeline.fit_transform(dataframe)
これが呼び出す最初の関数です。これはBaseEstimatorおよびTransforMixinオブジェクトを使用しており、いくつかのコードを書くのを省きます。たとえば、私たちのためにfit_transform()メソッドを作成し、他のパラメーターを渡すために使用できるゲッターとセッターを作成します。変換する列をinit()コンストラクターに渡します。私たちがトランスフォーマーに渡すデータセットを含むXオブジェクトが作成されます: pipeline.fit_transform(dataframe).次に、cols配列内の各列をループし、factorize().を使用してそれらを変更します。最後に、機械学習モデルはNumPy配列で動作するため、強調表示されたX.valuesを使用してPandasデータフレームをNumPy配列として返します(ほとんどの場合)。
    from sklearn.base import BaseEstimator, TransformerMixin

class ToNumbers(BaseEstimator, TransformerMixin):
    def __init__(self, cols):
        self.cols = cols
    def fit(self, X, y=None):
        return self
    def transform(self, X):
        for c in cols:
            encoded, categories = X[c].factorize()
            X[c] = encoded
        return X.values
2番目のステップは、配列内の値を正規化するためにStandardScaler()を呼び出します。前のステップのデータを使用することを知っているので、引数を渡す必要はありません。
    pipeline = Pipeline([
    ('toNumbers', ToNumbers(cols)),
    ('scaler', StandardScaler())
])

data = pipeline.fit_transform(df)
ここにNumPy配列として変換されたデータがあります。
    data

array([[-0.51293975, -0.49559486, -0.50236994, ...,  0.10211954,
        -1.59325501, -1.62074647],
       [-0.51293975,  0.94590453,  0.20791152, ...,  0.02768968,
        -1.59325501, -1.1089318 ],
       [-0.51293975, -0.16191445, -0.29346363, ...,  0.0152847 ,
        -1.30357228, -0.59711712],
       ...,
       [-0.51293975,  1.41305711,  0.29147405, ...,  0.04009466,
         1.30357228, -1.62074647],
       [-0.51293975, -0.5222893 , -0.41880742, ...,  0.10211954,
         1.59325501,  0.42651223],
       [-0.51293975, -0.37546991,  0.124349  , ...,  0.05249964,
         1.59325501, -0.08530245]])
scikit Learn ガイド
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも表しているわけではありません。