




ポイント: 構造化されていない未使用の情報で構成されるダークデータは、組織の総データの90%以上を占める可能性があり、セキュリティの脆弱性やコンプライアンスの課題などのリスクを引き起こします。ダークデータの効果的な管理は、運用効率を向上させ、コストを削減し、貴重な洞察を解き放つことができます。
- ダークデータにはログファイル、地理位置データ、顧客とのやり取りが含まれます。
- ダークデータを管理することで運用効率を改善し、コストを削減できます。
ダークデータと非構造化データはほぼ同じものです。違いは、誰に向けられているかにあります。非構造化データはエンジニアに向けられた言葉であり、データの構造的特性を指します。データを精製して利用するために、エンジニアがどのように取り組むべきかを示しています。
非構造化データは未精製のデータであり、使えるようにするためにはより多くの作業が必要です。構造化データはすでに精製されたデータであり、その目的はすでに決定されています。非構造化データは構造化データの陰であり、主に非構造化データはエンジニア中心の視点から来ています。
ダークデータとは?
しかし、ダークデータはユーザー中心の視点から生じます。構造化データがデータの構造的特性を指すのに対し、ダークデータはデータの可視的特性を指します。ユーザーが見ることができるデータ、例えばInstagramの写真、プロフィール名、ハッシュタグがあり、逆にユーザーが見ることのできないデータもあります。それがダークデータです。
Instagramのようなソーシャルメディアプラットフォームでは、ダークデータは以下のようになります:
- ユーザーは何回ログインしていますか?
- ユーザーのアクティビティは特定の時間帯に集中していますか?
- 大きなネットワークを持つ人々が投稿をいいねした数は?(ユーザーの影響力を測るため。)
- 写真はどこで撮影されましたか?
- 写真を投稿したとき、ユーザーはどこにいましたか?
多くのデータを見ることで、人々は圧倒されることがあります。標準のデザインプラクティスは「シンプルに保つ」(KISS)と言い、ホワイトスペースをその中心的美徳としています。Instagramは、表示されるデータの量を減少させ、非常に特定の134,392から単に「数千」と言うことに一般化しました。
ユーザーがエンジニアである場合、ダークデータは分析されない非構造化データを指します。それは、さまざまなネットワークプロセスを通じてサーバーに保存されるデータであり、データレイクにあり、業界の時効を満たすために存在するか、データストレージが非常に安価であるために保持されています。
ダークデータの例
存在するダークデータの種類は業界特有です。背景の気象データはランニングアプリで収集され、ブラウザの履歴はショッピングアプリで収集されるかもしれません。
基本的に、インターネットを通じて送信されるものはすべて、ダークデータになる可能性があります。パッケージはA地点からB地点に送られます。これらのパッケージは暗号化されることができ、内部を見ようとする人々はパッケージそのものが何であるかを見るのが難しいですが、プロセスには他の既知のエンティティもあります。
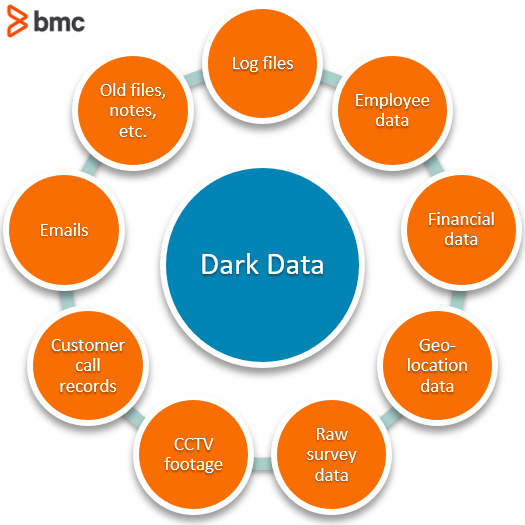
ダークデータの種類には以下が含まれます:
- ログファイル(サーバー、システム、アーキテクチャなど)
- 以前の従業員データ
- 財務諸表
- 地理位置データ
- 生の調査データ
- 監視ビデオ映像
- 顧客の通話記録
- メールのやり取り
- ノート、プレゼンテーション、または古い文書
どれだけのデータがダークデータですか?
ソフトウェアサービスを機能させるためには、いくつかのデータを収集する必要があります。ネットワークのどこかからデータを取得して別のユーザーに返すには、IPアドレスを知る必要があります。人工知能に基づくサービスは、企業がユーザーに関するデータを多く持つほど、提供できるサービスが良くなることを示しています。
IDCは、90%のデータが非構造化データであると見積もっています。A.I.はこの非構造化データをより多く活用するのを助けており、その数字を減少させるべきですが、非構造化データを収集する方が、実際に何かを行うために機械学習モデルを構築するよりもはるかに簡単であるため、その割合は大幅に増加するでしょう。数年内に、ダークデータはデータの総割合の95-97%を占める可能性があります。その傾向が続けば、合理的に、ダークデータは99%以上のすべてのデータを占める可能性があります。
この数字は良いとも悪いとも言えません。世界のすべてのデータの99.9999%がダークデータであることはほとんど意味がありません。ただ、それは多くの未使用データが存在することを意味します。もし何かあれば、その数字は、他の誰も持っていないデータを何かに変える大きな機会があるかもしれないことを示すべきです。
ダークデータのリスクは何ですか?
必要のない、使用しない大量のデータを収集し、保存することは無害ではありません。ダークデータは組織をリスクとコストにさらします。
- データセキュリティリスク:ダークデータは使用されていないため、見えないものは忘れ去られるという考え方が支配することがあります。しばしば、保存や取り扱いについて少しの考慮もされません。ダークデータには、そうした緩いデータセキュリティの結果としてリスクにさらされる敏感な情報が含まれている可能性があります。
- コンプライアンスおよび規制リスク:必要のないデータを収集すること、特に個人情報や特定可能な情報が含まれている場合、それに適切な保護を施さないことは、GDPRやCCPAのようなデータ保護規制に対する非準拠につながる可能性があります。
- 運用コスト:データを収集、保存、維持することは安くありません。ITインフラに対する影響を考慮してください。ダークデータに関しては、コストに見合った価値を得ていません。
- 機会の喪失:ダークデータには貴重な洞察が含まれている可能性があります。それを分析しない限り、トレンドを明らかにしたり、効率を高めたり、追加の収益を生む方法を見つけたりするチャンスを逃すかもしれません。
ダークデータを扱う方法
ダークデータとのプライバシー
人々はデータを使って自分のテクノロジーフットプリントを作っています。これは、人々が他人に自分が歩いていた場所を知られたくない場合には問題ですが、時には他に隠したい情報、医療関連のクエリ、Google検索、あまり好ましくないサイト、さらにはパートナーや親族から隠したい情報があることもあります。
データに関しては、セキュリティは非常に困難です。
挑戦1:匿名データ
人々は、データを保護する最初のステップはデータを匿名化することだと考えることがよくあります。これは、すべてのデータポイントが存在できるが、アカウント番号、名前、メールアドレスなどを削除することによって、個人を特定できないようにすることを意味します。この方法は、小学校の頃、誰かが提出した課題から名前を削除したときに機能しましたが、技術の世界ではデータの動作が異なります。どんなデータポイントのセットも識別子です。名前が付けられていなくても、5つのデータポイントが1人に関連付けられている場合、それは識別子です。もし誰かが朝に目を覚まし、散歩をし、くしゃみをし、あくびをし、石を蹴り、再び寝ることが知られている場合、それは世界に刻まれた単一のアイデンティティの印象です。
挑戦2:データの交差点
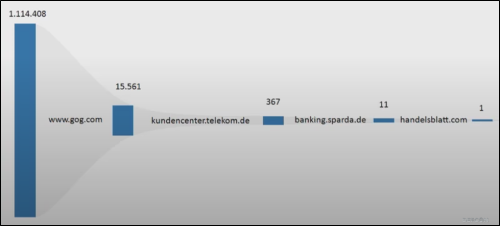
データは非常に多く存在するため、人の名前は別のデータセットの中に存在することがあります。それらのデータセットが交差するデータポイントを持ち、2つのセットが交差参照されると、匿名化されたデータにアイデンティティを付与することが可能になります。異なるデータソースのベン図を作成し、どれが重複しているかを見つけるのは簡単な選択肢であり、統計はデータを再匿名化するためのより複雑な方法を招待します。
法律のケースの話では、ある老婦人が車にひかれ、車は走り去りました。女性は車が黄色だったと言うことができました(メーカーはわからなかった)、運転手は茶色の肌の暗い髪の男でした。それは手がかりが少ないですが、事故の時間や場所の4つのデータポイントを追加すると、120,000人の町で調査者は、最初は不可能に思えた可能性を絞り込み、女性をひいた可能性のある数人の容疑者にまで至ることができました。
同様に、技術の世界から、7scientists研究チームは、Defconで似たケースを提示しました(以下のビデオクリップを参照)。彼らは匿名のブラウジングデータを購入し、それを識別することができることを示しました。
オープンソースデータプライバシー
Open Minedは、データをよりプライバシーを保護するためのオープンソース研究グループであり、ますます多くのダークデータが存在する世界で、一般の人々に利益をもたらし、データをより匿名にし、入手可能なデータが増える中でアイデンティティをプライベートに保つことを目指しています。
具体的には、機械学習モデルはデータに基づいて訓練されます。機械学習モデルは高い価値を提供でき、敏感なデータでも機能します。すべてのデータは敏感と見なされ、平等に扱われる可能性がありますが、法的条件は医療記録を最も敏感なものとして扱います。
したがって、人々の医療歴に基づいて機械学習モデルを訓練することは、過去に記録がどれほど敏感に扱われてきたかにより、非常に困難です。課題には、データが不十分であること、セキュリティ目的で異なる場所に隔離されていること、規制機関によって作成された「最良の安全慣行」に従うために多くの追加的な手続きを経る必要があります。
Open Minedの目標は二重です:人々が自分のデータの対価を得るためのフレームワークを作成し、MLモデルを通過する際にデータを本当に匿名化することです。そのために、オープンソースグループは現在、3つの主要なソフトウェアソリューションを提供しています:
- 機械学習のための暗号化サービス
- プライバシーを保護するデータサイエンスプラットフォーム
- フェデレーテッドラーニング
セキュリティはプライバシーではない
世の中には多くのダークデータがあり、今後さらに増える可能性があります。現在のセキュリティプラクティスは、すべてのダークデータポイントとともにプライバシーを保護するものではありませんが、研究グループは人々のプライバシーを改善し、彼らが作成するデータの対価を得るように促進しています。
ダークデータ管理
使用されていない、もしくは忘れ去られたダークデータに関する問題や機会を考慮すると、それを管理するための正式なプロセスを開発することは理にかなっています。これにより、負債とリスクを排除し、利益を unlock することができます。
ダークデータを管理することで、運用の改善、顧客体験とロイヤルティの強化、革新や新たな収益源の創出が可能になります。
ダークデータを管理することで、コストとリスクを削減することもできます。その影響をITインフラに対して減らし、収集と保存にかかるコストを削減できます。また、データプライバシーやデータセキュリティのコンプライアンス問題を軽減することもできます。
ダークデータ管理のベストプラクティスには以下が含まれます:
- 未使用データのボリュームを評価するデータ監査を開始する。
- 価値のあるデータ、敏感なデータ、陳腐なデータ、不要なデータを特定するデータ分類システムを実装する。
- 削除と保持の決定を行うためのシステムを作成し、保持されたデータの適切な取り扱いを特定する。
- 暗号化、アクセス制御、およびデータライフサイクルポリシーなどのセキュリティプロトコルが、通常使用されるデータだけでなく、ダークデータにも適用されることを保証する。
エンタープライズ向けのBMC AMIデータ管理ソリューションについてもっと学ぶ
ダークアナリティクス
ダークデータを処理および使用して、そこに隠された洞察を明らかにし、それを用いて意思決定を行うことがダークデータアナリティクスの核心です。未構造化で未分析、忘れ去られたデータの膨大な量は、組織にとっての金鉱となるかもしれません。
典型的なダークデータには、ログファイル、センサーデータ、アーカイブされたメール、ソーシャルメディアのやり取り、顧客の通話記録、サービス記録、顧客フィードバックなどが含まれます。製品の問題を指摘する顧客の不満が繰り返されるパターンや、顧客のニーズやサイバーセキュリティの侵害を示すトレンドを発見することができるかもしれません。
ダークデータの分析は、競争優位性、成長機会、そして以前は見えなかったリスクを重大な問題になる前に軽減することにつながります。
ダークアナリティクスの利点
ダークアナリティクスを使用することは、組織にとって隠れたスーパーパワーです。リスクを軽減し、コストを削減し、競争優位性を得て、良いダークデータアナリティクスによって迅速に賢い意思決定を行うことができます。以下は、利益を得るための主な方法です:
- プロセスと運用における障害、不効率、遅延を明らかにする
- 繰り返されるサービスの問題を見つける
- リソースの配分とトレンド分析を改善する
- 製品の革新で対処すべき顧客の痛点を発見する
- ブランドと競合他社に関するソーシャルメディアでの顧客の感情を追跡する
- ユーザーとのカスタマイズされた相互作用を導く行動パターンを特定する
- ブランドメッセージとブランドの相互作用を洗練する
- 顧客とのアップセル、クロスセル、再エンゲージメントの機会を学ぶ
- 未知のセキュリティリスクに光を当てる
- コンプライアンスを改善するためのデータをキャプチャする
追加リソース
このトピックについて詳しくは、BMC機械学習&ビッグデータブログを探求するか、以下の資料を閲覧してください:
- データは新しい電力
- データパイプラインとは?
- データ管理とデータガバナンスの主な違い
- 機械学習パイプラインの作成方法
- サイバーセキュリティに機械学習を適用する方法
- データセンターネットワークセキュリティにおける機械学習の役割

これらの投稿は私自身の意見であり、BMCの立場、戦略、または意見を必ずしも代表するものではありません。