




ポイント: R2スコアと平均二乗誤差 (MSE) は、回帰モデルの精度を評価するための重要な指標です。これらは、独立変数が従属変数の変動をどれだけ説明するかを判断するのに役立ちます。これは金融やヘルスケアなどの分野で重要です。
- R2スコアは、モデルによって説明される分散の割合を示します。
- MSEは、観測値と予測値の間の二乗差の平均を測定します。
今日は、回帰モデルの精度と質を決定するために重要な用語をいくつか紹介します。
これらの概念をscikit-learnを使用して説明します。
回帰モデルの使用方法
これらの指標を理解することで、回帰モデルが正確か誤解を招くものかを判断するのに役立ちます。回帰という統計技術を使用することで、データのパターン、傾向、関係を明らかにし、将来への洞察を提供します。独立変数が従属変数にどのように影響するか、またその関係の強さを確認できます。
将来の可能性を見通し、接続と依存関係を理解する能力は、さまざまなシナリオの計画やリスクの評価と対処にとって非常に重要です。金融、ビジネス分析、エンジニアリング、ヘルスケア、科学、スポーツ、コンピュータサイエンスなど、さまざまな高リスク産業が回帰モデルを広範に利用しています。
なぜR2スコアが機械学習で重要なのか
回帰モデルの価値は、その精度、特にデータの分散をどれだけうまく説明するかに依存します。だからこそ、R2スコアを改善することが非常に重要です。機械学習とAIは協力して、適切な変数を特定し、モデルを微調整して予測を改善し、複雑で非線形な大規模データセットの中で識別が難しい関係を捉えます。
AIと機械学習は、モデルがデータの変動をどのように適合または説明するかを改善し、予測をより正確にします。重要な関係を見逃すアンダーフィッティングや、意味のないノイズを持ち込むオーバーフィッティングを減少させます。目標は、正確な結果を生成し、より良い予測を支援する効率的なモデルです。
機械学習におけるバイアス-バリアンストレードオフについてさらに学びましょう。
例を見ていくことで、これらの概念をより良く理解することができます。私たちの前回のブログ記事からのコードを使用し、追加のロジックを加えましょう。前回のブログ記事では、独立変数yと従属変数xが相関するようにして、scikit-learnを使った線形回帰の基本を説明しました。今回は、従属変数(y)にランダム性を導入し、予測にいくらかの誤差を加えます。
AIOpsを始めるのは簡単です。ITの複雑さを簡単に管理する方法を学びましょう! ›
分散とは何か?
線形回帰の観点から、分散は観測値が予測値の平均からどれだけ異なるかを測る指標です(つまり、予測値の平均からの差)。目標は、R2スコアによって定量化された低い値を持つことです(以下で説明します)。
以下のコードでは、これはnp.var(err)であり、ここでerrは観測値と予測値の差の配列で、np.var()はnumpyの配列分散関数です。
R2スコアとは何か?
R2スコアは、“独立変数から予測可能な従属変数の分散の割合”であるとWikipediaに記載されています。数学的定義は「(モデルによって説明された総分散)/総分散」です。したがって、100%の場合、2つの変数は完全に相関していることになります(つまり、全く分散がない)。
R2スコアは0%から100%の間で変動します。これはMSEと密接に関連していますが、同じではありません。
ほとんどの場合、低い値は低い相関レベルを示し、無効な回帰モデルを意味します。
以下のコードを読むと、これは理解を容易にするために3つのステップで計算されます。まず、 g は、予測値と実際の観測値の二乗差の合計です: (ytest[i] – preds[i])²。次に、総二乗和は、各観測値と観測値の平均との二乗差を使用して計算されます: (ytest[i] – np.mean(ytest))²。結果は次のように印刷されます:
g
は、予測値と実際の観測値の二乗差の合計です: (ytest[i] – preds[i])²。次に、総二乗和は、各観測値と観測値の平均との二乗差を使用して計算されます: (ytest[i] – np.mean(ytest))²。結果は次のように印刷されます:
    print ("total sum of squares", y)
print ("ẗotal sum of residuals ", g)
print ("r2 calculated", 1 - (g / y))
ここでの目標は説明することです。もちろん、scikit-learnのr2_score()メソッドを使ってこれを行うことができます。
print("R2 score : %.2f" % r2_score(ytest,preds))
平均二乗誤差 (MSE) とは何か?
平均二乗誤差 (MSE) は、誤差の二乗の平均です。数が大きくなるほど、誤差も大きくなります。この場合の誤差は、観測値y1、y2、y3、…と予測値pred(y1)、pred(y2)、pred(y3)、…との間の差を意味します。各差(pred(yn) – yn)の二乗を計算して、負と正の値が互いに相殺されないようにします。
PythonでのMSEの計算方法
こちらがMSEを計算するための完全なコードです:
結果:
    import matplotlib.pyplot as plt

from sklearn import linear_model

import numpy as np

from sklearn.metrics import mean_squared_error, r2_score

reg = linear_model.LinearRegression()

ar = np.array([[[1],[2],[3]], [[2.01],[4.03],[6.04]]])

y = ar[1,:]

x = ar[0,:]

reg.fit(x,y)

print('Coefficients: n', reg.coef_)

xTest = np.array([[4],[5],[6]])

ytest =  np.array([[9],[8.5],[14]])

preds = reg.predict(xTest)

print("R2 score : %.2f" % r2_score(ytest,preds))

print("Mean squared error: %.2f" % mean_squared_error(ytest,preds))

er = []

g = 0

for i in range(len(ytest)):

print( "actual=", ytest[i], " observed=", preds[i])

x = (ytest[i] - preds[i]) **2

er.append(x)

g = g + x

x = 0

for i in range(len(er)):

x = x + er[i]

print ("MSE", x / len(er))

v = np.var(er)

print ("variance", v)

print ("average of errors ", np.mean(er))

m = np.mean(ytest)

print ("average of observed values", m)

y = 0

for i in range(len(ytest)):

y = y + ((ytest[i] - m) ** 2)

print ("total sum of squares", y)

print ("ẗotal sum of residuals ", g)

print ("r2 calculated", 1 - (g / y))
結果:
    Coefficients:

[[2.015]]

R2 score : 0.62

Mean squared error: 2.34

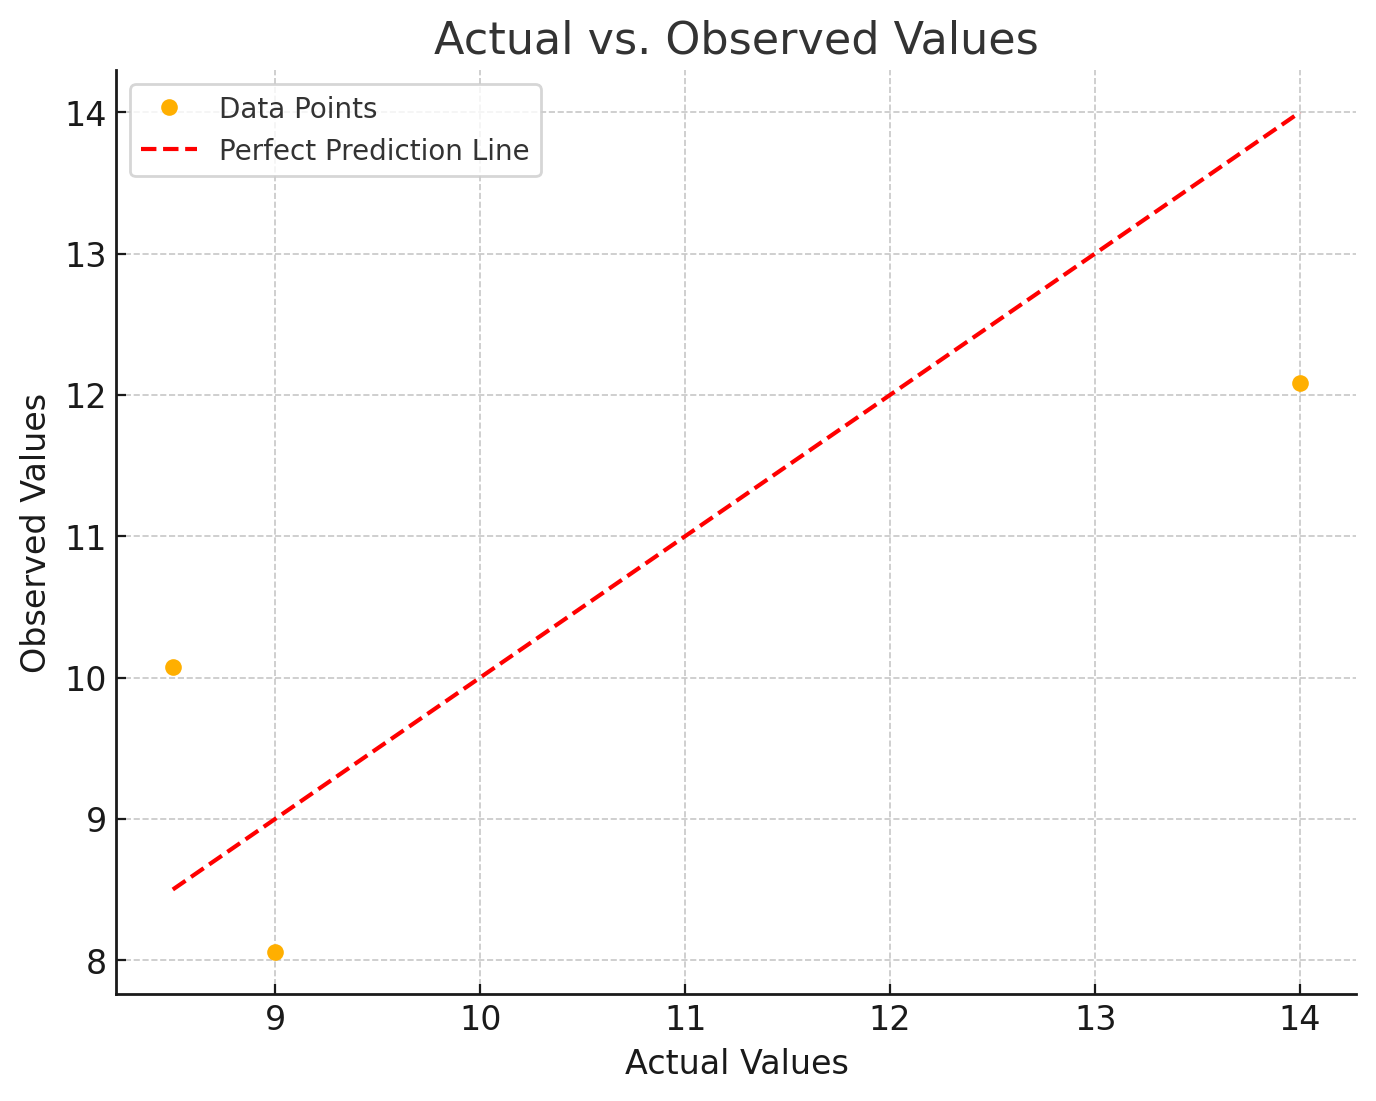
actual= [9.] observed= [8.05666667]

actual= [8.5] observed= [10.07166667]

actual= [14.] observed= [12.08666667]

MSE [2.34028611]

variance 1.2881398892129619

average of errors 2.3402861111111117

average of observed values 10.5

total sum of squares [18.5]

ẗotal sum of residuals [7.02085833]

r2 calculated [0.62049414]
データを見てみると、np.array([[[1],[2],[3]], [[2.01],[4.03],[6.04]]])のように、すべての従属変数が独立変数の約2倍であることがわかります。計算された係数reg.coef_は2.015であることが確認されています。
良い平均二乗誤差 (MSE) とは何か?
MSEには正しい値はありません。簡単に言えば、値が低いほど良く、0はモデルが完璧であることを意味します。正しい答えがないため、MSEの基本的な価値は、ある予測モデルを別のものよりも選択することにあります。
同様に、R2が何であるべきかについても正しい答えはありません。100%は完璧な相関を意味します。しかし、低いR2のモデルでも依然として良いモデルがあります。
r2とMSEを一緒に解釈する
ここでのメッセージは、モデルを評価する際にこれらの指標を単独で見ることはできないということです。他の指標も考慮し、基礎にある数学を理解する必要があります。今後のブログ投稿でこれらすべてに触れていきます。
追加リソース
scikit Learnガイド
これらの投稿は私自身の見解であり、必ずしもBMCの位置、戦略、または意見を代表するものではありません。