




ポイント: HDFSへのイントロダクションは、そのアーキテクチャとHadoop内でのファイル管理について説明し、レジリエンスのためのデータレプリケーションとファイルを更新できないといった制限を強調しています。また、バッチ処理に対するHDFSの適性と無限のファイルサイズの成長の可能性も強調しています。
- HDFSはネームノードにメタデータストレージを介して無限のファイルサイズの成長をサポートします。
- ファイルは書き込みまたは削除のみ可能であり、バッチ処理のために設計されています。
HDFSのネームノードとデータノード
Hadoopには、MapReduceジョブを実行するための分散アーキテクチャと、データを分散アーキテクチャで保存するための分散ファイルシステム(HDFS)が含まれています。ここではHDFSについて説明します。
通常のPCやサーバーの通常のファイルでは、コンピュータは連続するディスクスペースにファイルを保存します。このディスクスペースはブロックと呼ばれます。中央のメカニズムが、どのブロックがどのディスクの場所に保存されているかを追跡します。PCやサーバーでは、これをFAT(ファイル割り当てテーブル)またはNTFS(新技術ファイルシステム)と呼びます。また、どのデータがどこに書き込まれているかを追跡する他の構造もあります。
磁気ディスクドライブでは、データはディスクコントローラーと呼ばれる移動デバイスを使用してディスクに書き込まれます。HDFSでは、書き込みはHadoopネットワークプロトコルを使用してネットワークを介して個々のサーバーにプッシュされ、サーバーはHadoopデータノード操作をFATまたはNTFSと組み合わせてホストマシンのデータブロックに書き込みます。通常、コストを下げるためにローカルに接続されたストレージが使用され、ストレージアレイやストレージラックは使用されません。(低い運用コストはHadoopの販売ポイントの1つです。)
Hadoopは、ファイルメタデータ(ブロックの位置など)をマスターサーバーのネームノードプロセスに保存し、無限の数のデータノードにデータを保存することによって、固定ディスクサイズの物理的制限を取り除きます。
クラスタ内の各ノードで実行されているデータノードプロセスが、そこでディスクブロックにデータを書き込みます。
通常のファイルシステムとは異なり、HDFSはアーキテクチャと管理者が自由にノードを追加できるため、制限なしに成長できます。この抽象化により、複数のコンピュータにまたがる単一のファイルが存在し、ファイルのサイズに制限なく成長できます。
ただし、これは便利なバケット表記としても機能し、ユーザーはマウントされているディレクトリについて考えることなくファイルを保存できます。たとえば、任意の種類のファイルをhdfs://(サーバー名):ポートにコピーし、ネットワーク上の任意のコンピュータからそれを取得できます。
Spark、Storm、Cassandra Hbase、Hiveなどの多くの他のビッグデータ製品は、アプリケーションにHDFSの少なくとも一部を使用しています。

HDFSはデータを書き込むだけで、更新しません
Hadoopでは、ファイルを書き込むことと削除することしかできません。更新することはできません。
システムは、各データノードがメモリをディスクデータブロックに書き込むとき、複製を使用して別のサーバーにもそのメモリを書き込むように設計されており、堅牢で失敗しないようになっています。レプリカの数はユーザーによって設定されます。そして、データノードはラックを意識させることができます。これは、冗長性が同じラックにある2つのディスクドライブにデータを書き込むときに機能しないためです。同じ電源とネットワーク接続を共有します。
通常のPCのデータブロックは、サイズが約4Kまたは64Kです。しかし、Hadoopでは、通常64MBです。
Hadoopはバッチシステムであるため、データを迅速に読み取るようには設計されていません。代わりに、大量のデータを書き込み、バッチMapReduceジョブを使用してそれを取得するように設計されています。
以下に、基本的なアーキテクチャの図を示します。
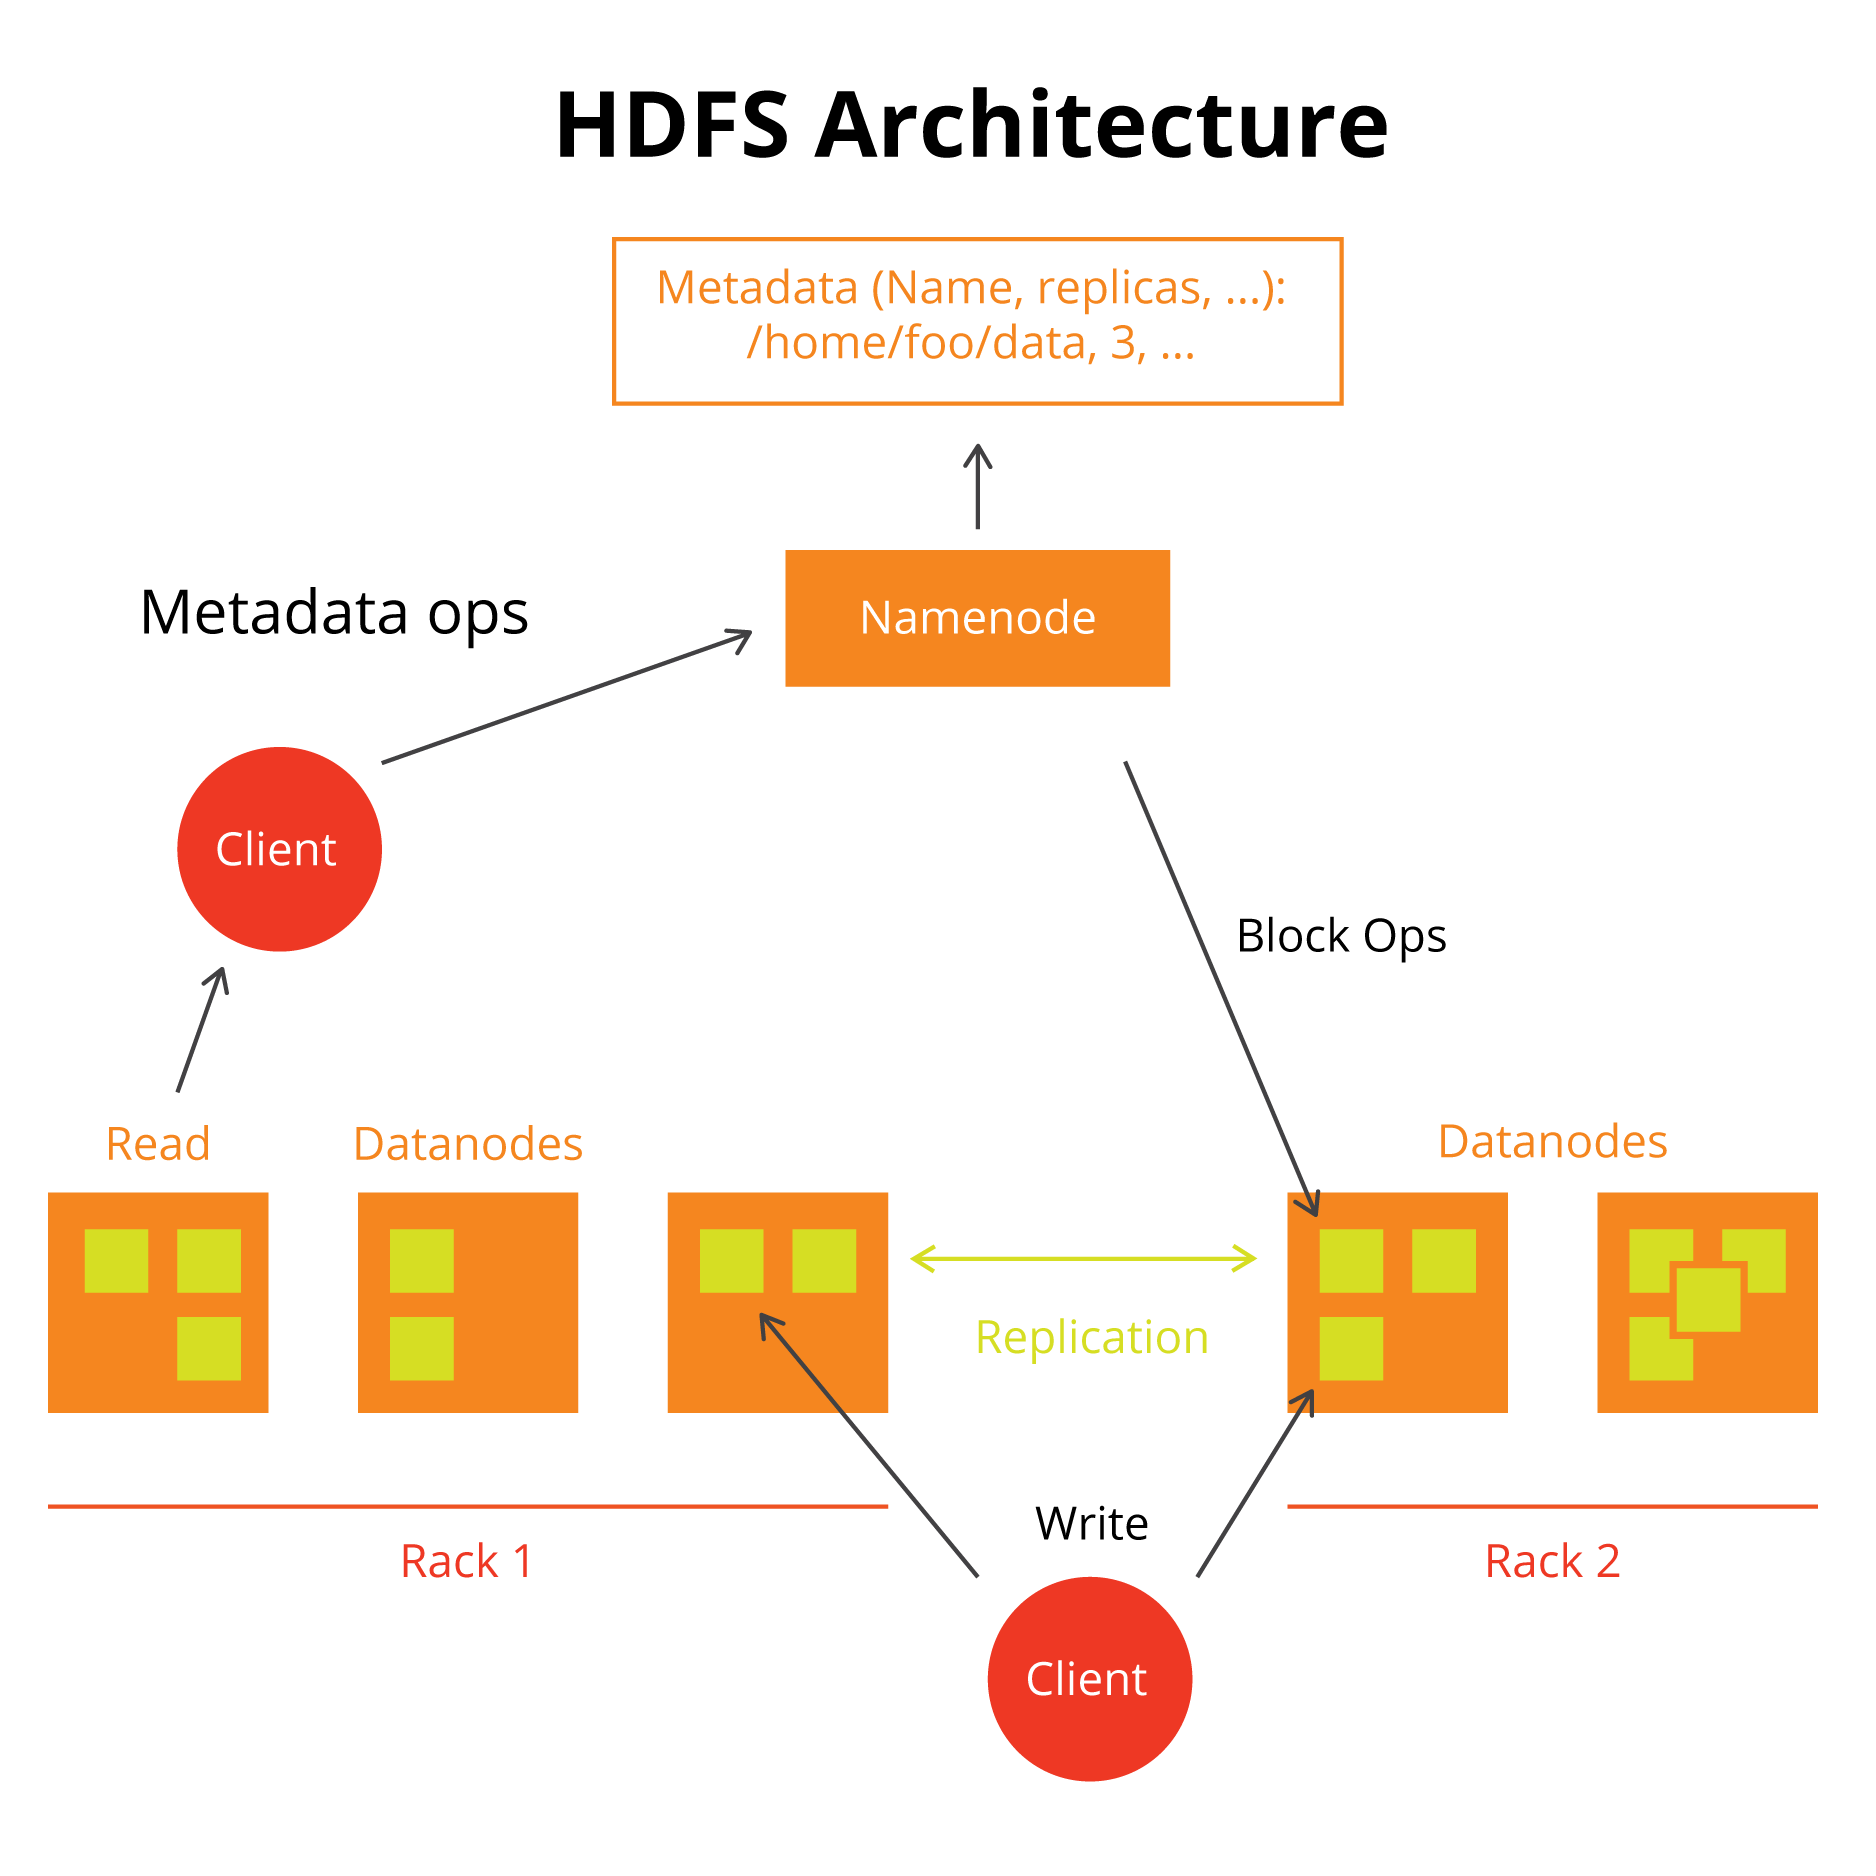
ここでは、マウントポイント/home/foo/dataが表示されます。これは名前空間と呼ばれます。このフォルダーはどのディスクにも存在せず、クラスタ全体にわたる抽象化です。名前空間はすべてのデータノードに存在します。
ネームノードはデータノードにデータの書き込み先を指示します。データノードは、どのブロックとドライブにデータを書き込んだかをネームノードに報告し、中央リポジトリがそれを知ることができます。ネームノードはその情報をセカンダリネームノードに複製します。
データノードは、通常のPCと同様に、ブロック形式でローカルストレージにデータを書き込みます。したがって、失敗したディスクドライブの場合、ネームノードは別のデータノードにデータを再構築できます。(大規模なデータセンターでは、ディスクドライブが毎日故障します。)ネームノードは、すべての書き込み操作を追跡するためにEditlogを使用します。編集ログは、通常のディスクローカルストレージのネームノードサーバーに書き込まれます。このファイルはFSImageと呼ばれます。Hadoopは、トランザクションがデータノードに書き込まれるFSImageメタデータファイルに書き込まれると、Editlogを切り捨てます。
HDFS CLI
Hadoopファイルは、次のJavaプログラムのようなAPIを使用してクライアントプログラムから、またはコマンドラインから操作します。コマンドは通常のLinuxコマンドとほぼ同じです: ls、mkdir、chownなどです。したがって、非常に使いやすいです。唯一の違いは、「hadoop fs -(コマンド)」を書くことです。たとえば、hadoop fs -lsはディレクトリ(名前空間)内のファイルをリストします。
CLIコマンドの完全なリストは次のとおりです:
appendToFile cat checksum chgrp chmod chown copyFromLocal copyToLocal count cp createSnapshot deleteSnapshot df du dus expunge find get getfacl getfattr getmerge help ls lsr mkdir moveFromLocal moveToLocal mv put renameSnapshot rm rmdir rmr setfacl setfattr setrep stat tail test text touchz truncate usage
コマンド出力は通常のLinuxコマンドとまったく同じように見えます:
    hadoop fs -ls /data
-rw-r--r--   1 root supergroup    1081141 2017-03-31 15:37 /data/ssh.log
HDFSの構成
HDFSパラメータリストは非常に長く、Hadoopマニュアルで確認するのが最適です。簡単に言うと、ローカルまたはノードモードでHadoopを実行するために設定する必要があるパラメータはごくわずかです。ストレージに関連する最も一般的なものは以下に示されています:
hdfs-site.xml
    dfs.namenode.name.dir
      file:///usr/local/hadoop


      dfs.datanode.name.dir
      file:///usr/local/hadoop
core-site.xml
    fs.defaultFS
      hdfs://hadoop-master:9000/


Turns on or off permissions checking.


      dfs.permissions
      false
Java
HadoopはJavaで書かれています。Apache Pigは、コンソールに入力されたSQLコマンドに基づいてJava MapReduceプログラムを作成します。したがって、HDFSで作業する場合はJavaを知っておくと良いでしょう。
ここでは、HDFS内のファイルに文字列をコピーするためのプログラムHdfs.javaの例を示します。
最初に環境をソースします:
export HADOOP_CLASSPATH=$($HADOOP_HOME/bin/hadoop classpath)
プログラムを次のようにコンパイルします:
javac -classpath ${HADOOP_CLASSPATH} Hdfs.java
次に、次のように実行します:
java -cp .:$HADOOP_CLASSPATH Hdfs
ここがHdfs.javaのソースです。
    import java.io.BufferedInputStream;
import java.io.BufferedOutputStream;
import java.io.File;
import java.io.FileInputStream;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.InputStream;
import java.io.OutputStream;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataInputStream;
import org.apache.hadoop.fs.FSDataOutputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;

public class Hdfs {


public static void main(String[] args) throws IOException {

Configuration conf = new Configuration ();
FileSystem fileSystem = FileSystem.get(conf);

	Path path = new Path("/data/silly.txt");

  FSDataOutputStream out = fileSystem.create(path);


String helloWorld = "Hello Hadoop World.";

out.writeBytes(helloWorld);

out.close();
fileSystem.close();

}

}
これを最初に実行すると、次のエラーが発生します:
Permission denied: user=walker, access=WRITE, inode="/data":root:supergroup:drwxr-xr-x
Linuxのchownコマンドと同様に、フォルダーの権限を変更してください:
hadoop ds -chown walker /data
その後、ファイルの内容を表示して、それが機能していることを示します:
    hadoop fs -cat /data/silly.txt

Hello Hadoop World.
Hadoopファイル名
MapとReduceによって作成されたHadoopファイルは、フォルダー内のさまざまな数のファイルとして保存されます。
これは、そのようなジョブが並列プロセスに分割され、クラスタ全体で実行されるためです。
MapReduceジョブを実行し、出力フォルダーを次のように設定すると:
FileOutputFormat.setOutputPath(job, “/data.txt);
出力は、フォルダー/data.txt/内の「success」と「partn」と呼ばれるファイルに分割され、nはこのステップが分割された数を示します。
Hadoopファイルストレージ
Hadoopはいくつかのファイルストレージ形式を使用しており、Avro、Parquet、Sequence、およびTextが含まれます。
Avro
HadoopのAvroシリアル化は、データをJSONバイト形式で書き込むため、どの言語で書かれたプログラムでも消費できるようにします。AvroはHadoopに組み込まれています。(シリアル化とは、フィールドやWebセッション、ファイルなどのデータをストレージに書き込むことを意味します。)Avroを使用すると、プリミティブ(例: int、float、boolean)に加えて、複雑な構造(配列、カスタムクラス)を表現できます。
Parquet
Parquetは、ClouderaとTwitterによってHadoopに追加された行および列のストレージ形式です。Hbaseのように、データの列を保存するためのHadoop上のストレージメカニズムであり、行-列ストレージ設計で高速に取得できるように、データが近接して配置されます。HBaseは、GoogleのBig Tableデータベースのオープンソース実装です。Parquetは、Java、Python、その他の言語で定義したクラスとそのメンバーフィールドおよび関数をまとめて、大量に複雑な構造をシリアル化するように設計されています。ParquetはApache Hive、Pig、およびSparkストレージもサポートしています。
Sequenceファイル
JSONテキストファイルですが、バイナリで保存されています(key-value=形式)。したがって、(a=>b)は(01100001->01100010)として保存されます。シーケンスファイルには3つのタイプがあり、キーと値が圧縮されているかどうかが異なります。これらは次のコーデックを使用して圧縮されます: BZip2Codec、DefaultCodec、GzipCodec。それらがどのように機能するかを説明することなく、6ビットの1の文字列は「6の1」として書き込むことができ、実際の6の1よりも少ないスペースを取ります。
プレーンテキスト(csvおよびtxt)
説明は不要です。Javaでは次のように指定されます:
job.setOutputFormatClass(TextOutputFormat.class);
クラウド内のHadoop
異なるベンダーが独自のHadoop抽象化を実装しています。たとえば、Windows AzureやAmazon EC2およびS3などです。実際、S3はすでにHadoopのようなURLタイプのファイルシステムであり、ディレクトリ名を//server/directory/fileのように置き換え、http://のようになります。ClouderaはHadoopをビジネスの大部分にしています。
Hadoopガイド
- 初心者のためのHadoopチュートリアル: Hadoopの基本
- Hadoop管理の紹介
- Hadoopセキュリティの紹介
- Apache Flumeの紹介
- Hiveの紹介
- HDFSへのイントロダクション
- Hbaseの紹介
- Hadoopの例: 5つの実世界のユースケース
- Hadoopキャリア: 採用されるために
- Hadoop面接質問
- Hadoop分析へのイントロダクション
- Apache Pigの紹介
- Apache Yarnの紹介
- Hadoopアーキテクチャの紹介
- Hadoopの利点と利点
- Apache CassandraとのHadoopの使用
- Hadoop vs Kubernetes: K8sとクラウドネイティブはHadoopを終わらせるのか?
- Hadoop認定
- Hadoopクラスタ: イントロダクション
- Hadoopエコシステムとコンポーネント
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。