




ポイント: Hadoopクラスターは、マスターノード(NameNode)と複数のスレーブノード(DataNodes)を特徴とし、ノード間で分散処理を通じてデータ管理を向上させます。Apache Yarnはリソースを効果的に管理し、線形スケーラビリティを実現します。クラスターは簡単に拡張でき、Apache Ambariが管理タスクを簡素化します。
- Hadoopのアーキテクチャは、効率的なデータ操作と高可用性をサポートします。
- Ambariは、クラスターの監視およびオーケストレーションのための堅牢なツールを提供します。
Hadoopクラスター101
Hadoopクラスターについて話すとき、最初に定義する必要がある用語が2つあります:クラスターとノード。クラスターはノードのコレクションです。ノードとは、仮想または物理マシンまたはコンテナで実行されているプロセスです。プログラムはHadoop以外の他のプログラムを実行しているため、プロセスと言います。
Hadoopがクラスター モードで実行されていない場合、それはローカル モードで実行されていると言われます。それは、たとえば、Hadoopを1台のマシンにインストールして学ぶのに適しています。ローカル ノードでHadoopを実行すると、Hadoop Distributed File System (HDFS)の代わりにローカル ファイル システムにデータが書き込まれます。
Hadoopはマスター-スレーブ モデルで、1つのマスター (オプションの高可用性ホットスタンバイを含む) が多くのスレーブの役割を調整します。Yarnは、利用可能なCPU、メモリ、ネットワーク帯域幅、およびストレージを考慮して、タスクがどこで実行されるかを調整するリソース マネージャーです。
Hadoopクラスターをスケールアウトすることができます。つまり、ノードを追加することができます。Hadoopは線形スケーラブルであると言われています。つまり、追加するノードごとにスループットが対応して増加します。一般的に、n ノードがある場合、1 モードを追加すると (1/n) の追加のコンピューティング パワーが得られます。このタイプの分散コンピューティングは、メモリとCPUを追加してもスループットがわずかにしか増加しない単一サーバーを使用していた時代からの大きな変化です。

DataNodeとNameNode
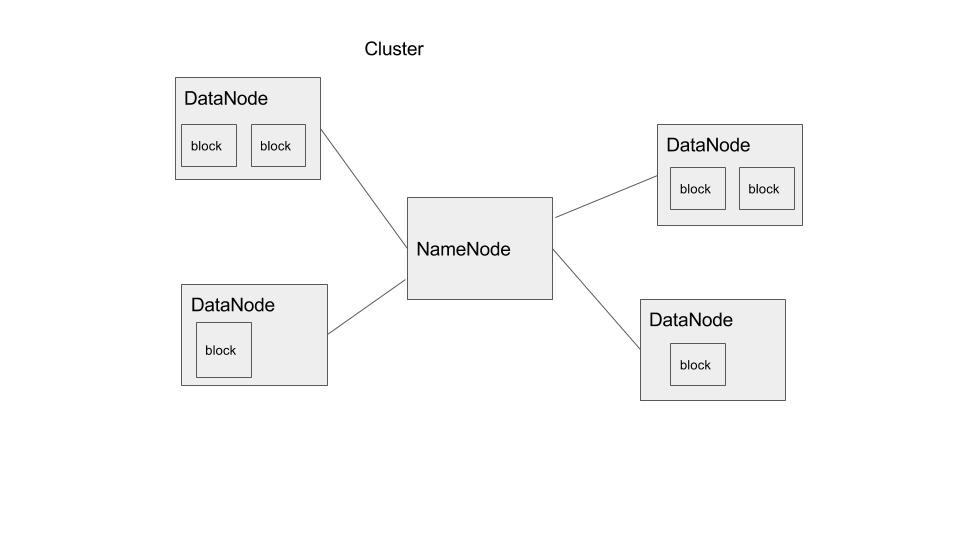
NameNodeはHadoopのマスターです。データをコピーしたり、mapReduce操作を実行したりする際に、クラスター内のDataNodeと相談します。この設計により、ユーザーは/dataのようなHadoopマウントポイントに非常に大きなファイルをコピーできます。/dataにコピーされたファイルは、クラスター内の異なるDataNodeにブロックとして存在します。DataNodeのコレクションをHDFSと呼びます。
この基本的なアイデアは以下に示されています。
Yarn
Apache YarnはHadoopの一部であり、スタンドアロンリソースマネージャーとしてHadoopの外でも使用できます。NodeManagerは、Yarnスケジューラから指示を受け取り、どのノードがどのタスクを実行するかを決定します。YarnはリソースマネージャーとNodeManagerの2つの要素から構成されています。NodeManagerは、リソースマネージャーにCPU、メモリ、ディスク、およびネットワークの使用状況を報告し、リソースマネージャーが新しいタスクをどこに指示するかを決定できるようにします。リソースマネージャーは、スケジューラとアプリケーションマネージャーを使用してこれを行います。
クラスターにノードを追加
Hadoopクラスターにノードを追加するのは、$HADOOP_HOME/conf/slavesファイルにサーバー名をコピーして新しいノードでDataNodeデーモンを起動するだけです。
ノード間の通信
Hadoopをインストールすると、sshを有効にし、Hadoopユーザー用のsshキーを作成します。これにより、Hadoopはパスワードを入力することなく、RCP(リモート手続き呼び出し)を使用してノード間で通信できます。正式には、TCPプロトコルの上にあるこの抽象化は、クライアントプロトコルおよびDataNodeプロトコルと呼ばれます。DataNodeは、まだ動作していることを知らせるためにNameNodeにハートビートを送信します。
Hadoopノードの構成
Hadoopの構成は非常に簡単で、マスターで構成を行い、その後データノードに直接Hadoopソフトウェアをコピーします。各ノードで異なる構成を維持する必要はありません。
主なHadoop構成ファイルはcore-site.xmlとhdfs-site.xmlです。ここで、Hadoopファイルにアクセスできるポート番号、レプリケーション係数(すなわち、データブロックのレプリカまたはコピーの数)、FSImageの場所(データファイルの変更を追跡します)などを設定します。また、デフォルトではセキュリティがないHadoopクラスターにセキュリティを追加するために認証を構成することもできます。
クラスター管理
HadoopにはコマンドラインインターフェースとAPIがあります。しかし、新しいマシンの管理(監視を含む)を行うための実際のツールはありません。
それに対するいくつかのオプションがあります。一つはApache Ambariです。これは、Hortonworksのような特定のHadoopクラウドによって使用され、推奨されています。
以下はHortonWorksのAmbariダッシュボードのビューです:
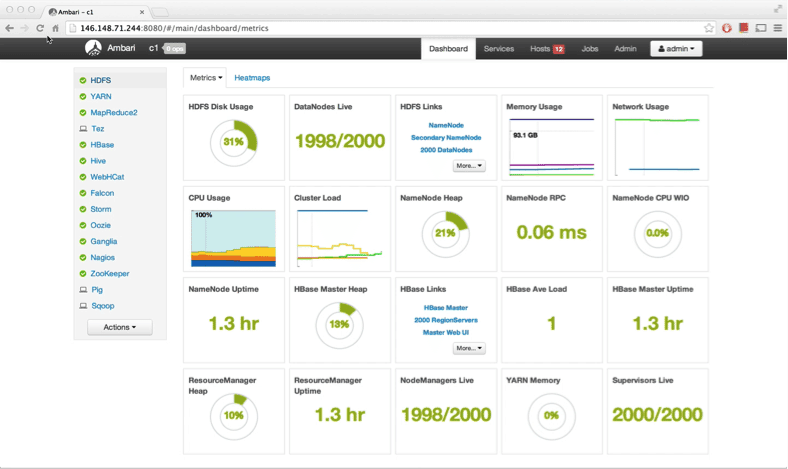
見ての通り、基本的で非常にシンプルなHadoopおよびYarnのWebインターフェースでは提供されない、多くのメトリックやツールがあります。
それはREST Web APIとしてサービスを公開します。したがって、他のベンダーはこれをMicrosoft Systems CenterやTeradataのような運用プラットフォームに追加しています。
Ambariを使用すると、各データノードでstop-dfs.shを入力するのではなく、ロールイング再起動機能を使用して、変更を実装する際に各マシンを再起動できます。手元に数台以上のマシンがある場合、コマンドラインからこれを行うのは時間がかかることを想像できます。
Ambariは、同時に複数のクラスターを管理するのにも役立ちます。そして、各クラスターを構築するには、Ambari Blueprintウィザードを使用してNameNode、DataNodeの配置や構成の詳細を提供できます。これは、開発またはテストクラスターを構築し、それらのビルドを自動化するためにも便利です。ウィザードを1回実行するだけで、APIとして保存されるため、新しいクラスターを構築するスクリプトを作成できます。
Hadoopガイド
- 初心者向けHadoopチュートリアル:Hadoopの基本
- Hadoop管理の入門
- Hadoopセキュリティの入門
- Apache Flumeの入門
- Hiveの入門
- HDFSの入門
- Hbaseの入門
- Hadoopの例:5つの実世界のユースケース
- Hadoopキャリア:採用されるために
- Hadoop面接質問
- Hadoop分析の入門
- Apache Pigの入門
- Apache Yarnの入門
- Hadoopアーキテクチャの入門
- Hadoopの利点とメリット
- Apache CassandraとのHadoopの使用
- Hadoop vs Kubernetes:K8sとクラウドネイティブはHadoopを終わらせるのか?
- Hadoop認定
- Hadoopクラスター:入門
- Hadoopエコシステムとコンポーネント
これらの投稿は私自身の意見であり、BMCの立場、戦略、または意見を必ずしも表しているわけではありません。