




ポイント: Hadoop管理へのイントロダクションは、Hadoopクラスターの主要な管理タスクをカバーし、セキュリティ、パフォーマンス調整、データノード管理に焦点を当てています。それは高可用性を維持することの重要性を強調し、監視のためのウェブインターフェースの使用についてのガイダンスを提供します。
- 一般的なタスクには、クラスターの健康状態を監視し、データノードを追加することが含まれます。
- セキュリティ機能には、Kerberos認証とデータ暗号化設定が含まれます。
ここでは、最も一般的なHadoop管理タスクの一部を説明します。多くのタスクがあるため、主要なもののいくつかについてのみ説明します。読者は、各トピックをさらに深く掘り下げるためにApache Hadoopのドキュメントを参照することをお勧めします。
管理コマンドやタスクを進める際に、各Hadoopのバージョンはわずかに異なることを知っておくべきです。コマンドスクリプトの名前が変更されることがあります。この例では、Hadoop 2.7.3を使用しています。
この資料を通して作業するには、Hadoopクラスターのセットアップが必要です。クラスターのセットアップ方法については、こちらの指示を参照してください。ローカル専用のHadoopインストールを実行するだけでは、管理タスクを学ぶには不十分です。

一般的な管理タスク
以下は一般的な管理タスクのいくつかです:
- クラスターの健康状態を監視する
- 必要に応じて新しいデータノードを追加する
- オプションでセキュリティを有効にする
- オプションで暗号化を有効にする
- 高可用性を有効にすることが推奨されますが、必須ではありません
- MapReduceジョブ履歴追跡サーバーをオプションで有効にする
- 必要に応じて破損したデータブロックを修正する
- パフォーマンスを調整する
以下でこれらのタスクのいくつかについて説明します。
セキュリティを有効にする
デフォルトでは、Hadoopはセキュリティなしで設定されています。Hadoopをセキュアモードで実行するには、各ユーザーとサービスがKerberosで認証される必要があります。KerberosはWindowsに組み込まれており、Linuxに簡単に追加できます。
Hadoop自体については、ノードはRPC(リモートプロシージャコール)を使用して他のサーバー上でコマンドを実行します。dfs.encrypt.data.transferとhadoop.rpc.protectionを設定して、データ転送とリモートプロシージャコールを暗号化できます。
データを静止状態で暗号化するには、管理者が暗号化キー、HDFS暗号化ゾーン、およびRangerキー管理サービスを設定し、ユーザーとロールを設定する必要があります。
HadoopウェブインターフェースのURL
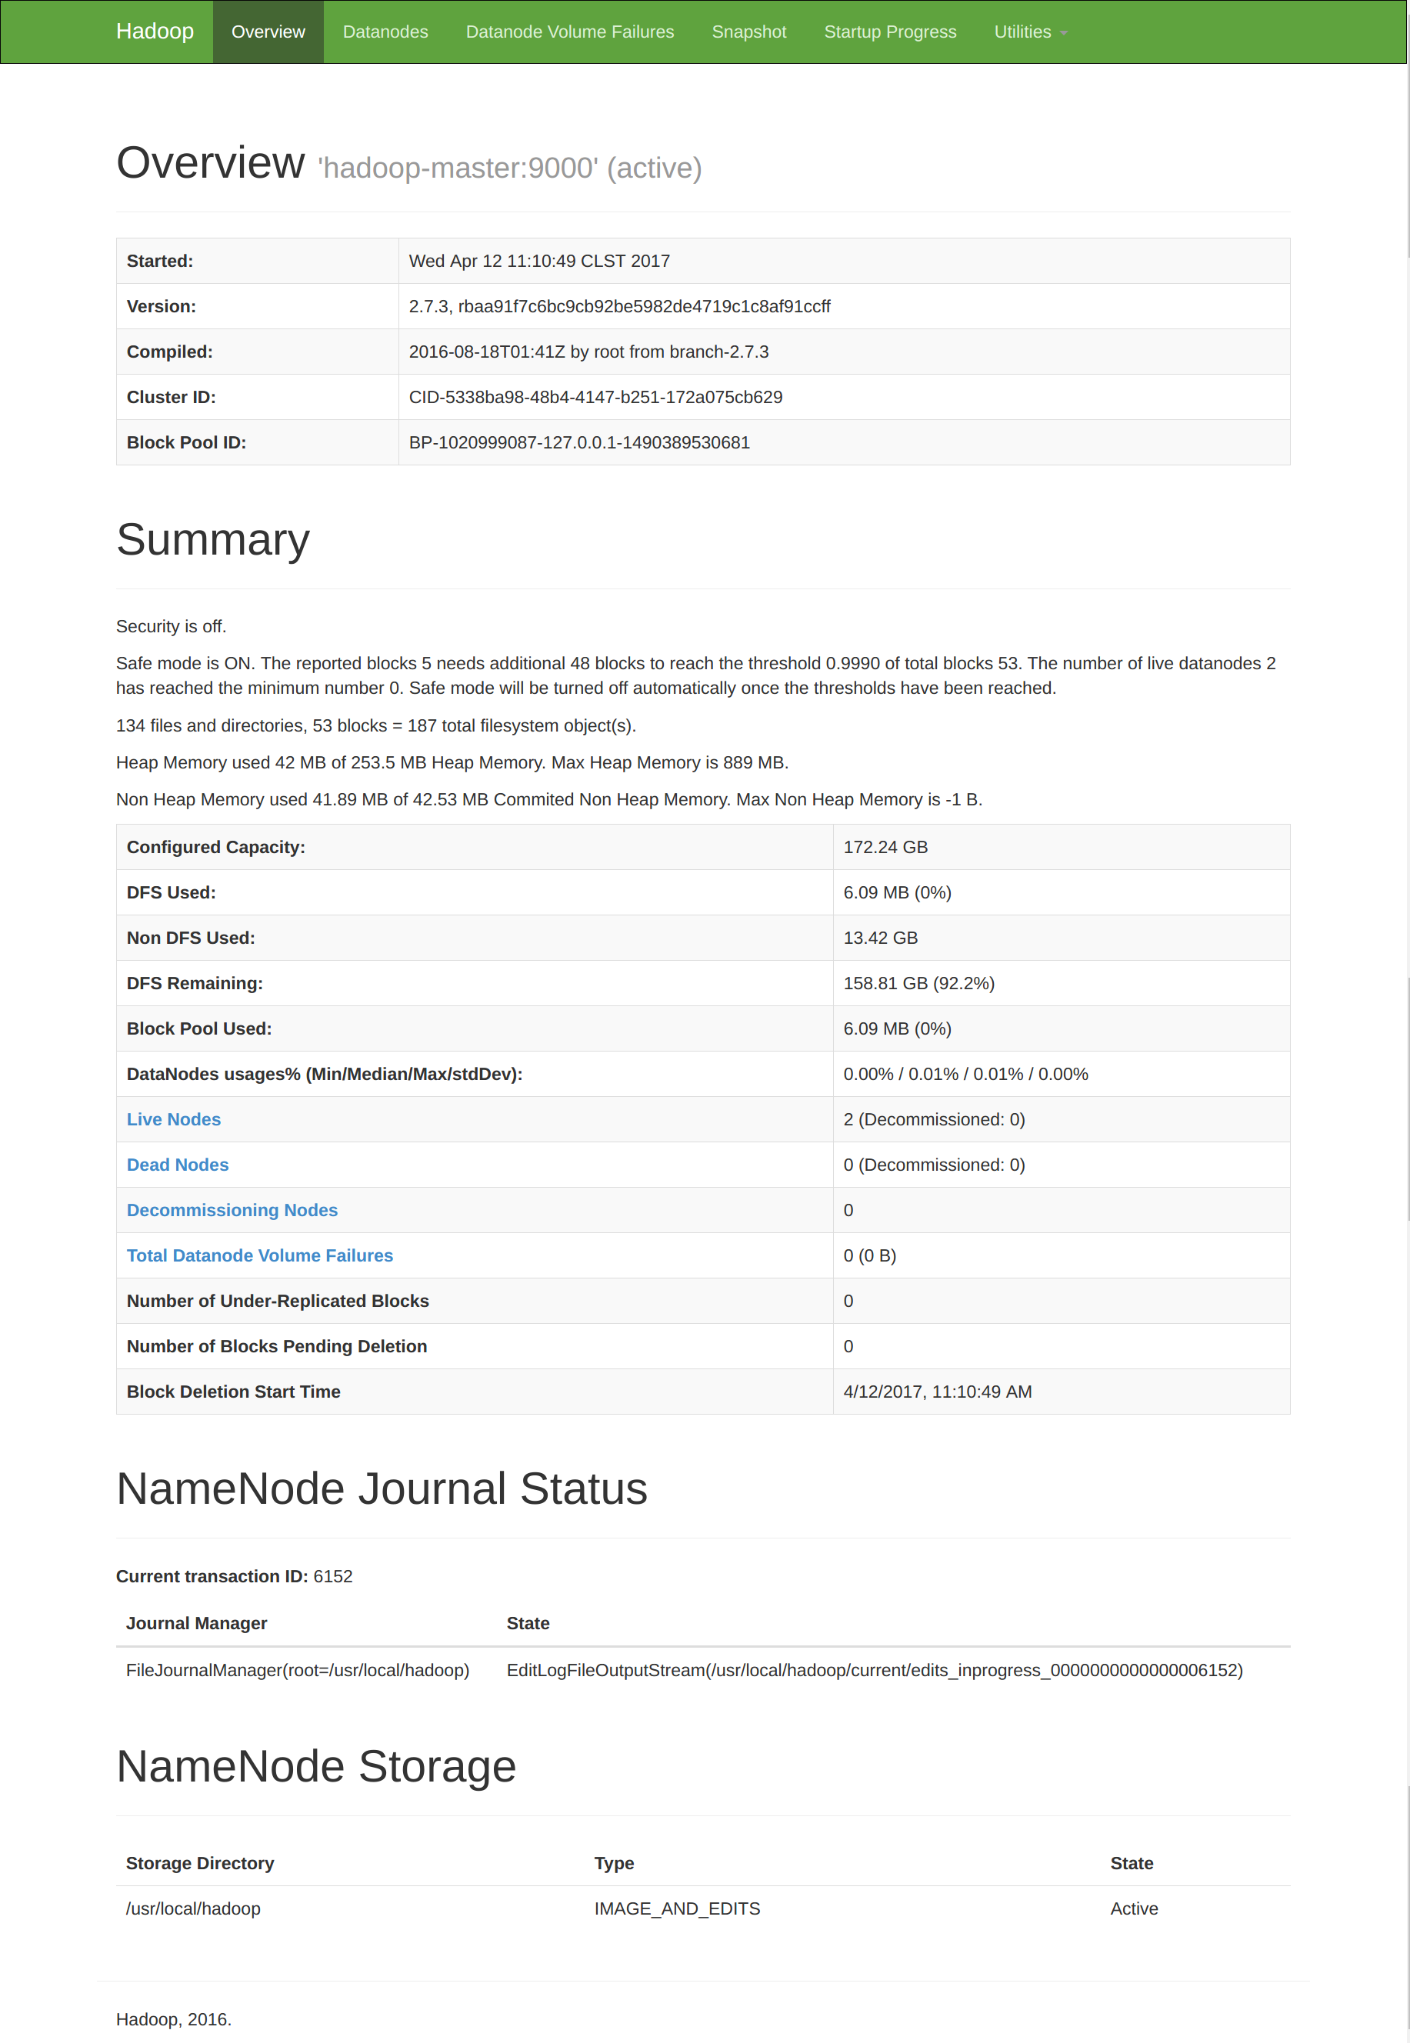
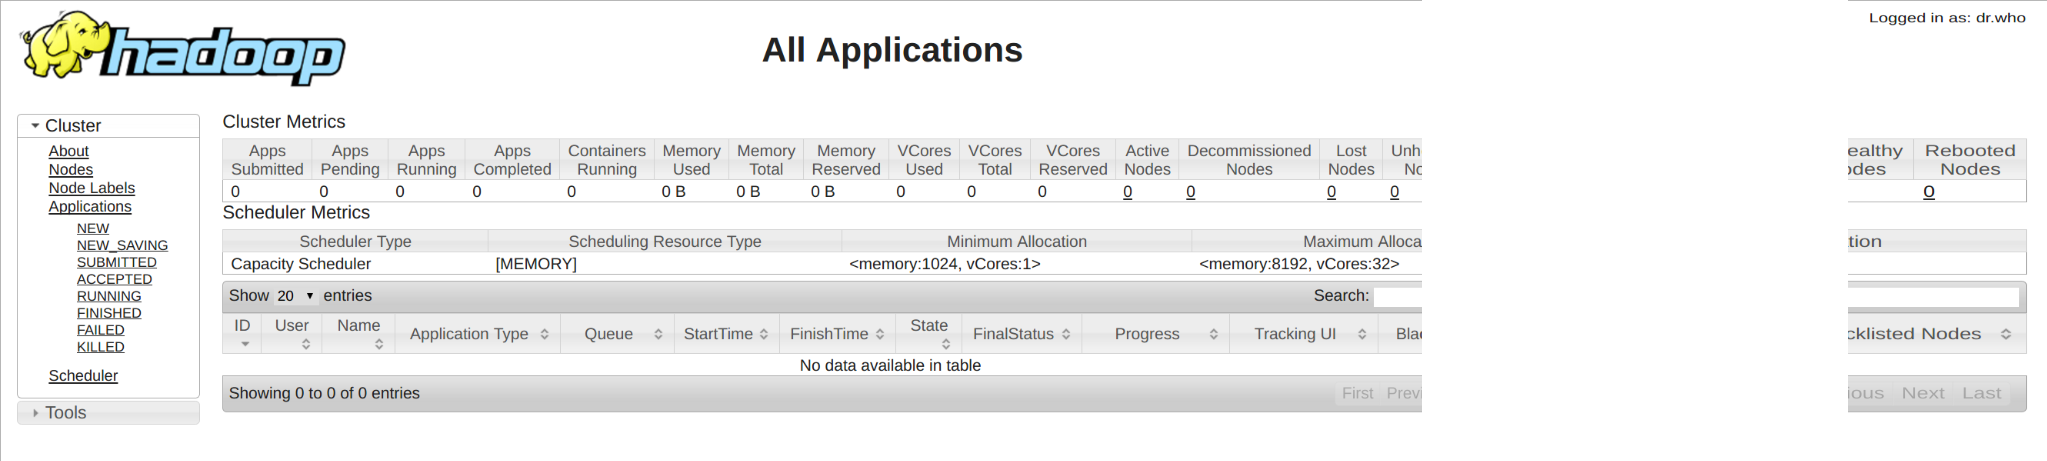
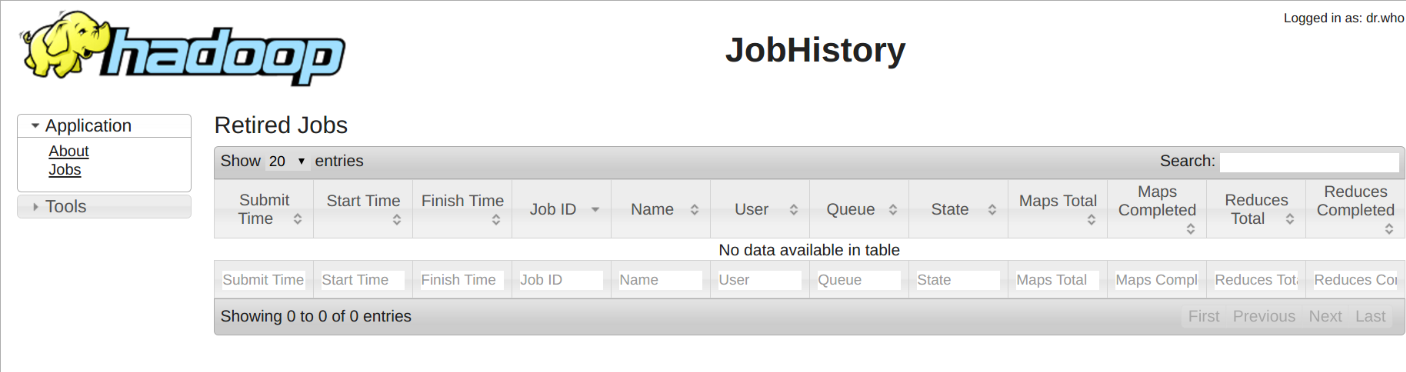
Hadoopで使用する最も一般的なURLは:
| NameNode | http://localhost:50070 |
| Yarnリソースマネージャー | http://localhost:8088 |
| MapReduceジョブ履歴サーバー | http://localhost:19888 |
これらの画面は以下に示されています。
NameNodeメイン画面
Yarnリソースマネージャー
MapReduceジョブ履歴サーバー
MapReduceジョブ履歴サーバー
高可用性を設定する
高可用性は、アクティブ/パッシブ構成で2つの冗長NameNodeを設定し、ホットスタンバイを提供します。これがないと、NameNodeがクラッシュするとクラスターを使用できなくなり、NameNodeが回復するまで待つ必要があります。HAを使用すると、管理者は障害が発生した場合に2番目のNameNodeにフェイルオーバーできます。
クラスターのマスターで実行されるSecondaryNameNodeはHA NameNodeサーバーではないことに注意してください。プライマリとセカンダリのNameNodeサーバーは協力して動作するため、セカンダリはフェイルオーバー機構として使用できません。
HAを設定するには、hdfs-site.xmlでdfs.nameservicesとdfs.ha.namenodes.[名前サービスID]を設定し、それらのIPアドレスとポートを指定し、マシン間で共通のフォルダーを共有できるようにNFSディレクトリをマウントします。
CLIを使用して管理コマンドを実行します:
hdfs haadmin
ジョブ履歴MapReduceサーバーはデフォルトではインストールされていません。設定と起動方法は以下に示されています。
    cat /usr/local/hadoop/hadoop-2.7.3//etc/hadoop/mapred-site.xml


mapred.job.tracker
localhost:9001


mapreduce.jobhistory.address
localhost:10020


mapreduce.jobhistory.webapp.address
localhost:19888
次のコマンドでMapReduceジョブ履歴サーバーを起動します:
    $HADOOP_HOME/sbin/mr-jobhistory-daemon.sh --config
$HADOOP_HOME/etc/hadoop start historyserver
starting historyserver, logging to
/usr/local/hadoop/hadoop-2.7.3//logs/mapred-hadoop-historyserver-hp.out
次のようにクエリを実行します:
    curl http://localhost:19888/ws/v1/history/info

{"historyInfo":{"startedOn":1492004745263,"hadoopVersion":"2.7.3","hadoopBuildVersion":"2.7.3 from baa91f7c6bc9cb92be5982de4719c1c8af91ccff by root source checksum 2e4ce5f957ea4db193bce3734ff29ff4","hadoopVersionBuiltOn":"2016-08-18T01:41Z"}}
または、ウェブページにログインしてください。
データノードを追加する
Hadoopを停止せずにデータノードを追加できます。
基本的な手順は、Hadoopユーザーを作成し、パスコードなしでsshキーを構成して、ユーザーが他のサーバーからパスワードを入力せずにsshできるようにすることです。/etc/hostsファイルを更新して、クラスター内のすべてのマシンにホスト名を追加します。それから、マスターの$HADOOP_HOMEディレクトリ全体をzipして同じターゲットマシンの同じディレクトリにコピーします。
次に、新しいデータノードを$HADOOP_HOME/etc/hadoop/slavesに追加します。
次に、新しいデータノードでこのコマンドを実行します:
hadoop-daemon.sh --config $HADOOP_CONF_DIR --script hdfs start datanode
トポロジーを印刷すると、表示されるはずです:
    hdfs dfsadmin -printTopology

192.168.1.83:50010 (hadoop-slave-1)
192.168.1.85:50010 (hadoop-slave-2)
Pig MapReduceジョブを実行する
MapReduceジョブを生成するために実行できるPigスクリプトがありますので、追跡するジョブを持つことができます。(Pigがインストールされていない場合は、https://www.bmc.com/blogs/hadoop-apache-pig/を参照できます。)
まず、このファイルsales.csvを作成します
    Dallas,Jane,20000
Houston,Jim,75000
Houston,Bob,65000
New York,Earl,40000
Dallas,Fred,40000
Dallas,Jane,20000
Houston,Jim,75000
ファイルを自分自身に複数回コピーして非常に大きなファイルを作成することができるので、数分間実行されるジョブを持つことができます。
その後、ローカルファイルシステムからHadoopにコピーします。
hadoop fs -copyFromLocal /data
そこにあることを確認してください:
hadoop fs -cat /user/sales.csv
Pigを実行します。コマンドラインオプションなしで実行されるPigは、クラスター(つまりMapReduce)モードで実行されます。
このスクリプトを貼り付けます:
    a = LOAD '/data/sales.csv' USING PigStorage(',') AS (shop:chararray,employee:chararray,sales:int);

Dump a
Describe a

b = group a by employee;

results = FOREACH b generate SUM(a.sales) as sum, a.employee;
その後、ジョブデータのために異なる画面を確認できます。
一般的なCLIコマンド
| Hadoopを停止して開始します。 |
start_dfs.sh start_yarn.sh
|
| HDFSをフォーマットします。 |
$HADOOP_HOME/bin/hdfs namenode -format
|
| セーフモードを解除します。 |
hadoop dfsadmin -safemode leave
|
| プロセスを一覧表示します。 |
jps
Namenodeのジョブ:
26961 RunJar
28916 SecondaryNameNode
24121 JobHistoryServer
29403 Jps
28687 NameNode
29135 ResourceManager
Datanodeのジョブ;
4231 Jps
3929 DataNode
4077 NodeManager
|
| 破損したデータブロック。欠損ブロックを見つけます。 |
hdfs fsck /
|
ノードマネージャーの健康状態を監視する
yarn.nodemanager.health-checker.script.path
|
スクリプトのパスとファイル名。 |
yarn.nodemanager.health-checker.script.opts
|
コマンドラインオプション。 |
コマンドラインオプション。
|
実行頻度 |
checker.script.interval-ms
|
|
checker.script.interval-ms
|
タイムアウト。 |
その他の一般的な管理タスク
| ログ集約を設定します。 |
| ラック認識を構成します。 |
| データノード間の負荷分散を構成します。 |
| 新しいバージョンにアップグレードします。 |
| キャッシュ管理用にcacheadminを使用します。 |
| スナップショットを取得します。 |
| ユーザー権限とアクセスコントロールを設定します。 |
一般的な問題
localhostをHadoopファイルシステムのURLとして使用することは推奨されません。これにより、マシンのルータブルIPアドレスの代わりに127.0.0.1にバインドされることになります。その後、Pigで次のエラーが表示されます:
pig java.net.connectexception connection refused localhost:9000
したがって、etc/hadoop/core-site.xmlでバインドIPアドレスを0.0.0.0に設定します:
    fs.defaultFS
hdfs://0.0.0.0:9000/
WebAppProxyサーバー
WebAppProxyサーバーを設定することはセキュリティの問題です。マスターとスレーブの間にプロキシサーバーを設定するために使用できます。これは、ユーザーがハッキングのためにYarn URLを使用するのを防ぎます。Yarnユーザーは特権が高いため、リスクがあります。誰かがアクセスすると警告が表示され、攻撃に使用される可能性のあるクッキーが削除されます。
ここからどう進むか
ユーザーは、ドキュメント内で言及されているトピックをさらに読み、特に「その他の一般的な管理タスク」セクションに目を通すことをお勧めします。そこでは、調整とメンテナンスツールおよび問題が見つかる可能性があり、これらはプロダクションシステムを維持し、関連する問題を修正する際に必ず発生することになります。
Hadoopガイド
- 初心者のためのHadoopチュートリアル: Hadoopの基本
- Hadoop管理への紹介
- Hadoopセキュリティの紹介
- Apache Flumeの紹介
- Hiveへの紹介
- HDFSへの紹介
- Hbaseの紹介
- Hadoopの例: 5つの実世界のユースケース
- Hadoopキャリア: 雇われるために
- Hadoop面接質問
- Hadoop分析への紹介
- Apache Pigの紹介
- Apache Yarnへの紹介
- Hadoopアーキテクチャへの紹介
- Hadoopの利点と利点
- Apache CassandraとのHadoopの使用
- HadoopとKubernetes: K8sとクラウドネイティブはHadoopを終わらせるのか?
- Hadoop認定
- Hadoopクラスター: 入門
- Hadoopエコシステムとコンポーネント
これらの投稿は私自身の見解であり、BMCの立場、戦略、または意見を必ずしも表すものではありません。