




ポイント: グラフデータベースは相互接続されたデータを効率的に管理し、迅速な関係のクエリを可能にし、不正検知やリアルタイム推奨のようなアプリケーションに理想的です。ノードとエッジを使用してデータ接続を表現します。
- グラフデータベースはデータ関係の探索に優れています。
- 人気のあるグラフデータベースのオプションにはNeo4jやAmazon Neptuneが含まれます。
データはテクノロジーの世界を支配しています。データ、データ、データ。ユーザーが見る必要があるデータ、データサイエンティストがレビューするデータ。投資家のためのデータ。管理のためのデータ。データ。どの組織にとっても、データを構造化し保存する方法が成功の可能性を決定します。
手書きのMicrosoft Word文書にデータを保存している会社は、クラウドサーバー上の読みやすいExcelチャートにデータを保存している会社に比べて、一歩後れを取っています。データベースの世界では革新が続いており、これがグラフデータベースです。
従来のデータベースの動作
データは伝統的にテーブルに保存されてきました。コーヒーショップ業界では、次のようなテーブルのセットが表示されるかもしれません:
グラフ
| コーヒーショップ |
|---|
| 名前 |
| NOVO |
| スチーム |
| サムプ |
| コルヴス |
顧客
| 顧客ID | 名前 | 誕生日 | メール | 電話 |
|---|---|---|---|---|
| 123461 | ジャック | 1970-01-01 | a@b | 1 |
| 41263 | ジム | 1970-01-01 | b@c | 2 |
| 45714 | ジル | 1970-01-01 | c@d | 3 |
| 71129 | ジェローム | 1970-01-01 | d@e | 4 |
| 90123 | Jeb | 1-1-1970 | e@f | 5 |
次に、すべての注文、従業員、在庫、サプライヤーを保存するための別々のテーブルがあります。コーヒーショップ業界のデータを保存するために6つのデータテーブルがあります。従来のリレーショナルデータベースでは、知られたい新しい関係ごとに情報を保存するための新しいテーブルが必要です。
在庫アイテムはテーブルでうまく機能するかもしれませんが、エンティティ間の関係を表現するには限界があります。
従来のデータベースでは、関係の質問に答えるには、テーブル間でIDを二重入力する必要があり、次に、すべてのテーブルセットで「ID-1が他のID-1と一致するすべての値を返す」と言うためのいくつかの結合文が必要です。次に、ID-1を持つテーブルで表示される他の共通のIDも確認し、すべてのテーブルセットでそれらのIDを見つけます。
コーネル映画ダイアログコーパスは従来のデータベースです。誰がどの映画で何を言ったかを知るためには、映画のセリフとIDをクロスリファレンスする必要があります。例えば、「君を見つめることに乾杯」とは、キャラクターID546(ハンフリー・ボガート)によって話されたもので、映画ID123(カサブランカ)です。
リレーショナルデータベースで関係の質問に答えることは可能ですが、探求するテーブルセットを明示的に示すよく考えられた質問を通じてのみ行えます(膨大な作業)。その後、クエリが返されるまで待ちます。
非グラフデータベースにおける関係に関するクエリはうまくスケールしません。リレーショナルデータベースでの関係の質問は数分かかることがありますが、グラフデータベースでの同じクエリは数秒で処理できます。
グラフデータベースとは?
人々がますます相互接続された社会に移行するにつれて、接続を表現する必要があります。友人の友人を示すソーシャルメディアフィードから、これらの曲やビデオを好む人々が他にどの曲やビデオを好むかを示す推奨リスト、そしてグループの中で最も脅威になりそうな不正メンバーを特定することまで、グラフデータベースはこの情報を保存し、簡単にクエリを実行するのに役立ちます。
グラフデータベースは、高度に相互接続されたデータを理解するために使用されます。データ間の関係を探索するのに優れています。設計上、グラフデータベースはこれらのタイプの質問に簡単に答えることができます:
- ユーザーの友人はユーザーと同じ音楽が好きですか?
- この不正なユーザーは、グループの他のメンバーとの関係が少ないために検出される可能性があるのでしょうか?
- この人がこれらのことを知っている場合、他の種類のことを学ぶために点をつなぐ可能性はどれくらいですか?
ユースケース
グラフデータベースはスキーマレスで可変です。グラフデータベースは、次のような場合に特に優れています:
- データ間の関係を探索する
- 増加する関係の量に応じてクエリを簡単にスケールする
グラフデータベースのユースケースには、次のようなものがあります:
- 不正検知
- リアルタイム推奨
- データ管理
- アイデンティティ管理
- ネットワークおよびIT運用
3つのグラフコンポーネント
グラフの概念は数学用語であり、グラフ理論に由来します。グラフ理論のグラフは、木、ネットワーク、ウェブ、またはマインドマップと考えることができます。あなたの悪魔を選んでください。それらはすべて同じ部分で構成されています:
- ノード
- エッジ
- グラフ
ノード
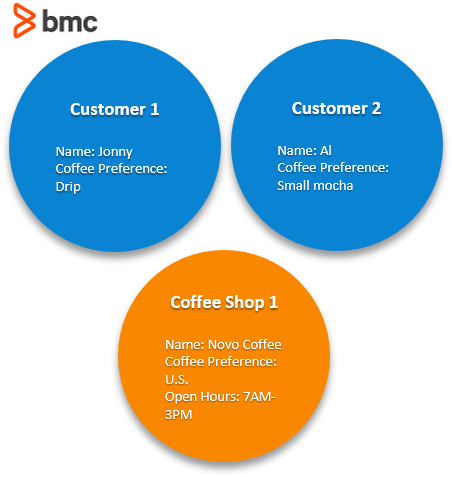
グラフの基本要素はノードです。これらはグラフ上の各点です:
- 1つのノードには顧客名と顧客のコーヒーの選択が含まれています。
- 同じグラフの別のノードにはコーヒーショップの名前、住所、営業時間が含まれています。
エッジ
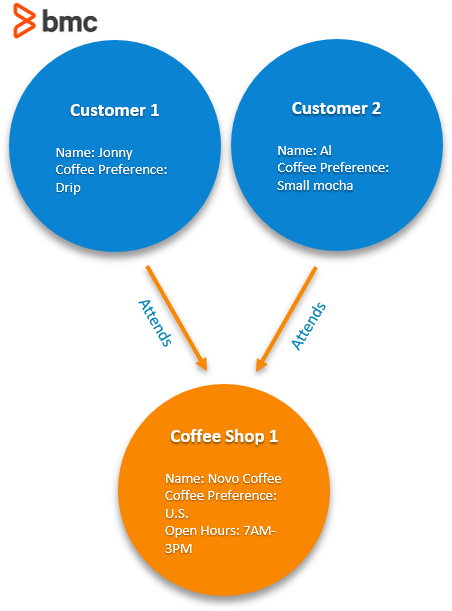
グラフ上のエッジは、エンティティ間の関係を定義します。上記の2人の顧客について言えば、彼らは両方ともコーヒーショップに「通っている」と言えます。名称は、あなたの組織やニーズに基づいて異なる可能性があります。例えば、「通う」は顧客、買い物客、パトロン、ユーザーなどに置き換えることができます。
最後に、ノードとエッジのグラフがあります。これから、例えば「顧客1と顧客2は両方ともコーヒーショップ1に通っている」や「顧客1だけがコーヒーショップ2に通っている」といった関係を表現できます。
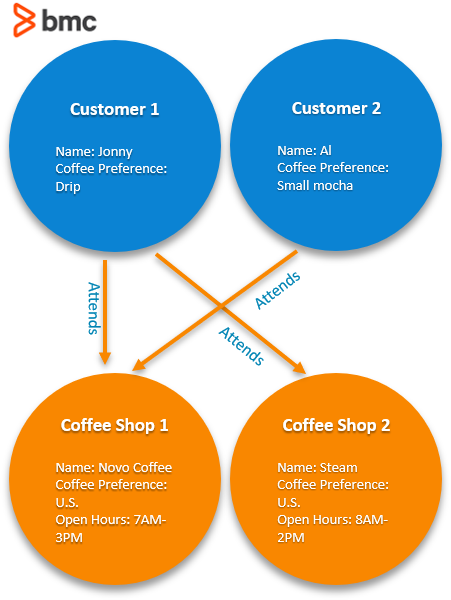
このグラフにさらに多くの関係を追加することができます。このチャート内で:
- 各コーヒーショップのサプライヤーを示すことができます。
- これら2人の顧客の家族や友人を追加し、ネットワークに「家族」、「兄弟」、「友人」というエッジを作成し、彼らのコーヒーの好みを示し、さらに「通う」エッジを使ってどのショップに通っているかを表現できます。
これらのグラフは非常に複雑になる可能性があります。
クラウドプロバイダーの人気グラフツール
Neo4jはグラフの世界で最も大きなプレーヤーの一つであり、Kubernetesインフラストラクチャを作成しており、任意のクラウドサービスでグラフデータベースを実装できます。これにより、グラフデータベースをAWS、Azure、およびGCPで実装できます。
Neo4jは稼働させるのに少し余分な作業が必要ですが、AWSはAWS上で即座に利用できるグラフインフラストラクチャを提供します。別の良いグラフの代替はCayleyで、これはオープンソースでGCPで使用できます。
他にどのような良いグラフオプションに出会いましたか?ぜひご連絡ください。
追加リソース
関連する読書のために、以下のリソースを探索してください:
- BMCビッグデータ&機械学習ブログ
- データビジュアライゼーションガイド、チュートリアルシリーズ
- Tableauオンラインガイド、チュートリアルシリーズ
- データレイクとデータウェアハウスとデータベースの違いを説明
- DBMS:データベース管理システムの紹介

データビジュアライゼーションガイド
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。