




ポイント: Google Cloud TPUは、TensorFlowでの効率的なテンソル操作のために特化したテンソル処理ユニットを活用することで機械学習を強化します。1時間あたり4.50ドルの料金で、展開のためのユニークなコマンドラインツールを提供し、最適化されたASICハードウェアを使用して複数のマシン間でのスケーリングを容易にします。
- TPUは、パフォーマンス向上のためにASICハードウェアを利用します。
- 異なるマシン間でシームレスにスケーリングをサポートします。
私たちはすでにNVIDIA GPU(グラフィカルプロセッシングユニット)を使用して機械学習フレームワークが機械学習を加速させている方法について書きました。今、Googleはそのアイデアを取り入れ、自社のASICハードウェアであるTPU、テンソル処理ユニットを使用して機械学習を加速させています。Googleが実際に行ったことは、NVIDIA(GPU)によって発明された技術を取り入れ、それをクラウドに移行したことです。
テンソルはn次元行列です。これは、Google Brainによって立ち上げられたオープンソースの機械学習フレームワークであるTensorFlowにおける基本的な操作単位です。
テンソルはnumpy配列に類似しており、実際にNumpyを使用します。彼らのドキュメントによると、「NumPyはPythonによる科学計算のための基本的なパッケージです。その他のことの中には、強力なN次元配列オブジェクトが含まれています…」
配列は機械学習アルゴリズムで使用される基本的なデータ構造です。配列からの乗算やスライスを行うことは、多くのCPUクロックサイクルとメモリを必要とします。そのため、Numpyはそれを行うためのコードを書くことを容易にするために書かれました。GPUは現在、これらの操作をより速く実行します。
[helix-video]
特に、MLに関わる数学はこれらのオブジェクトの加算と乗算を含みます:
GPUは元々、画面上のグラフィックスを回転させるために必要な集中的な数学計算をオフロードし、ゲームアプリケーションで画面を描画するなどのあらゆる種類のグラフィカル操作を加速するために構築されました。目的はCPUに過剰な負担をかけないことでした。しかし、その後NVIDIAはCUDA SDKを書き、Tensorflowのようなものを書くプログラマーがスカラー、ベクトル、または行列の加算や乗算にGPUを使用できるようにしました。
CPUは1から8コア以上を持っています。GPUは数百あります。GPUとTPUは同じ技術です。唯一の違いは、今や独自のGPUチップを使用してクラウドサービスとして販売されているということです。
ハードウェア
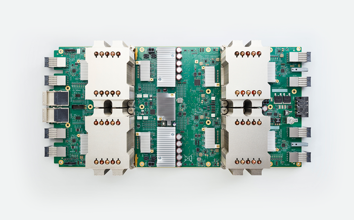
GoogleのTPUのプロビジョニング方法はAmazonとは異なります。AmazonではGPU対応のテンプレートを選択し、それを使用して仮想マシンを立ち上げます。それらのテンプレートはすべてP3の文字で始まり、ここにリストされています。
Googleでは、コマンドラインツールcptuを使用してTPUを持つマシンを提供します。(また、NVIDIA GPUも引き続き使用できます。)
Googleの料金情報によると、各TPUの料金は1時間あたり4.50ドルです。彼らは、ウェブサイトで3つのモデルを示しているにもかかわらず、異なるTPUモデルに対して異なる料金を請求していないようです。それは混乱を招くようです。なぜなら、TPUは異なるメモリサイズとクロックスピードを持っているからです。したがって、1つは別のものよりも高価であるべきです。
TPUの作業負荷は、彼らがTPU Cloud Serverと呼ぶものに分散されます。以下に示します。
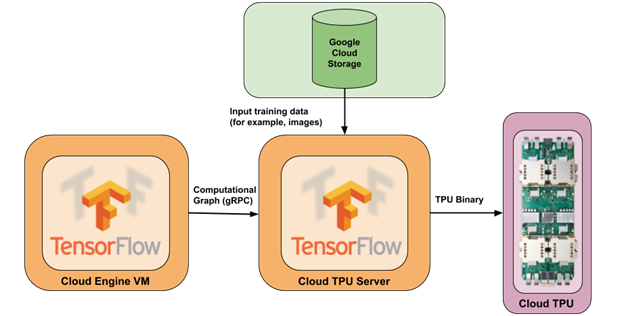
彼らのアーキテクチャドキュメントによると、彼らのTPUはPCIインターフェースを介してクラウドマシンに接続されています。それはNVIDIAがゲーマーにグラフィカル拡張カードを追加してコンピュータのグラフィックスのパフォーマンスを向上させることを許可したのと同じ方法です。したがって、彼らは単なるオンボードチップではなく、拡張カードです。
Googleは「各チップはテンソルコアと呼ばれる2つの計算コアで構成されています。テンソルコアはスカラー、ベクトル、行列ユニット(MXU)で構成されています。さらに、16GBのオンチップメモリ(HBM)が各テンソルコアに関連付けられています。」と述べています。
ソフトウェア
エスティメーターはtf.estimator.Estimatorクラスです。これらは、ニューラルネットワーク、線形回帰、およびPythonコードを使用してこれらの種類のオブジェクトを作成するための他のオブジェクトの実装です。それらはNumpy、Pandas、その他のPythonデータ構造やユーティリティを活用しているため、これらの種類のオブジェクトを作成するのが簡単です。
現在、GoogleはTPUエスティメーターを持っていると言っています。通常のTensorFlowと異なり、CおよびC++で書かれたその部分のコードに対してCUDA SDKを使用するGPU対応バージョンのTensorFlowをダウンロードして使用することはできません。TPU対応のTensorFlowの別のバージョンはありません。そして、GPUとは異なり、コードにTPUデバイスを明示的に使用するように指示する方法はないようです。例えば、GPUデバイスを使用して2つの行列を乗算するこのコードスニペットで/device:GPU:n.を使用します。(CPUを使用するには/device:CPU:n,と書くことができます。ここでnはコンピュータ上のn個のCPUのいずれかです。)
    with tf.device('/device:GPU:0'):
   c = tf.matmul(x, y)
スケールの利点?
TPUデザインの一つの利点は、TPUサーバーを介して異なるマシンにわたって操作をスケールさせることを可能にすることです。もちろん、ユーザーはそれを行うためにコードを書く必要はありません。この研究者は、GPUでそれを実行する方法をまだ研究していません。言い換えれば、計算がメモリ不足になった場合に何をしますか?PCI拡張カードを追加することができます'/device:GPU:1, 2, …., nまたは、Amazonに支払ってより大きなテンプレートを取得することによって効果的に同じことを行います。しかし、デバイスやサーバー名をハードコーディングせずにサーバークラスター全体にスケールさせるためのMesosの同等のものを実装する方法はどうでしょうか?それを調査し、あなたにお知らせします。
TensorFlowとKerasによるMLガイド
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも代表するものではありません。