




ポイント: Kerasを使用して収入や教育などの特徴に基づいて製品購入を予測するためのニューラルネットワークを構築するチュートリアルです。データ準備、正規化、モデル作成、トレーニング、および評価を含み、93.78%の精度を達成します。
- 顧客の購入可能性を予測することに焦点を当てています。
- ソースコードとデータ処理手順を含みます。
この記事では、Kerasを使用してニューラルネットワークを作成する方法を示します。これは元のブログ記事の拡張です。目的は、収入、住宅の所有、大学教育の有無などに基づいて、特定の製品を購入する可能性を予測することです。このZeppelinノートブックのソースコードはこちらです。最初に、インターネットからデータをダウンロードします。特徴データはすでにカテゴリカル(0と1)であるため、変換の必要はありません。ラベル列はdata['Buy']です。data.iloc[:,2:16]は、2列目から16列目までのすべての行を取得します。ここでilocはインデックス検索演算子です。コロン(:)はすべてを意味します。
    import tensorflow as tf
from keras.models import Sequential
import pandas as pd
from keras.layers import Dense

url = 'https://raw.githubusercontent.com/werowe/logisticRegressionBestModel/master/KidCreative.csv'

data = pd.read_csv(url, delimiter=',')

labels=data['Buy']
features = data.iloc[:,2:16]
次に、データを33%と66%のトレーニングおよびテストデータセットに分割します。これは機械学習の標準的な慣行です:入力データを取得して分割し、1つのセットを使用してモデルをトレーニングします。その後、別のセットを使用して精度を確認します。np.ravel(labels)は、Pandasシリーズlabelsから配列を作成します。
    import numpy as np
from sklearn.model_selection import train_test_split

X=features

y=np.ravel(labels)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=42)
ここでデータを正規化します。これは、共通のスケールに配置することを意味します(値 - 平均 / 標準偏差)、機械学習データの慣行です。
    from sklearn.preprocessing import StandardScaler

scaler = StandardScaler().fit(X_train)

X_train = scaler.transform(X_train)

X_test = scaler.transform(X_test)
ここでは、3層のニューラルネットワークを作成します。入力の形状は(14,1)であり、データPandasデータフレームには14の特徴列があります。損失関数にはbinary_crossentropyを使用し、最適化には確率的勾配降下法を使用します。また、さまざまな活性化関数を使用します。どれを選ぶかは任意です。1つを選び、別のものを試し、別のものを選んで、最も正確なモデルを作成します。層の数とエポックの数は完全に任意です。これらを増やすことでモデルの精度を向上させることができるかもしれませんが、このモデルはほんの数ステップで収束するため、どんな変動もわずかです。
    model = Sequential()

model.add(Dense(8, activation='relu', input_shape=(14,)))

model.add(Dense(8, activation='relu'))

model.add(Dense(1, activation='sigmoid'))


model.compile(loss='binary_crossentropy',
              optimizer='sgd',
              metrics=['accuracy'])

model.fit(X_train, y_train,epochs=8, batch_size=1, verbose=1)
    Epoch 1/8
450/450 [==============================] - 2s 5ms/step - loss: 0.4760 - acc: 0.7844
Epoch 2/8
450/450 [==============================] - 1s 1ms/step - loss: 0.3338 - acc: 0.8511
Epoch 3/8
450/450 [==============================] - 1s 1ms/step - loss: 0.2521 - acc: 0.9000
Epoch 4/8
450/450 [==============================] - 1s 1ms/step - loss: 0.2058 - acc: 0.9156
Epoch 5/8
450/450 [==============================] - 1s 2ms/step - loss: 0.1829 - acc: 0.9311
Epoch 6/8
450/450 [==============================] - 1s 1ms/step - loss: 0.1740 - acc: 0.9311
Epoch 7/8
450/450 [==============================] - 1s 2ms/step - loss: 0.1630 - acc: 0.9311
Epoch 8/8
450/450 [==============================] - 1s 1ms/step - loss: 0.1583 - acc: 0.9378
ここでは、evaluate()メソッドを使用してモデルの精度を示します。これは、比率(正しい予測の数)/(予測の数)を意味します。y_predとy_testを横並びで表示して、ほとんどの予測がテスト値と同じであることがわかります。これは予想通りであり、このモデルの精度は93.78%です。
    y_pred = model.predict(X_test)

score = model.evaluate(X_test, y_test,verbose=1)

print(score)
    223/223 [==============================] - 1s 3ms/step
[0.18696444257759728, 0.9372197314762748]
データの相関
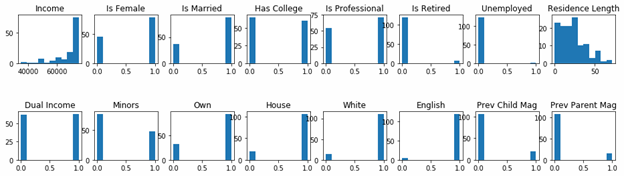
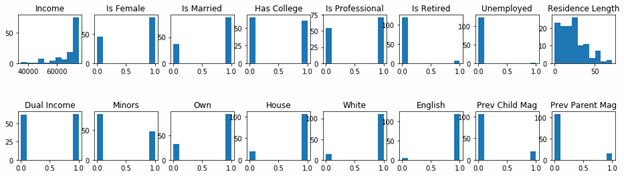
機械学習において必要なステップは、データが相関しているかどうかを確認するためにプロットすることです。データを購入者と非購入者に分けて、特徴をヒストグラムにプロットします。すべてのヒストグラムを重ねて表示します。
購入者
収入、教育レベル、現在の/過去の住宅所有など、特定の条件を持つ人々が購入するかどうかを予測することを明らかに信じています。dfは、元のデータフレームdata.columnsのすべての列を持つ新しいデータフレームです。それを作成し、df.loc[(df.Buy == 1)]演算子を使用して購入した人々を選択します。df.locは、行の値に基づいて列を選択します。fig, ax = plt.subplots(2,8,figsize=(16, 4) )は、8つのチャートを持つ2行の図を作成することを意味します。したがって、各チャートはax[row,column]によって参照されます。fig.subplots_adjust(hspace=1, wspace=0.2)は、間隔の幅と横のスペースを持つことを提供します。buyers.columns[2:]は、データフレームの3列目から最後の列を取得することを意味します。観察番号、購入または非購入、収入列の履歴をプロットする必要はありません。
    df = pd.DataFrame(data, columns= np.array(data.columns))

buyers = df.loc[(df.Buy == 1)]

import matplotlib.pyplot as plt


fig, ax = plt.subplots(2,8,figsize=(16, 4) )

i = 0
j = 0

for c in buyers.columns[2:]:
    ax[j,i].hist(buyers[c])
    ax[j,i].set_title(c)
    i = i + 1
    if i == 8:
        j = 1
        i = 0

fig.subplots_adjust(hspace=1, wspace=0.2)
plt.show()
ご覧のように、高収入で専門職に就いている人々、仕事を持っている人々、二重収入の人々、住宅を所有している人々は、購入した可能性が最も高いです。
非購入者
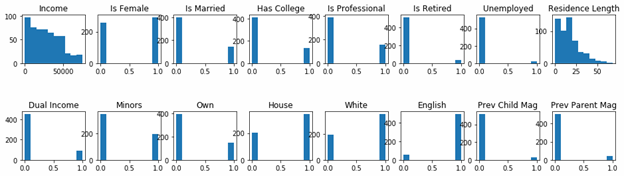
今度は逆に、何も購入しなかった人々を選びます。
    df = pd.DataFrame(data, columns = data.columns )

notbuyers = df.loc[(df.Buy == 0)]

import matplotlib.pyplot as plt


fig, ax = plt.subplots(2,8,figsize=(16, 4) )

i = 0
j = 0

for c in np.array(data.columns)[2:]:
    ax[j,i].hist(notbuyers[c])
    ax[j,i].set_title(c)
    i = i + 1
    if i == 8:
        j = 1
        i = 0

fig.subplots_adjust(hspace=1, wspace=0.2)
plt.show()
ヒストグラムの比較
購入者と非購入者の違いを簡単に確認することができ、両方のチャートを以下に示します。
購入者のヒストグラム
非購入者のヒストグラム
TensorFlowとKerasのガイド
これらの投稿は私自身の意見であり、BMCの立場、戦略、または意見を必ずしも代表するものではありません。