




ポイント: ストリーミングデータアーキテクチャは、高ボリュームデータのリアルタイム処理を促進し、意思決定と運用効率を向上させます。Apache KafkaやAWS Kinesisなどの主要技術が、効果的なデータ取り込みと処理を実現します。
- ストリーミングデータは、ビジネスイベントへの迅速な対応を可能にします。
- リアルタイム分析は、顧客体験とリスク管理を改善します。
データストリーミングとは、データがソースから宛先に継続的に流れることであり、ほぼリアルタイムで処理および分析されます。
データストリーミングとは?
企業は、異なる宛先に配信される数千のデータソースを持つことがあります。データはストリーム処理技術を使用して処理でき、一般的には小さなデータの塊で構成されます。ストリーミングデータは、データの断片をリアルタイムまたはほぼリアルタイムで処理できるようにします。データストリーミングの最も一般的な2つのユースケースは:
- ストリーミングメディア、特にビデオ
- リアルタイム分析
データストリーミングは、メディアストリーミングや株式市場の金融価値など、非常に特定のビジネスに限定されていました。今日では、すべての企業で採用されています。データストリームは、組織がリアルタイムでデータを処理することを可能にし、企業にそのビジネスのすべての側面を監視する能力を与えます。監視のリアルタイム性により、経営陣は危機的なイベントに迅速に反応し、対応できるようになります。他のデータ処理方法よりもはるかに迅速に反応します。データストリームは、企業のすべての動く部分と意思決定を行う人々との間の継続的なコミュニケーションチャネルを提供します。

ストリーミングメディア
メディアストリーミングはその一例です。これにより、全体のビデオをダウンロードせずに、ビデオの視聴を開始できます。これにより、ユーザーはデータ(ビデオ)をより早く視聴でき、メディアストリーミングの場合、ユーザーのデバイスが一度に大きなファイルを保存する必要がなくなります。データは処理され視聴される際にデバイスから出入りできます。
リアルタイム分析
データストリームは、企業がリアルタイム分析を使用してその活動を監視することを可能にします。生成されたデータは、何が起こっているかを報告するために、時間系列データ分析技術を通じて処理できます。モノのインターネット(IoT)は、ストリーミング可能なデータの多様性と量の急増を促進しました。ネットワーク速度の向上はデータの速度に寄与します。したがって、私たちはデータ分析とデータストリームの広く受け入れられている3つのVを得ます:
- 多様性
- ボリューム
- 速度
IoTと組み合わせることで、企業は多くの異なるセンサーやモニターからデータストリームを得ることができ、リアルタイムで多くの動的変数をマイクロ管理する能力が向上します。カオス工学の観点から、リアルタイム分析は素晴らしいものであり、企業の活動を監視する能力を高めます。したがって、設備が故障したり、読み取りが迅速な対応を必要とする情報を返したりする場合、企業は行動を起こすための情報を持っています。データストリームは、企業の回復力を直接高めます。
ストリーミングデータの利点
組織は、従来のバッチ処理を待つのではなく、データをストリーミングできると利点を享受します。リアルタイムでの情報の途切れのない流れを得ることで、より迅速な意思決定が可能になります。反応する代わりに、経営者はトレンド、顧客の需要、運用の不規則性を先取りできます。データをプロセスにストリーミングすることで、組織はより敏捷で、回復力があり、革新的になります。ストリーミングデータの利点には以下が含まれます:
- リアルタイムの洞察:バッチプロセスを待つ必要はありません。データをすぐに使用して、時間に敏感な意思決定を行うことができます。詐欺を即座に検出し、消費者のトレンドに飛びつき、品質の問題をより大きな問題に発展する前に見つけることができます。
- 運用効率の向上:リアルタイムで継続的なデータを分析できるため、ワークフロー内の遅延、プロセスの非効率性、および弱いリンクを見つけやすくなります。生産性を向上させ、コストを削減するだけでなく、問題やダウンタイムを防ぐこともできます。
- 予測分析:ストリーミングデータを予測モデルに取り入れることで、先を見越して意思決定を行う能力が強化されます。たとえば、需要を予測して在庫を最適化したり、設備を監視して故障を防ぐことができます。
- パーソナライズされた顧客体験:リアルタイムで顧客行動を分析する能力は、製品推奨を促進し、関連するプロモーションを提供し、忠誠心を高める方法で関与するための洞察を提供します。
- リスク管理の向上:ライブデータは、発生する可能性のある詐欺を示す異常なトレンドやパターンを検出することを可能にします。サプライチェーンの混乱を示す異常を検出できる場合もあり、調整する時間を与えます。
- 機敏性と応答性の向上:ストリーミングデータは、進化する現実に応じて迅速かつ正確に変更を加えるようチームを促します。リアルタイムデータを持つことで、正しい新たな方向に進むことができます。
- 会社全体の共有された視点:すべての部門が何が起こっているかをリアルタイムで見ることができると、データ駆動の戦略や対応を調整しやすくなります。誰もITがレポートを生成するのを待ったり、ある部門がデータサイロの中で動作していることを心配したりする必要はありません。
ストリーミングデータのためのデータアーキテクチャ
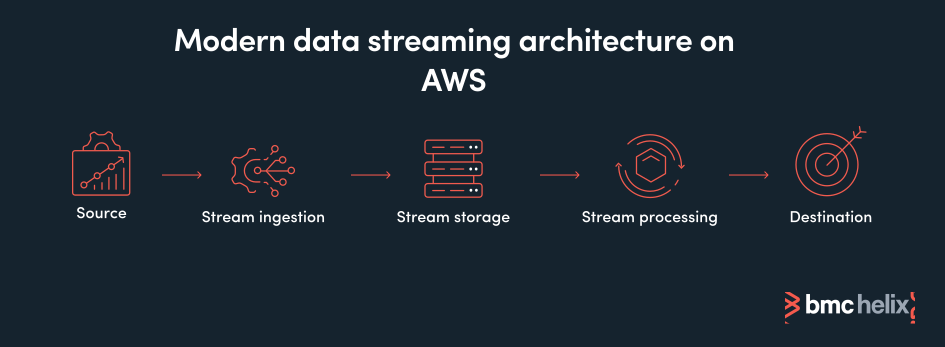
ストリーミングデータアーキテクチャは、IoTデバイス、トランザクションシステム、ソーシャルメディア、アプリケーションログなど、複数のソースからリアルタイムデータを取り込み、使用するためのシステムを作成します。ストリーミングデータアーキテクチャは、リアルタイム処理と分析をサポートし、ユーザーはバッチ処理を待つことなく必要な情報を得ることができます。成功したストリーミングデータアーキテクチャは、そのコンポーネントが効率的に連携して機能することを保証します。それは、高速で高ボリュームのデータを遅延や障害なしに処理できるようにスケールする必要があります。パフォーマンスと信頼性のための現在のベストプラクティスには、モジュール設計、分散コンピューティング、およびイベント駆動処理が含まれます。主要なコンポーネントは次のとおりです:
- データ取り込みレイヤー:このコンポーネントは、Apache Kafka、AWS Kinesis、RabbitMQなどのツールを使用してリアルタイムでデータをキャプチャします。これらは、センサー、アプリケーション、およびサービスからの高速度・高ボリュームのデータを処理し、高スループットと低レイテンシを実現します。
- 処理レイヤー:処理は、データ取り込みコンポーネントのボリュームと速度に一致し、イベントを処理し、パターンを検出し、ビジネスルールを適用し、即時のアクションをサポートする必要があります。現在の適合するストリーム処理フレームワークには、Apache FlinkおよびApache Spark Streamingが含まれます。
- ストレージレイヤー:ストリーミングデータがどのように保存されるかは、リアルタイム分析を促進するだけでなく、将来の分析にも利用できることを保証します。InfluxDBのような時間系列ストレージソリューションや、CassandraやMongoDBなどのNoSQLデータベースは、迅速な読み取りと書き込みのために最適化でき、将来の取得やクエリのためにデータを迅速にアクセス可能にします。
- データ出力レイヤー:このコンポーネントは、処理されたデータがリアルタイム報告ツール、データビジュアライゼーションダッシュボード、およびその他のダウンストリームアプリケーションに供給できるようにします。これは、機敏性と応答性を定義する即時かつ正確な意思決定をサポートします。
データストリーミングの課題
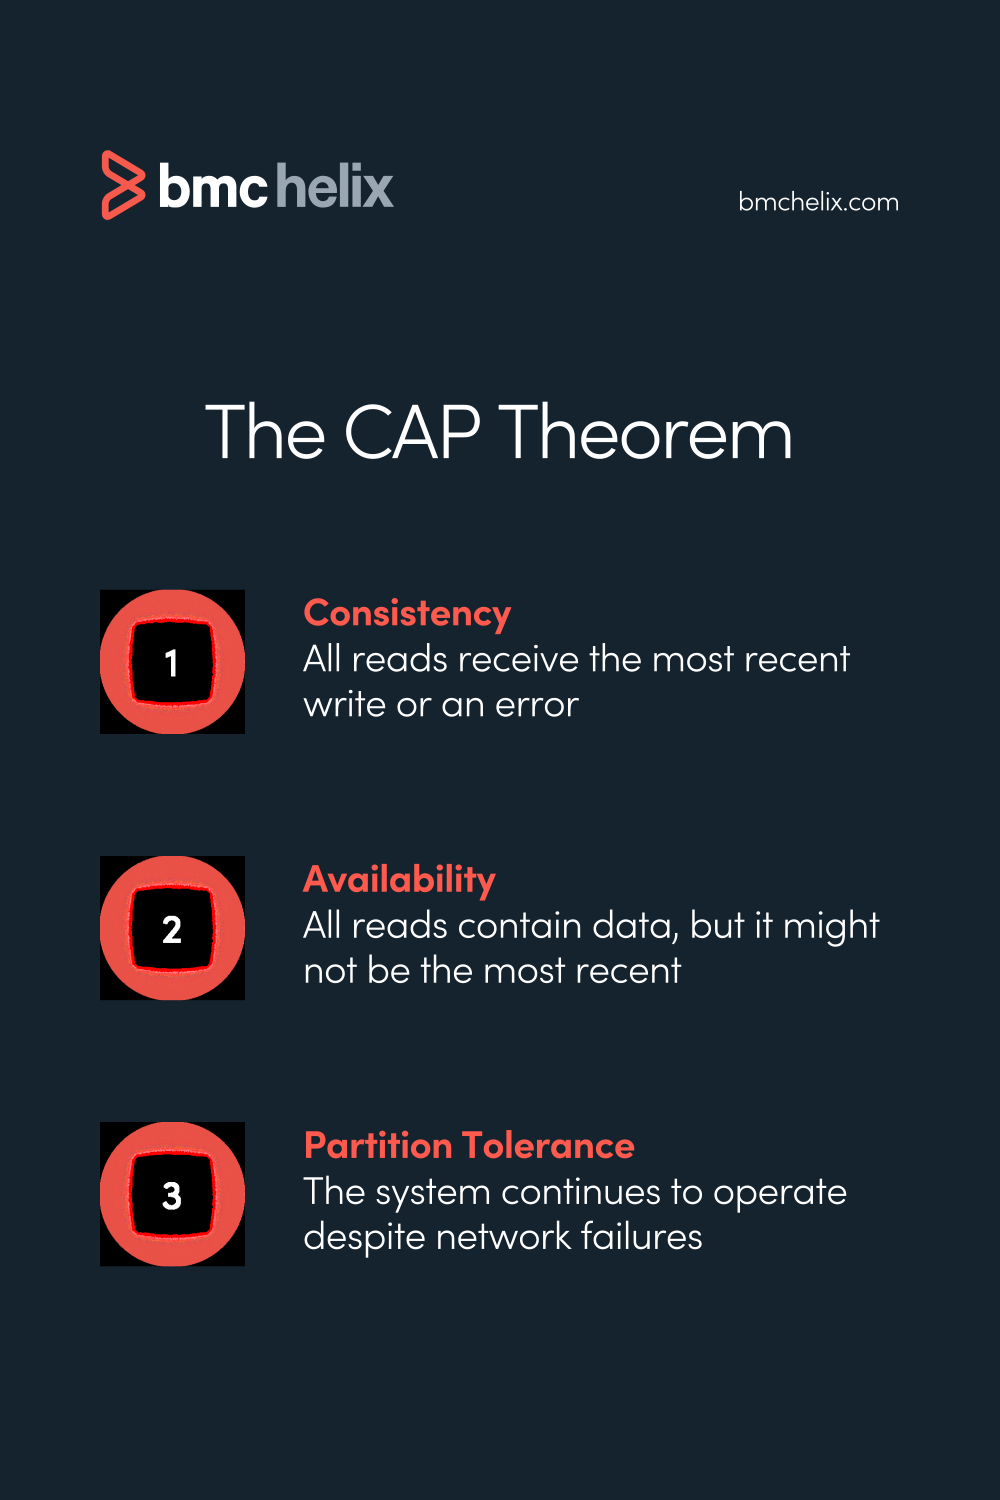
データストリームは、情報を取得するためにクエリできる継続的なデータのストリームを提供します。一般的に、データは順序通りである必要があり、これがストリームを持つ理由の1つであることがあります。(結局のところ、メッセージングアプリはすべてのメッセージを順番に持つ必要があります。)データは異なるソースから、あるいは同じソースからでも来る可能性がありますが、分散システムを通じて移動するため、ストリームはデータの順序を保ち、消費者に届けるという課題に直面します。したがって、データストリームは、その構築においてCAP定理問題に直接直面します。データベースや特定のストリーミングオプションを選択する際、データアーキテクトは次の2つの価値を決定する必要があります:
- 一貫したデータを持つこと、すべての読み取りが最新の書き込みを受け取り、そうでない場合はエラーを返す。
- 高可用性データを持つこと、すべての読み取りがデータを含むが、最新ではないかもしれない。
データストリーミング技術
高ボリューム、高速度データを処理するように構築されたストリーミングデータアーキテクチャは、データを処理し、洞察を得て、情報に基づいてアクションを取ることを可能にします。クラウドベースでモジュール化されたデータストリーミング技術は、スケーラビリティ、障害耐性、最小レイテンシを含むリアルタイムデータ処理の基本原則をサポートします。すでにクラウド環境に慣れているチームは、Amazon Web Services(AWS)、Microsoft Azure、Google Cloud Platform(GCP)からのストリーミングアーキテクチャの各レイヤーをカバーする堅牢なツール群にアクセスできます。学習曲線が平坦化されると、クラウドの専門知識を持つチームは、組織のニーズを最もよくサポートするようにアーキテクチャをカスタマイズし、最適化することに集中できます。ストリーミングデータアーキテクチャを構築する最初のステップは、データ取り込みレイヤーまたはストリームプロセッサを設定することです。多様で分散したデータソースを高スループットで低レイテンシで処理するための一般的なツールには、
- Amazon MSK
- Amazon Kinesis
- Apache Kafka
- Google Pub/Sub
次のステップは、オンザフライのデータ変換、集約、フィルタリングを実行するストリーム処理および分析レイヤーを選択し、構成することです。また、ビジネスロジックを適用し、クエリを実行し、異常を検出し、トレンドを追跡し、アラートをトリガーし、リアルタイムでデータをアクション可能にする必要があります。次のようなツールを使用できます:
- Amazon Kinesis Data Analytics
- Google Dataflow
- Google BigQuery
第三に、分析されたデータを意思決定者に役立つ形で提供する必要があります。通常、ダッシュボード、アラートシステム、またはデータを視覚化し、洞察を得る能力をチームに提供する運用アプリケーションを使用します。データの宛先をカスタマイズするか、Amazon QuickSightやLookerのようなツールを使用できます。最後に、ストリーミングデータをどこかに保存する必要があります。ストレージコストは安価であるため、一般的な慣行はすべてを保持することです。データストレージに関しては、一般的な信念は、現在は役に立たない場合でも、後で役に立つ可能性があるということです。ストリーミングデータを保存する際の良いオプションは次のとおりです:
- Amazon Redshift
- Kafka
- Amazon S3
- Google Storage
人気のストリーミングデータ技術
堅牢でスケーラブルなリアルタイム分析を支えるデータストリーミング技術のリストが増えています:
- Apache Kafka:この分散イベントストリーミングプラットフォームは、高スループットで障害耐性のあるデータ取り込みを提供します。Kafkaの強みは、イベント駆動アプリケーションのための大規模データボリュームの処理です。
- AWS Kinesis:この完全に管理されたクラウドサービスは、データの収集、処理、分析のためのエンドツーエンドのストリーミング機能を提供するKinesis Data Streams、Firehose、Data Analyticsなどのコンポーネントを提供します。
- Apache Flink:この高性能ストリーム処理フレームワークは、低レイテンシで無限および有限のデータストリームの両方を処理します。
- Apache Spark Streaming:Apache Sparkエコシステムの一部として、このコンポーネントはスケーラブルで高スループット、障害耐性のあるデータストリーム処理をサポートします。バッチ処理を含むハイブリッドアーキテクチャをサポートする柔軟な選択肢です。
- RabbitMQ:このメッセージブローカーは、サービス間のリアルタイム通信をサポートするためにメッセージキューイングを使用し、信頼できるメッセージ配信と柔軟性を提供します。
組織におけるデータストリーミングの活用
データストリーミング技術とアーキテクチャは、組織がリアルタイムで情報に基づいた意思決定を行う能力にとって重要です。スピード、機敏性、応答性はすべて戦略的な利点です。即時のデータ駆動型意思決定は、新しい機会を発見し、運営を最適化し、リスクを軽減し、革新を促進するための競争上の優位性です。データストリーミングは、組織がより賢く、迅速に作業し、機敏な応答性と積極的な意思決定を可能にします。
関連情報
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。