




ポイント: AWS Glue Crawlerは、さまざまなソースからデータの発見、カタログ化、および組織を自動化し、分析の準備を強化します。このガイドでは、クローラーの作成と構成、Amazon S3でのデータ管理、および更新されたデータカタログの生成方法を詳述しています。
- クローラーはS3やJDBCのようなデータソースをスキャンします。
- 重要なステップには、データをアップロードし、クローラーを構成し、出力場所を指定することが含まれます。
このチュートリアルでは、Amazon Web Services (AWS) におけるクローラーとは何かを説明し、独自のAmazon Glueクローラーを作成する方法を示します。
Amazonの完全管理サービスであるAWS Glueは、データ操作を処理し、データを準備して分析活動のために読み込むためのETL (抽出、変換、ロード)を扱います。GlueはS3、DynamoDB、およびJDBCデータソースをクロールできます。
クローラーとは何ですか?
クローラーは、自動化されたソフトウェアアプリで、ウェブページのコンテンツを「クロール」し、これらのページのリンクを辿って追加のページを見つけてクロールします。時にはスパイダーやボットとも呼ばれるこれらのソフトウェアプログラムは、目的を持ってクロールします。ウェブページをクロールしてコンテンツをスキャンし、検索エンジン用にインデックスを作成したり、コンテンツ集約のために大規模なデータセットを抽出したり、トレンドを特定したり、感情分析を実施したり、機能セットや価格を監視したりすることがあります。インターネットアーカイブサイトは、将来の参照のためにウェブページの歴史的記録を作成するためにクローラーを使用します。クローラーはリンクチェックやSEO監査にも役立ちます。
AWS Glueクローラーとは何ですか?
AWS Glueクローラーは、さまざまなソースからスクレイピングされたデータを発見、カタログ化、および整理する方法を自動化するAmazonのツールです。たとえば、AWS Glueクローラーは、Amazon Simple Storage Service (S3) のリレーショナルデータベースや、DynamoDB、JDBC、MongoDBなどの他のデータソースをクロールするために使用できます。
Amazon Glueクローラーは、データの構造やスキーマの変化を検出するためにデータをスキャンしてカタログ化します。更新されたデータカタログを作成し、高速処理と分析のための抽出、変換、ロード (ETL) 操作を実行できます。また、AWS分析サービスと統合されています。AWS Glueクローラーは、Amazon S3バケット(大規模なファイルとデータ用のスケーラブル、安全、耐久性のあるストレージコンテナ)およびそれに付随するメタデータをポピュレートします。
AWSクラウドデータベースの革新についてもっと学びましょう。
AWS Glueのアーキテクチャとワークフローを理解する
AWS Glueのアーキテクチャとワークフローは、データストアに接続してクロールすることから始まります。これは、Amazon S3のようなバケットや、Amazon RDS、Amazon Redshift、Amazon DynamoDB、またはJDBCのようなデータベースである可能性があります。
次に、AWS Glueは分類子を使用してデータの構造と形式を決定します。分類子は、Glueデータタイプ、スキーマ、ファイル形式、およびさまざまなタイプのメタデータを特定するルールのセットです。
最後に、AWS Glueはメタデータをデータカタログと呼ばれる中央リポジトリに書き込みます。これには、データのソース、データスキーマ、およびその他のデータ記述に関する情報が含まれています。
AWS Glueでクローラーを作成する方法
Amazon Glueクローラーの主要コンポーネント(アーキテクチャ、データストア、データカタログ、および各コンポーネント間の相互作用)を理解したので、AWS Glueでクローラーを作成する方法について説明します。
1. サンプルJSONデータをダウンロードする
サンプルデータが必要です。Glueでデータを結合する方法を示したいので、共通の要素を持つ2つのデータセットが必要です。
AWS Glueクローラーの例では、IMDBのデータを使用しています。私たちは、そのデータの小さなサブセット(24レコード)を選択し、JSON形式に変換しました。(具体的には、DynamoDBにロードできるようにフォーマットされています。これは後で行います。)
1つのファイルには映画やテレビシリーズの説明があります。もう1つにはそのシリーズや映画の評価があります。データが2つのファイルにあるため、タイトルごとの評価を得るためにそのデータを結合する必要があります。Glueはそれを行うことができます。
これら2つのJSONデータファイルをダウンロードしてください:
2. データをAmazon S3にアップロードする
Amazon AWSコマンドラインクライアントを使用して、これらのバケットをS3に作成します。(コンピュータにプライベートキーとシークレットを保存するためにaws configureを実行することを忘れないでください。これにより、Amazon AWSにアクセスできます。)
ここでは、movieswalkerの中にtitlesとratingというバケットを作成します。これを行う理由は、Glueがそのデータを別々のバケットに入れると、別々のテーブルスキーマを作成するからです。
(あなたのトップレベルバケット名は、Amazon全体で一意である必要があります。これは、バケットをURLで参照するためのAmazonの要件です。2人の顧客が同じURLを持つことはできません。)
    aws s3 mb s3://movieswalker

aws s3 mb s3://movieswalker/titles

aws s3 mb s3://movieswalker/ratings
次に、タイトルbasicsとratingsファイルをそれぞれのバケットにコピーします。
    aws s3 cp 100.basics.json s3://movieswalker/titles

aws s3 cp 100.ratings.tsv.json s3://movieswalker/ratings
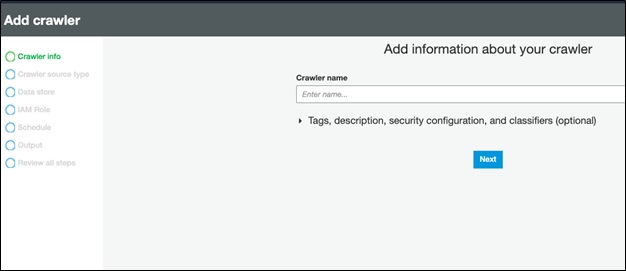
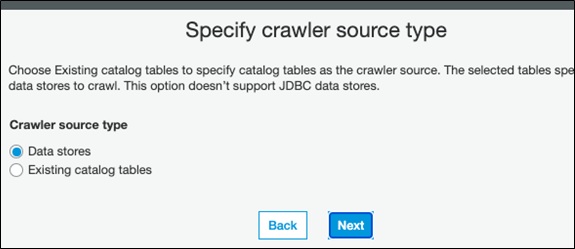
次に、データストアを選択します。より良い名前はデータソースでしょう。なぜなら、そこからデータを引き出してGlueに保存しているからです。
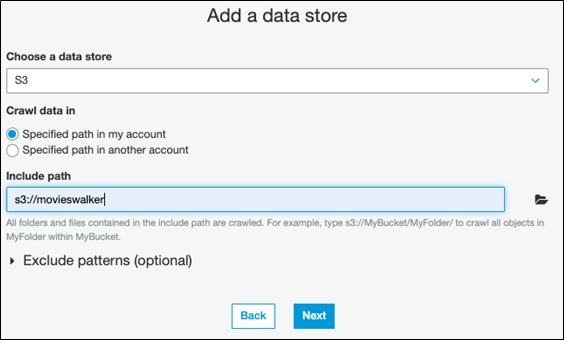
次に、上で作成したトップレベルのmovieswalkerフォルダを選択します。
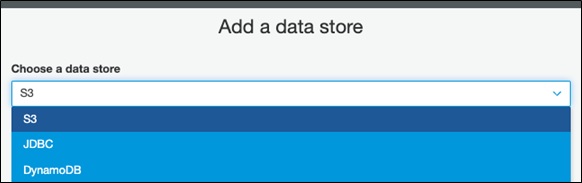
データストアはS3、DynamoDB、またはJDBCであることができます。
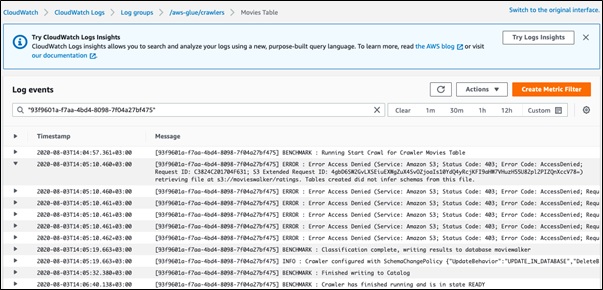
次に、クローラーを開始します。完了したら、ログを確認できます。
このエラーが発生した場合は、S3ポリシーエラーです。このチュートリアルの目的でテーブルを公開にすることができますが、IAMポリシーを掘り下げたくない場合は、これを行っても構いません。この場合、Amazonのルートユーザーとしてファイルをアップロードしたため、IAMで作成したユーザーを使用してアクセスしようとしたときにこのエラーが発生しました。
ERROR : Error Access Denied (Service: Amazon S3; Status Code: 403; Error Code: AccessDenied; Request ID: 16BA170244C85551; S3 Extended Request ID: y/JBUpMqsdtf/vnugyFZp8k/DK2cr2hldoXP2JY19NkD39xiTEFp/R8M+UkdO5X1SjrYXuJOnXA=) retrieving file at s3://movieswalker/100.basics.json. Tables created did not infer schemas from this file.
クローラーログを表示します。ここでプロセスの各ステップを見ることができます。
4. AWS Glueで作成されたテーブルを表示する
ここにGlueで作成されたテーブルがあります。
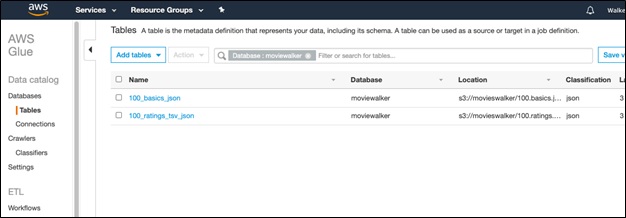
それらをクリックすると、スキーマを見ることができます。
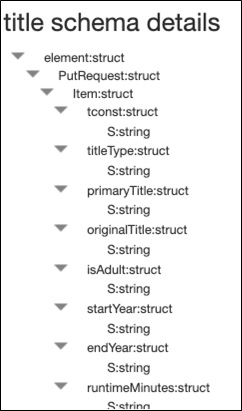
これにはこれらのプロパティがあります。注目すべき点は、データがHive形式で保存されていることです。つまり、Hadoopを使用して保存されている必要があります。
AWS Glueクローラーのチュートリアル:重要なステップの要約
- データをAmazon S3にアップロードします。
- 正しいアクセス許可を持つクローラーを作成および構成し、データソースとパスを特定します。
- クローラーがデータ構造を解釈するために使用する分類子を構成します。
- データカタログの出力場所を指定します。これで、クローラーをトリガーして実行する準備が整いました。
AWS Glueを使用すると、データの発見、クエリ、および処理を自動化するのに非常に役立ちます。他のAWS管理ツールについてもっと学ぶには、ブログAWS Management Toolsをご覧ください。
AWS Glueガイド
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。