




ポイント: サイト信頼性エンジニアリング(SRE)は、ソフトウェアエンジニアリングをITオペレーションと統合し、スケーラブルで信頼性のあるシステムを確保し、効率のための自動化を強調します。Googleに由来するSREは、高いサービス可用性をターゲットとし、サービスレベル目標(SLO)などのメトリックを使用してパフォーマンスを評価します。
- SREは99.99%の可用性を目指し、革新とリスクのバランスを取ります。
- コア原則には、労力を減らすこと、効果的な監視、そして自動化が含まれます。
クラウドはデジタル時代におけるソフトウェアの実行モードとして本当にデフォルトになりつつあります。そして、ビジネスニーズの変化に応じてアプリケーションのパフォーマンスと安定性を管理する際、SREのような現代的なアプローチが急速に根付いています。Googleによって導入されたSREは、ハイブリッドクラウド環境でホストされるアプリケーションの効果的な管理に必要な能力として、世界中で急速に関心を集めています。実際、LinkedInの2020年の新興職業レポートでは、SREが5位にランクインし、DevOps Instituteの2021年のスキルのアップスキリングレポートでは、SREの運用モデルの採用が15%から21%に増加したことが示されています。
この記事ではSREが何であるかを見ていきましょう。
サイト信頼性エンジニアリングとは何ですか?
サイト信頼性エンジニアリングの略であるSREは、ソフトウェアエンジニアリングの側面をITオペレーションに適用する学問であり、超スケーラブルで非常に信頼性の高いソフトウェアシステムを作成することを目的としています。SREはGoogleから生まれたサービス管理へのアプローチです。ベン・トレイナーは、Googleの技術オペレーションを監督する上級VPであり、サイト信頼性エンジニアリングという用語の創始者であり、次の有名な引用を残しています:
「SREは、ソフトウェアエンジニアにオペレーションチームを設計させたときに起こることです。」
2003年、ソフトウェアエンジニアリングのバックグラウンドを持つトレイナーは、SREのブループリントとなる「プロダクションチーム」を設立しました。このチームは主に2つの特徴に基づいています:
- オペレーションチームが行う作業を行うためにソフトウェア開発のバックグラウンドを持つエンジニアを使用すること。
- これらのエンジニアに、以前手動で行われていた作業を自動化させることを期待すること。
チケット処理やエスカレーション対応などのいくつかの手動オペレーションタスクを続けつつも、SREチームは主にアプリケーションとプロダクション環境システムを自動化し、スケーリングすることで新しい製品やサービスのエンジニアリングに焦点を当てることが期待されています。これは、サービスの使用が増加するにつれて、運用負荷を管理するための努力も増加するためです。自動化は運用オーバーヘッドを削減し、新しい機能や既存アプリケーションの改善を支援するために適用できる余分な帯域幅を生み出します。ソフトウェアエンジニアをSREとして持つもう一つの利点は、運用の安定性に焦点を当てているにもかかわらず、彼らが製品開発チームの視点を理解しているため、引き渡しの摩擦を減らすことです。(SREとITOpsをさらに詳しく比較します。)
SREはどのように機能しますか?
用語信頼性はSREの中心にあります。ITIL® 4 Foundation Publicationは、信頼性を次のように定義しています:
「製品、サービス、またはその他の構成要素が、指定された時間またはサイクル数にわたってその意図された機能を実行する能力。」
これを達成するために、SREチームは各サービスのこれらのコンポーネントに責任を持たなければなりません:
- 可用性
- レイテンシ
- パフォーマンス
- 効率
- 変更管理
- 監視
- 緊急対応
- キャパシティプランニング
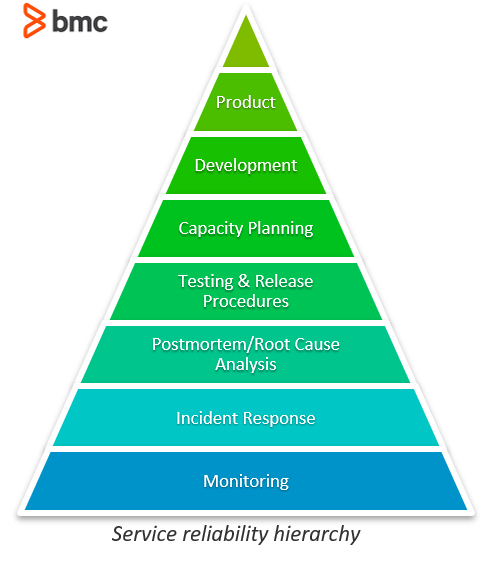
既存のサービスが期待通りに機能することを確保することに強い焦点を維持しながら、SREの優先順位は、サービスを運営することです。簡単に言えば、SREはサービスを運営し、これらのサービスの健康に最終的に責任を持っています。SREの日常活動は、大規模な分散コンピューティングシステムの構築と運営を含みます。以下の階層が示すように、サービスを信頼性のあるものにするための基本的な実践は:
- 既存のサービスを監視し、発生する問題に対処することをサポートします。
- 次に、スケーリングを構築します。
- 最後に、新しい製品機能の開発をサポートします。
Googleでは、サービスを安定させ、運用可能にするためのSRE活動に50%の上限が設けられています。これは、システム管理者の時間の80-90%に近い焦点を置く他のサービス管理アプローチとは対照的です。SREは、負荷を軽減し、運用の効率と効果を向上させるための自動化ツールやその他の努力を設計および展開するために、残りの50%の時間をコーディングに費やすことが期待されています。ユーザーや製品チームと協力することで、SREは、スケーラビリティや障害時の優雅な劣化、他のサービスやシステムとの統合、追加の利点を特色とするより良いプロダクション環境を生み出す革新的な自動化ツールを開発することができます。
- スケーラビリティ
- 障害時の優雅な劣化
- 他のサービスやシステムとの統合
- 追加の利点
SREの原則
組織でSREを採用するには、これらの原則を目指す必要があります:
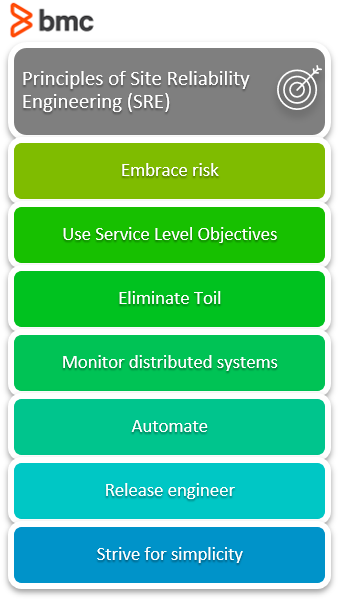
リスクを受け入れる
SREは100%信頼性の高いサービスを信じていません。代わりに、ビジネスが受け入れるリスクに基づいて、十分に信頼性のあるサービスを目指します。99.99%の可用性を目指し、SREは利用不可のリスクと迅速な革新および効率的なサービス運営の目標とのバランスを取ることを求め、ユーザーの全体的な幸福を最適化します。
サービスレベル目標を使用する
ユーザーのニーズを満たすサービスを理解し、提供するために、サービスレベル目標(SLO)が使用されます。SLOは、サービスレベル指標(SLI)によって測定されるサービスレベルの目標値または範囲です:
- 可用性
- エラーレート
- リクエストレイテンシ
- スループット
- 他の指標
SLOの構造は次のいずれかです:
- SLI ≤ 目標
- 下限 ≤ SLI ≤ 上限
SLOを選択し、ユーザーに公開することで、サービスのパフォーマンスに関する期待を設定し、サービスパフォーマンスに関するサービス所有者への根拠のない苦情を減らすのに役立ちます(例: 遅延)。(エラーバジェットを探る、これはSREおよび非SRE環境で機能するツールです。)
労力を排除する
労力とは、プロダクションサービスの運用に関連する手動、繰り返し可能、自動化可能、戦術的、持続的な価値がない活動であり、サービスが成長するにつれて線形にスケールするものです。労力の源は次のとおりです:
- 中断(緊急でないサービス関連のメッセージやメール)
- オンコール(緊急)対応
- リリース
- プッシュ
労力を削減し、サービスをスケールアップする作業は、SREの「エンジニアリング」部分です。すべての労力が悪いわけではありませんが、あまりにも多くの労力は危険であるため、それを排除するための自動化ソリューションを考案する必要があります。
分散システムの監視
監視はSREの重要な属性であり、壊れているもの(または壊れる可能性のあるもの)とその理由を見つけることを目的としています。システムが自己修復できない場合、SREはアラートを調査し、問題を特定して緩和し、根本原因を特定する必要があります。SREの監視がカバーする優先メトリックは:
- レイテンシ
- トラフィック
- エラー
- 飽和
自動化
自動化は、SREの存在理由であり、特に手動活動を自動化された活動に置き換えられる場合や、自動化の必要が自律的なシステムを設計することで排除される場合です。自動化の利点は:
- 一貫性
- 時間の節約
- 迅速な修理とアクション
- 他のサービスに拡張可能なプラットフォームの提供
SREはシステムインフラストラクチャのライフサイクル管理のためにコードを書くが、そのデータの管理のためではありません。
リリースエンジニアリング
SREは、開発者およびリリースエンジニアをサポートし、新しいサービスや機能が適切に動作し、将来的にサポートできることを保証します。SREは、リリースエンジニアによって開発されたツールを使用し、プロジェクトが一貫した再現可能な方法論を使用してリリースされることを保証します。彼らは次のための戦略を共同で開発します:
- カナリア変更
- サービスを中断せずに新しいリリースをプッシュする
- 問題を示す機能をロールバックする
シンプルさ
SREのシステム管理アプローチは、システムにおける機敏性と安定性のバランスを保つことです。SREは、開発者の機敏性にほとんど影響を与えずに、ソフトウェアをより信頼性のあるものにする手続き、慣行、ツールを作成するために取り組みます。SREチームは、責任を持つシステムに偶発的な複雑さが導入されると反発し、自分たちがオンボードするシステムの複雑さを排除し、運用責任を引き受けることを常に目指します。
SREはアジャイルな操作と開発をサポートします
システムがますます複雑になる中、何らかの失敗は避けられません。SREが完璧を要求しないため、失敗が発生したときにサービスの信頼性をサポートする方法を見つけることができます。「人工知能による運用(AIOps)およびサービス管理(AISM)機能を使用して、トップSREタレントを惹きつけ、彼らを組織で成功させるために必要な能力を洞察する。」

これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。