




ポイント: システムの信頼性と可用性の計算は、ITパフォーマンスを評価するために不可欠であり、信頼性は時間にわたる正しい操作の確率を示し、可用性は特定の瞬間でのパフォーマンスを測定します。主要な指標には、平均故障時間(MTTF)、平均故障間隔(MTBF)、および平均修復時間(MTTR)が含まれ、システムの信頼性を評価するために重要です。
- 直列構成では信頼性が減少し、並列構成では可用性が増加します。
- 効果的な計算はコンポーネント構成と冗長モデルに依存します。
すべての規模の企業にとってビジネスの必須条件であるクラウドコンピューティングは、企業が使用ベースのサブスクリプションモデルでITサービスを消費することを可能にします。システムの信頼性を評価するために、クラウドコンピューティングの約束は、2つの重要な指標に依存しています:
- サービスの信頼性
- サービスの可用性
ベンダーは特定の信頼性と可用性の基準を満たすために、サービスレベルアグリーメント(SLA)を提供します。SLAの違反は、ベンダーにコストの罰則を課すだけでなく、クラウドネットワーク上で実行されるアプリやソリューションのエンドユーザーエクスペリエンスも損ないます。
信頼性と可用性はしばしば同じ意味で使われますが、エンジニアリング分野では異なる概念です。信頼性と可用性の違いを探り、次にそれぞれがどのように計算されるかを見ていきましょう。
信頼性とは?
信頼性とは、特定の時間の間にシステムが正しく機能する確率です。この正しい操作の間:
- 修理は必要ない、または行われない
- システムは定義された性能仕様を適切に遵守する
信頼性は指数的な故障法則に従い、信頼性計算のための時間が経過するにつれて減少します。言い換えれば、システムの信頼性は運用の初期状態では高く、時間とともに徐々に最も低いレベルに減少します。
[helix-video]
可用性とは?
可用性は、特定の時間の瞬間にシステムが正しく機能する確率を指します(期間ではなく)。システムの可用性が計算される時間の前後に中断が発生する可能性があります。サービスは:
- 稼働している
- 使用時に定義された仕様を十分に満たす
可用性は、予測された使用期間中にサービスを利用できなくさせる可能性のあるダウンタイムのインシデントを考慮して、その定常状態で測定されます。たとえば、99.999%(Five-9s)の可用性は、年間5分15秒のダウンタイムを指します。
(可用性の指標と9の可用性についてもっと学びましょう。)
インシデントとサービスの指標
信頼性と可用性がどのように計算されるかを議論する前に、これらの計算で使用されるインシデントサービスの指標を理解しましょう。これらの指標は、広範な実験、経験、または業界標準を通じて計算されます;直接観察されるものではありません。したがって、結果の計算は、システムの信頼性と可用性について相対的に正確な理解を提供します。
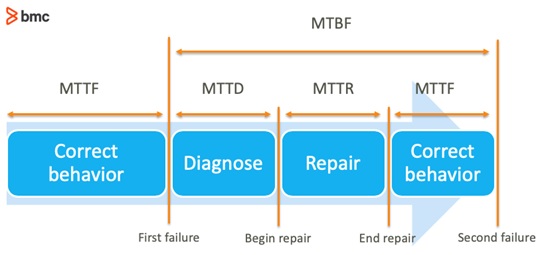
以下のグラフィックと次のセクションでは、最も関連性の高いインシデントとサービスの指標を概説します:
故障率
単位時間あたりのコンポーネント故障の頻度。通常、ギリシャ文字のλ(ラムダ)で示され、この記事の後半で指定される指標を計算するために使用されます。信頼性工学の計算では、故障率は、コンポーネントが初期状態で完全に稼働していることを前提として、予測された故障強度と見なされます。修理可能および非修理可能システムの場合の公式は次のようになります:
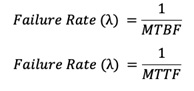
修理率
失敗したコンポーネントに対して実施された成功した修理作業の頻度。通常、ギリシャ文字のμ(ミュー)で示され、この記事の後半で指定される指標を計算するために使用されます。修理率は数学的に次のように定義されます:
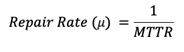
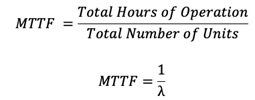
平均故障時間(MTTF)
修理不可能なシステムコンポーネントが故障するまでの平均時間。以下の公式がMTTFを計算します:
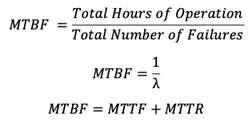
平均故障間隔(MTBF)
修理可能なシステムコンポーネントの固有の故障間隔の平均時間。以下の公式がMTBFを計算するために使用されます:
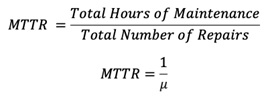
平均修復時間(MTTR)
故障したコンポーネントを修理して運用状態に戻すための平均時間。この指標には、修理活動が開始される前のアラートおよび診断プロセス中に費やされた時間が含まれます。(修理プロセスにのみ費やされた平均時間は平均修理時間と呼ばれます。)
平均検出時間(MTTD)
コンポーネント故障の発生とその検出の間の経過平均時間。
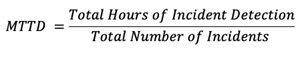
信頼性および可用性の計算
以下の計算は、個々のコンポーネントの信頼性および可用性の属性について計算されます。故障率は、前述の計算に従ってMTTFおよびMTBFと同じ意味で使用することができます。
- 信頼性は、故障率に依存する指数的に減衰する確率関数として計算されます。故障率はコンポーネントの運用ライフサイクルの間に一定ではない可能性があるため、MTTFやMTBFなどの平均時間ベースの量を使用して信頼性を計算することもできます。数学的関数は次のように指定されます:
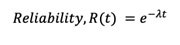
- 可用性は、故障と回復の間の時間の間、コンポーネントの瞬時のパフォーマンスを決定します。可用性は次の公式を使用して計算されます:
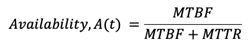
複数コンポーネントシステムの計算
ITシステムは、複雑なアーキテクチャとして接続された複数のコンポーネントを含みます。システムの効果的な信頼性と可用性は、個々のコンポーネントの仕様、ネットワーク構成、および冗長モデルに依存します。構成は直列、並列、またはシステムコンポーネント間の直列と並列接続のハイブリッドである可能性があります。冗長モデルは内部システムコンポーネントの故障を考慮することができ、したがって効果的なシステムの信頼性と可用性パフォーマンスを変更します。
個々のコンポーネント間の相互接続を示すために信頼性ブロック図(RBD)を使用することができます。あるいは、分析方法を使用して、大規模で複雑なネットワークの計算を行うこともできます。システムコンポーネント間の直列と並列接続のハイブリッドのRBDが提供されています:
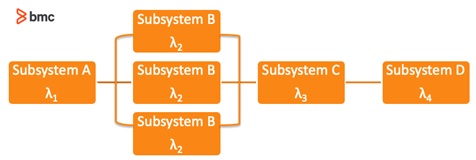
RBD手法の基本が以下に示されています。
故障率の使用
効果的な故障率を使用して、次の公式を使用してシステムの信頼性と可用性を計算します:
- 直列接続されたコンポーネントの場合、効果的な故障率は各コンポーネントの故障率の合計として決定されます。
- Nの直列接続されたコンポーネントの場合:

- 並列接続されたコンポーネントの場合、MTTFは各システムコンポーネントの故障率の逆数の合計として決定されます。
- Nの並列接続されたコンポーネントの場合:
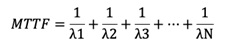
- ハイブリッドシステムの場合、接続はまず直列または並列構成に減少される可能性があります。
可用性と信頼性の仕様の使用
各コンポーネントの信頼性と可用性を個別に計算します。
- 直列接続されたコンポーネントの場合、すべてのコンポーネント値の積を計算します。
- Nの直列接続されたコンポーネントの場合。
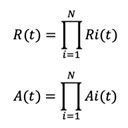
- 並列接続されたコンポーネントの場合、次の公式を使用します:
- Nの並列接続されたコンポーネントの場合。
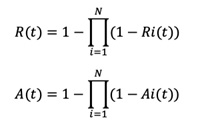
- ハイブリッド接続されたコンポーネントの場合、まず計算を直列または並列構成に減少させます。
直列接続されたコンポーネントのネットワークの信頼性と可用性は、個々のコンポーネントの仕様よりも低くなることが観察できます。たとえば、99%の可用性を持つ2つのコンポーネントが直列に接続され、98.01%の可用性が得られます。逆に、並列接続モデルでは、1つのコンポーネントが99%の可用性仕様を持つ場合、2つのコンポーネントが並列に組み合わさり、99.99%の可用性を得ます;4つのコンポーネントが並列接続されると99.9999%の可用性が得られます。ネットワークに冗長コンポーネントを追加すると、信頼性と可用性のパフォーマンスがさらに向上します。
これらのインシデント指標と関連する信頼性および可用性の計算に関して、いくつかの注意点を述べることが重要です。
- これらの指標は相対的な観点で捉えられる可能性があります。故障は、異なるアプリケーション、ユースケース、組織において同じコンポーネントに対して異なって定義される場合があります。
- MTTF、MTTR、MTBF、MTTDなどの指標の値は、制御されたまたは特定の環境下での実験で観察された平均です。これらの測定値は、実世界のアプリケーションでは一貫して保持されない可能性があります。
したがって、組織はシステムの信頼性と可用性の計算をビジネス価値およびエンドユーザーエクスペリエンスにマッピングする必要があります。意思決定には、コスト、パフォーマンス、セキュリティとの戦略的トレードオフが必要になる場合があり、意思決定者はIT部門が従うシステムの信頼性指標や仕様を超えて質問をする必要があります。
追加リソース
この記事で説明されているシステムの信頼性と可用性の計算に参照された文献は以下の通りです:
関連する読書
これらの投稿は私自身の見解であり、必ずしもBMCの立場、戦略、または意見を表すものではありません。