




ポイント: scikit-learnは、統計関数とアルゴリズムを強調した強力なPythonライブラリです。このガイドでは、Anacondaを介したインストールと、完全に相関したデータを使用した単純な線形回帰の例を示します。
- condaを介したscikit-learnのインストール手順。
- 完全に相関したデータを使用した線形回帰の例。
- matplotlibを使用した結果の視覚化。
ここでは別の機械学習フレームワークであるscikit-learnを探求し、グラフを描画するためにmatplotlibの使用方法を示します。scikit-learnの公式サイトをチェックしてください。
scikit-learnのPython ML APIはApache Sparkよりも前から存在しており、TensorFlowよりも長く使われてきました。これは、ビッグデータよりも前から存在していることを意味します。純粋なデータサイエンティストとして自分を見ている人々によって長い間使用されてきましたが、データエンジニアとは異なります。それでも、scikit-learnをSparkに接続して、クラスタのマシン全体で実行できる変換や計算を行うことができます。それがなければ、単一のマシンのメモリ、CPU速度、ディスクスペースに収まるデータセットのみを扱うことができます。
scikit-learnは統計関数が非常に強力で、ほぼすべてのアルゴリズムが詰め込まれており、学者や数学者だけが理解できるものや、適用された機械学習であるニューラルネットワークも含まれています。しかし、製品を始めるために数学者である必要はありません。ここでは、最も単純な例をコーディングする方法を示します。
環境
condaを使用してPythonをセットアップし、パッケージをインストールする必要があります。これにより、sckit-learnをZeppelin Notebooksに簡単に統合できます。そうでなければ、ZeppelinにPythonパッケージを追加するのは難しいです。
この例をPythonコマンドラインから実行できますが、Zeppelinはグラフィカルなので、matplotlibで美しいグラフを描画できます。
Zeppelinをインストールする際は、すべてのインタプリタをインストールしてPython、Spark、matplotlibなどが揃っていることを確認してください。Zeppelinに不慣れな場合は、こちらの例を参照して、その理解を深めてください。
Anacondaをインストールし、次のコマンドを入力してscikit-learnをインストールします:
例
conda install scikit-learn
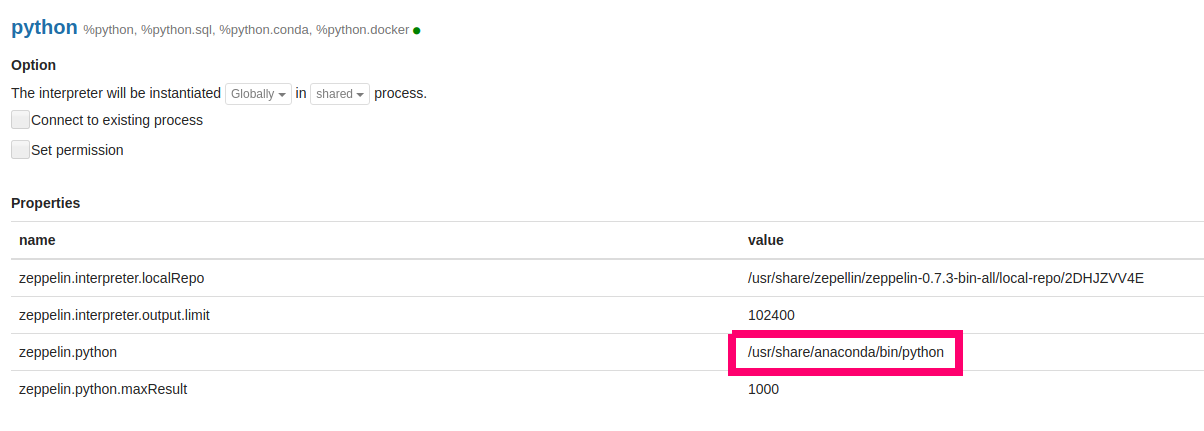
次に、ZeppelinでPythonインタプリタをAnacondaのPythonにポイントします:
最も単純な例を行います。これは1つの独立変数と1つの従属変数を持つ線形回帰です。そして、データが完全に相関しているようにデータをセットアップします。つまり、分散は1です。別の言い方をすれば、LRの目標は、係数mとy切片bを見つけることでこの直線の方程式を解くことです。
y = mx + b
しかし、ここでの目標はscikit-learnの使用方法を示すことだけです。したがって、y = 2x + 0 = 2xを使用してデータをモックします。(より現実的な例を希望する場合は、標準正規分布を使用し、その中からランダムノイズファクターを引き出し、それをyに加えることができます。)
この例のコードはここにZeppelinノートブックとして保存されています。以下に、コードをセクションごとに示します。セクションをZeppelinノートブックのZeppelin段落に貼り付けることができます。ノートブックを作成する際は、pythonインタプリタを選択することを忘れないでください。
    import matplotlib.pyplot as plt
from sklearn import linear_model
import numpy as np
from sklearn.metrics import mean_squared_error, r2_score
最初に、LinearRegressionモデルをインスタンス化します。
reg = linear_model.LinearRegression()
次に、配列を作成します。左側には独立変数1,2,3があります。右側には従属変数2,4,6があります。各従属変数yは、それぞれの独立変数xの2倍であることがわかります。すなわち、y=2xです。
scikit-learnはnumpy配列を使用することを期待しています。
    ar = np.array([[[1],[2],[3]], [[2],[4],[6]]])
ar
結果。各結果を印刷すると、視覚化し理解するのに役立ちます。
    array([[[1],
        [2],
        [3]],
       [[2],
        [4],
        [6]]])
ここでは、スライスしてy変数だけを取り出します。(配列のスライスと再形成は複雑なトピックです。ここでそのことについて読むことができます。)この配列shape、ar.shapeはこのタプル(2,3,1)で与えられます。これは2つの配列の1つの配列です。したがって、最初の1 x 3配列をyのために第2の位置に取ります:
結果:
    y = ar[1,:]
y
結果:
    array([[2],
       [4],
       [6]])
次に、xのために最初のものを取ります。
結果:
    x = ar[0,:]
x
結果:
    array([[1],
       [2],
       [3]])
現在、独立変数が単純なベクトルxに格納され、従属変数がyに格納されています。機械学習の観点から、1つの特徴と1つのラベルがあると言えます。
次にfit()を実行します。これは最小二乗法を使用してy=mxの線を見つけます。これは傾きmを見つけることであり、y = mxの線の係数mと同じことを意味します。
reg.fit(x,y)
今、線形回帰APIから係数を印刷できます。
print('Coefficients: \n', reg.coef_)
結果は2です。これは、y = 2xの線であることを知っているので期待されるものです。
    Coefficients:
 [[2.]]
次に、同じ方法でテストデータを作成します。4,5,6、そしてyはその2倍です:
結果:
    xTest = np.array([[4],[5],[6]])
xTest
結果:
    array([[4],
       [5],
       [6]])
次に、xのテスト値xTestをpredictメソッドに渡します。それはyの予測の配列を返します。
結果:
    ytest =  np.array([[8],[10],[12]])

preds = reg.predict(xTest)
preds
結果:
    array([[ 8.],
       [10.],
       [12.]])
次に、観測値(ytest)と予測値(preds)の違い、つまり誤差を見てみましょう。もちろん、それはゼロです。
結果:
print("Mean squared error: %.2f" % mean_squared_error(ytest,preds))
結果:
Mean squared error: 0.00
分散は1です。なぜなら、データが完全に相関しているからです。
結果
print("Variance score: %.2f" % r2_score(ytest,preds))
結果
Variance score: 1.00
今、matplotlibを使用してプロットできます:
    plt.scatter(xTest,preds, color='black')
plt.plot(xTest,preds,color='blue', linewidth=3)

plt.show()
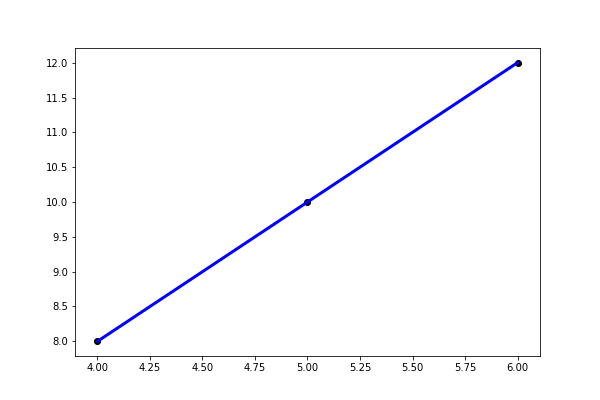
これは、scikit-learn MLライブラリを使用して線形回帰を行う最も単純な例です。
scikit Learn ガイド
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも表しているわけではありません。